Halo: почти год моей работы в White Circle теперь в опенсорсе
Почти год я веду в White Circle разработку
Halo - фреймворка для тренировки LLM, на котором мы учим все свои модели. Внутри он работал давно как замена Мегатрона, но до публичного релиза пришлось догнать transformers, TRL и vLLM, добавить модели и упростить адопшен - образы, CLI, документация. Подробный блогпост - на сайте White Circle (
https://whitecircle.com/research/halo).
Если вы файнтюните открытые модели, то наверняка упирались в: модель уже не лезет в TRL и обычный FSDP, но связываться с Megatron и конвертацией чекпоинтов еще рано или просто не хочется. С MoE все еще хуже, без Expert Parallelism их по большому счету не потренировать. Halo добавляет EP, Context, Tensor и Expert-Tensor Parallelism прямо поверх обычных классов HuggingFace:
на вход HF модель, на выходе HF модель. Новое MoE семейство подключается оберткой меньше 140 строк (у Megatron-Bridge на то же самое уходит 600-1900), сейчас их 15.
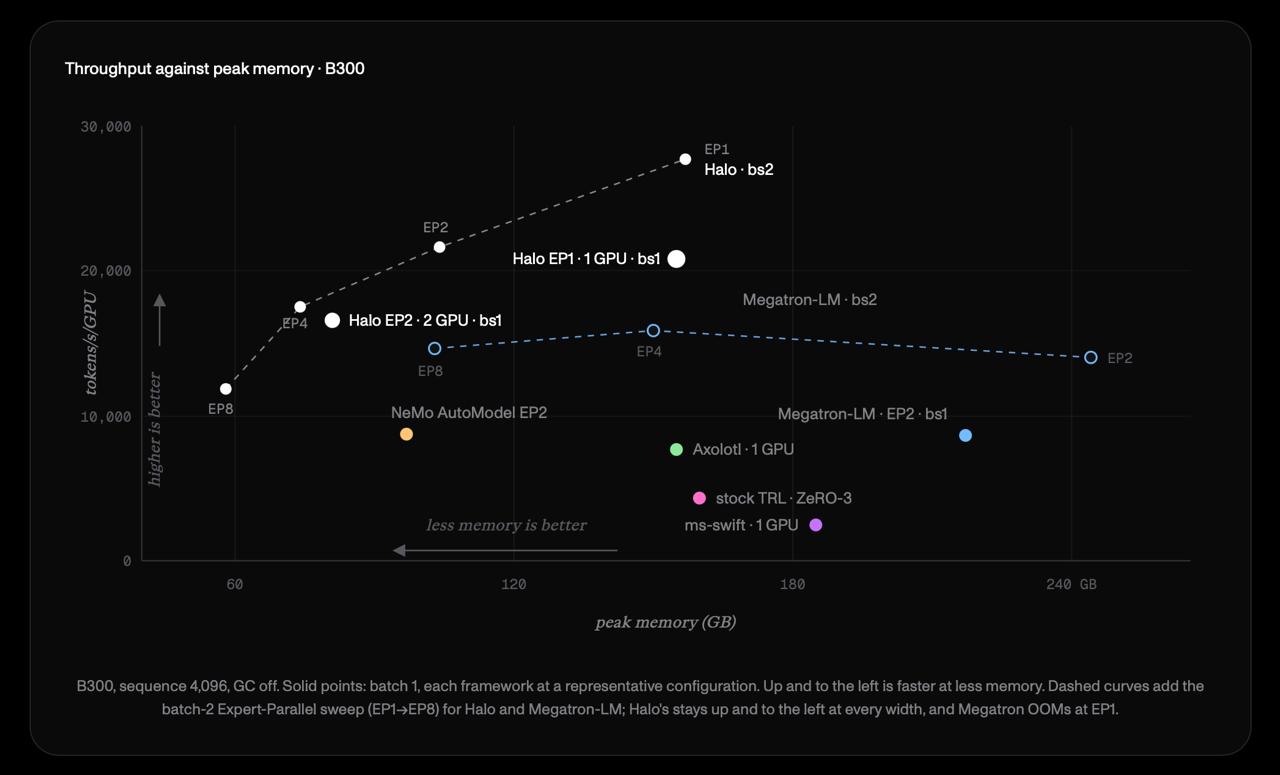
Немного цифр, все на B300,
воспроизводимы из репо:
-
2.3-2.8x throughput относительно стокового TRL на gpt-oss-20b при тех же кернелах, loss совпадает в пределах ~1%.
- Gemma 4 26B-A4B на 2 GPU:
7.2k tok/s против 3.2-5.0k у NeMo AutoModel, Axolotl, Megatron Bridge, MS-SWIFT и Unsloth.
- Оптимизатор целиком в bf16 со стохастическим округлением:
120 GB состояния вместо 240 для 20B.
Все это првоерялось на реальных кластерах B300/B200/H200/H100 а топология заложена
вплоть до NVL72: невалидные раскладки отбрасываются еще на этапе конфига. Запускается через
torchrun,
accelerate или
halo CLI, в репо есть рецепты под SLURM, SkyPilot, RunPod и Nomad. Большая часть года ушла на то, чтобы все это не разваливалось на всех комбинациях моделей и параллелизмов -
тестов в репозитории больше, чем кода. При этом работать будет также и на современных консьюмерских GPU.
Отдельная моя гордость - Async RL. vLLM или SGLang живут в отдельном контейнере, роллауты идут асинхронно через Ray, веса уезжают по NCCL (по EFA
53-80 GB/s, gpt-oss-120b обновляется за
3-4 секунды), а генерации во время синка не обрываются. Внутри routing replay, importance sampling с масками, обучение на токенах, которые насэмплил движок, и 11 встроенных сред - от code contests и SWE до тулов через MCP. По механикам это сопоставимо с verl и Miles, только на HF-моделях и без Megatron.
Для студентов и тех, кто только начинает, Halo, мне кажется, хорошая точка входа. Все запускается из одного docker-образа:
halo launch sft config.yaml, а QLoRA Qwen3-4B занимает
7.9 GB и должна работать на 3090/4090. Документации больше 170 страниц, отдельно советую прочитать лекцию
GPU Training Theory: база того как работают такие фреймворки, почему эксперты в MoE упираются в память, а не в compute, и почему в EP-шаге 88% времени - это all-to-all. Там же честно написано, что не помогает и что тихо ломает, например TF32 по умолчанию в NGC-образе, портящий RoPE после 2048 токенов.
Выложили и модель -
GLM-4.7-Flash-Coder, 30B MoE под агентские скаффолды: SFT на 7.8k успешных траекторий GLM-5.1, на SWE-rebench-V2 pass@1 вырос
с 33.2% до 41.7%, а модель сама научилась вызывать тулы параллельно. Она уже слегка устарела, но как гайд по агентскому SFT актуальна.
Код мы пишем с агентными скаффолдами и сильными моделями вроде Claude Fable и Opus, репозиторий под это спроектирован.
Контрибьт приветствуется, но через фильтр: сначала issue и approve мейнтейнера, потом PR.
Главное правило - понимать свой код: с AI писать можно, но это нужно раскрыть, а тесты должны падать, когда ломается поведение.
Дальше больше: Pipeline Parallelism (все уже в коде, но докатим после полных тестов) и серия блогов про тренировку, например про async RL для code contests. Лицензия Apache 2.0.
P.S. Если помните такую вещь как SMPO из времен Vikhr, то он теперь тоже живет там, но уже с EP и CP и улучшениями.