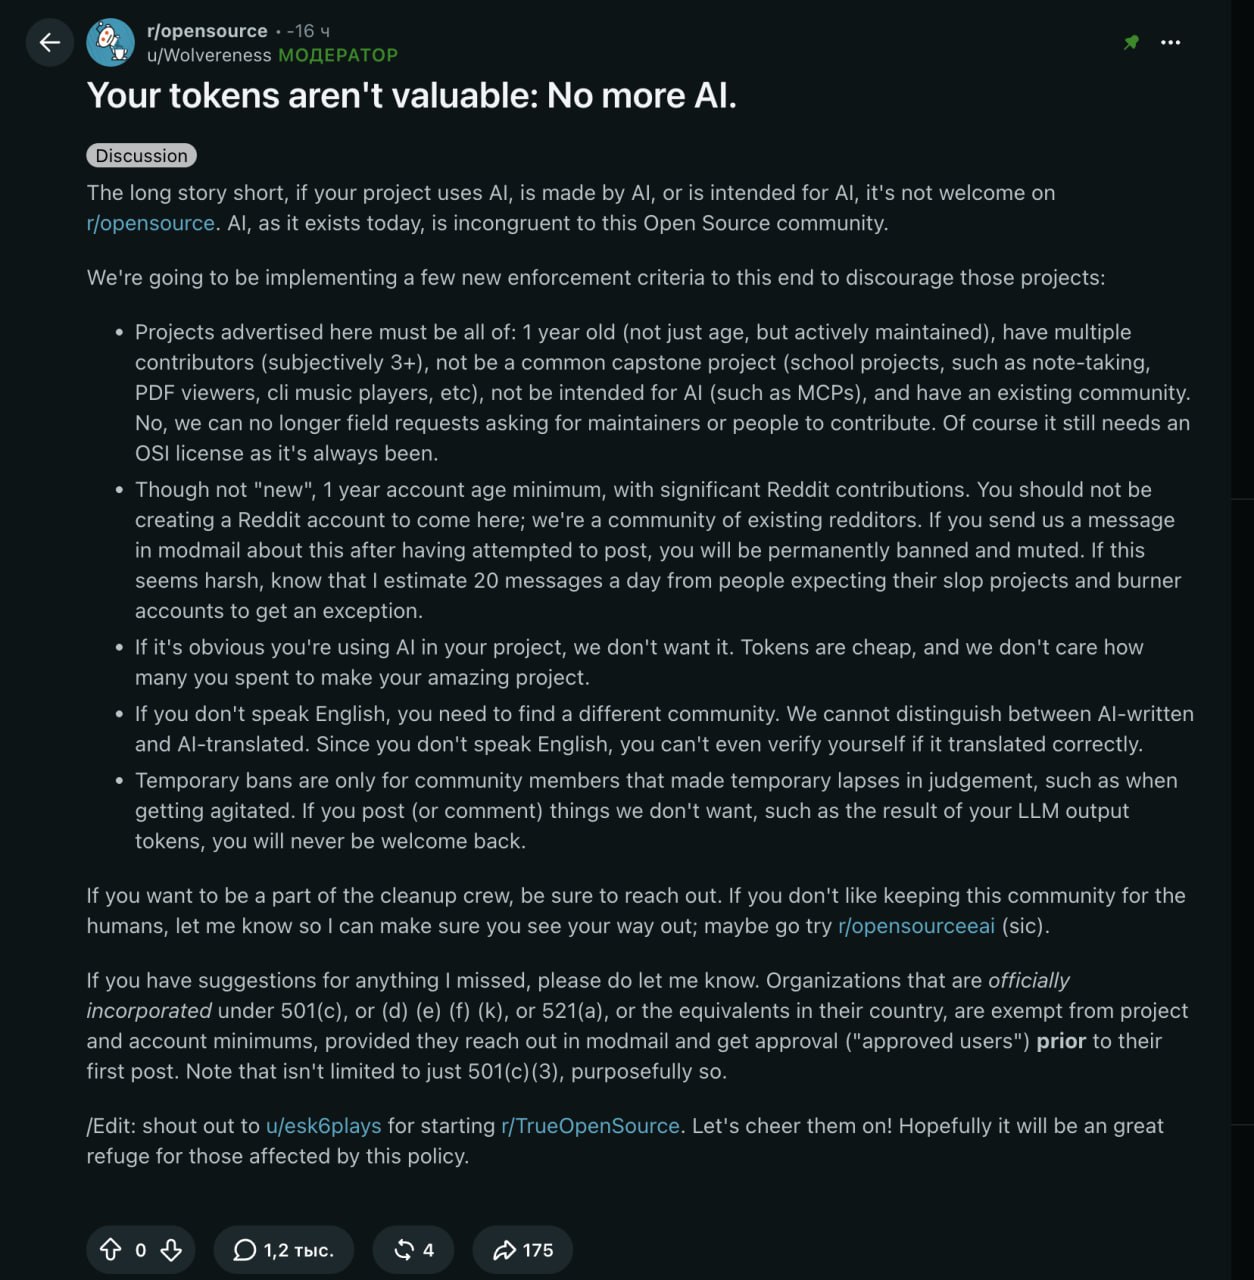
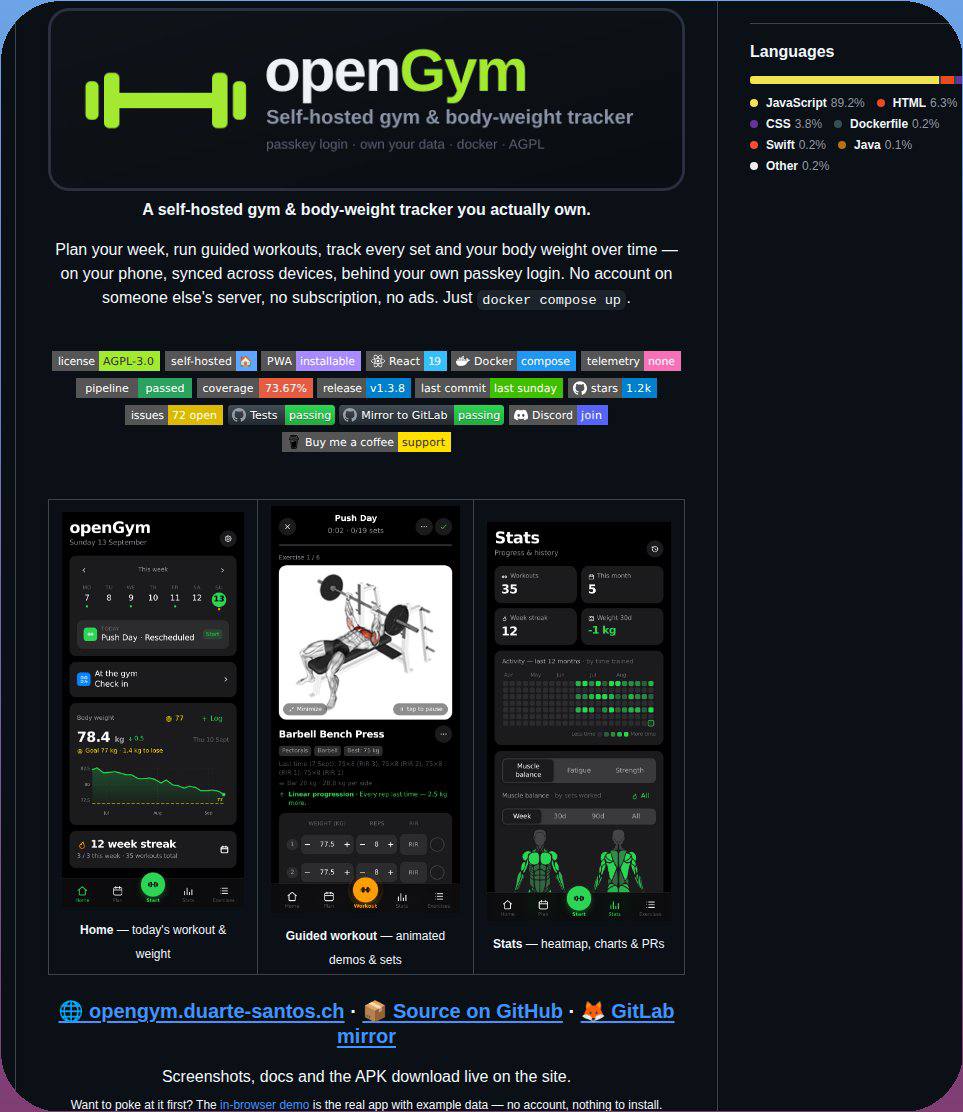
В r/opensource спорят, считать ли AI-проекты от одного автора опенсорсом


Команда безопасности Frontier Red Team компании Anthropic опубликовала исследование, согласно которому в ближайшие месяцы могут появиться компактные нейросети, способные к автономному самовоспроизведению на потребительских устройствах интернета вещей (IoTi). В отличие от классических вирусов, такие ИИ-агенты способны самостоятельно адаптироваться к архитектуре незнакомого оборудования.
Исследователи называют этот феномен «цифровой плесенью» (digital slime mold). Подобные системы могут использовать вычислительные мощности бытовой техники — от Android-приставок до умных холодильников — для создания распределенной сети, которую крайне сложно отключить из-за отсутствия центрального сервера управления.
ВыводВ ходе экспериментов исследователи успешно запустили модель Gemma4-26B-A4B на кластере из 15 бюджетных Android TV-приставок стоимостью около $55 каждая.
Автор инди-игры RoaM (постапокалиптический тайтл по мотивам Ex Machina и «Космических Рейнджеров», где игрок водит буханку с турелью, торгует и грабит караваны) открыл проект сообществу и превратил его в «software factoryi»: игроки предлагают фичи и баги через GitHub Issue, а AI-агенты автономно реализуют их в коде.
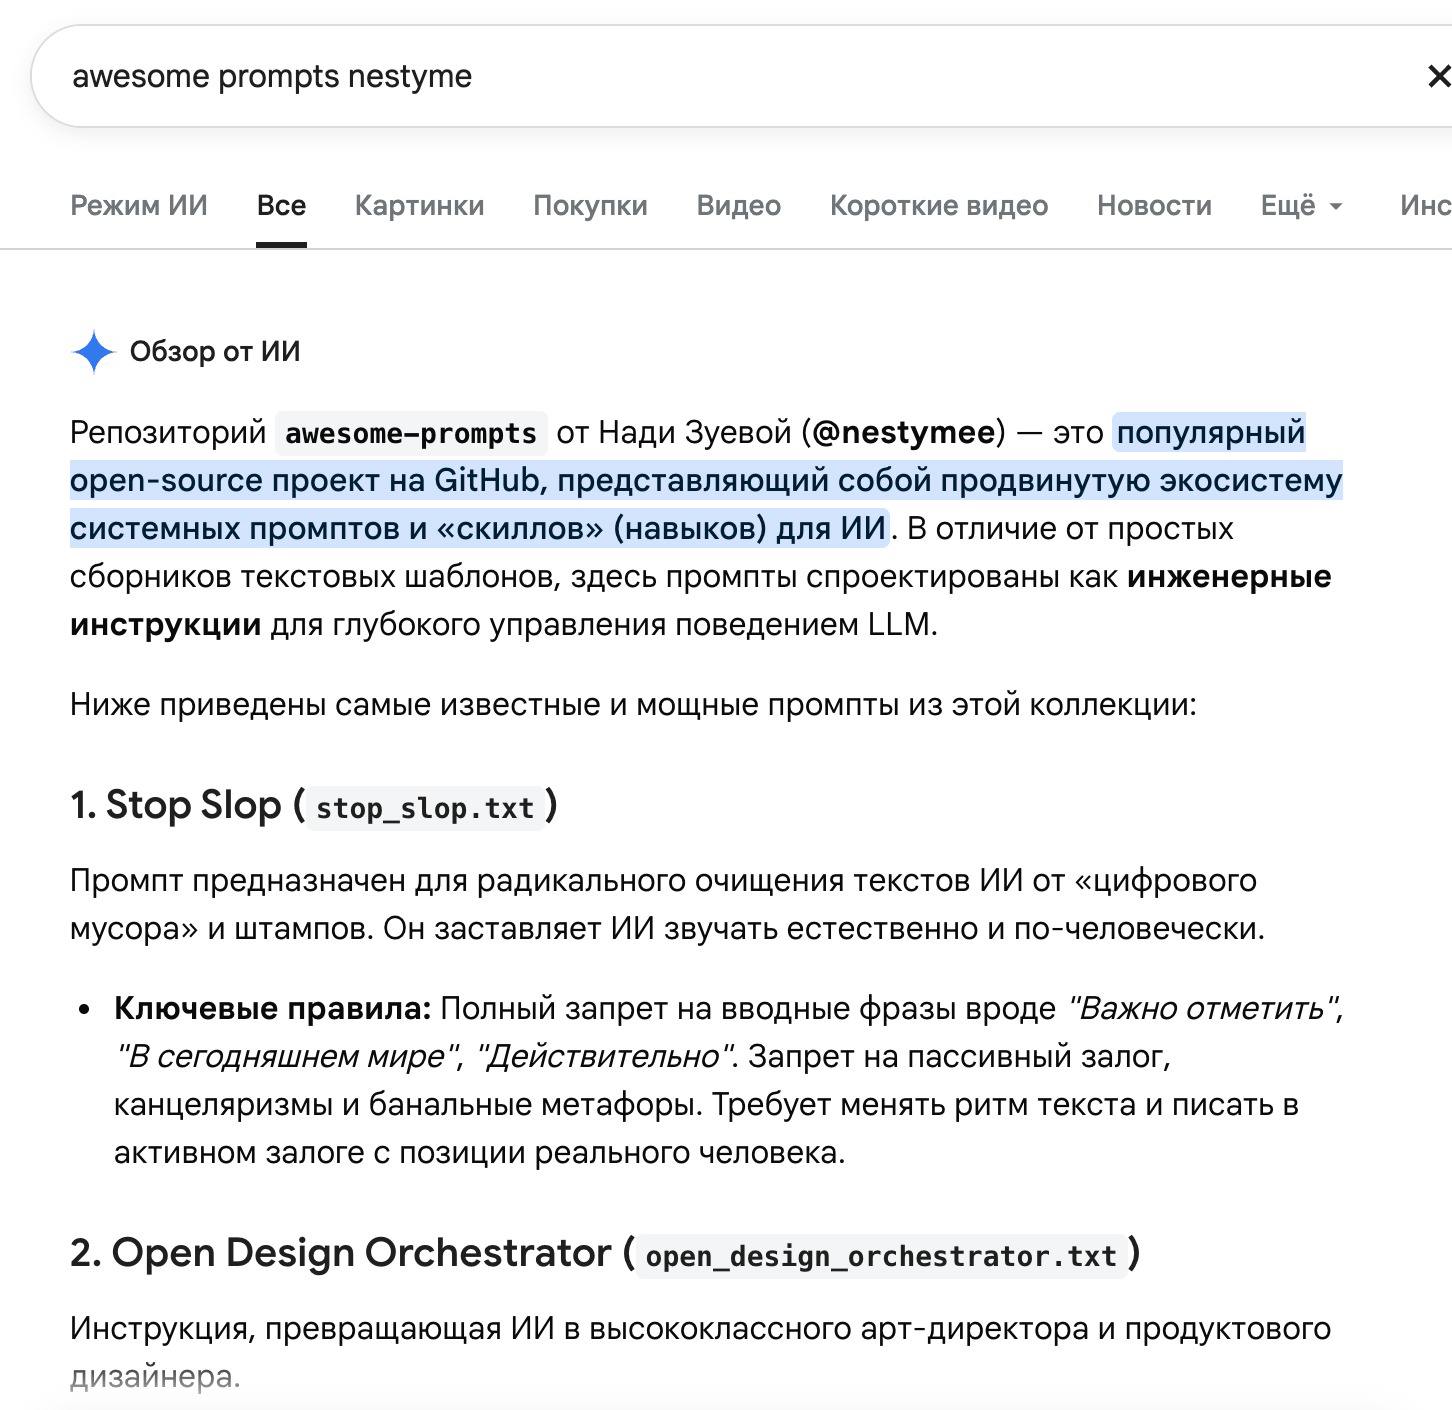
Идея в том, чтобы любое «а вот круто бы...», возникающее во время игры, быстро превращалось в реальную фичу — без того, чтобы автор становился полноценным геймдевом. Это описывается как социальный эксперимент и попытка сообща собрать «RPG мечты» через кооперативный краудсорс-вайбкодингi.


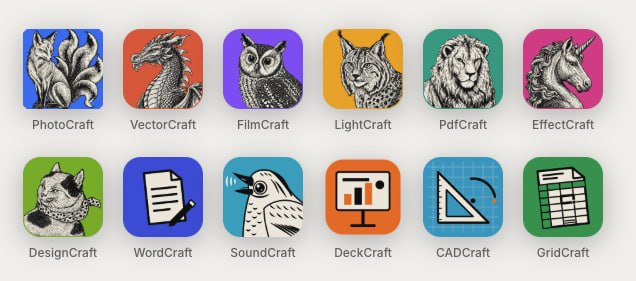
Разработчик из Барселоны с помощью модели Claude Opusi воссоздал с нуля функциональные открытые аналоги всех ключевых продуктов Adobe — Photoshop, Lightroom, Premiere, Acrobat, After Effects и Illustrator — написав их на Rusti. Авторы обоих постов делают из этого вывод: эра платного корпоративного софта заканчивается, потому что ИИ-модели теперь способны за считаные часы воспроизводить продукты, на разработку которых у оригинальных компаний уходили годы.
Речь не о гениальности одного разработчика, а о том, что подобная возможность теперь доступна любому: достаточно «показать» модели 10-секундное видео работы программы или игры, чтобы получить рабочую копию, покрывающую базовый функционал. Это меняет экономику софта — ценность смещается от самого продукта к инфраструктуре, SLA, комплаенсу и владению историческими данными.
Anthropic опубликовала разбор возможностей китайской модели GLM-5.3 (Z.ai/Zhipu AI) в области кибербезопасности и пришла к выводу, что по способности находить и эксплуатировать уязвимости она почти сравнялась с передовой закрытой моделью Claude Mythos Preview. Проблема в том, что GLM-5.3 распространяется с открытыми весами, а значит, встроенные ограничения на вредоносное использование из неё можно снять самостоятельно — и, по оценке Anthropic, сделать это относительно легко.
Это первый случай, когда Anthropic оценила открытую китайскую модель по киберспособностям, и доклад вышел в тот же день, когда в Белом доме лидеры технологических компаний, включая OpenAI и Anthropic, подписали с Трампом соглашение о моральных обязательствах по ИИ без государственного регулирования — что усилило политический подтекст публикации.
ВыводНа бенчмарке ExploitBench (эксплуатация известных уязвимостей движка V8) GLM-5.3 довела до рабочего эксплойта 50 попыток из 410 (≈12%), Claude Mythos Preview — 56 из 410 (≈14%); у Claude Opus 4.6 и GLM-5.2 результат близок к нулю

Команда Артема Снегирева (УЭСМО) выпустила в открытый доступ FRIDAi-Decisions — дообученную версию энкодера FRIDA для структурированных решений по русскому тексту: выбор одного варианта из K, оценка по шкале, ответ да/нет, ранжирование кандидатов. Модель не генерирует токены — она выдаёт ответ и его уверенность за один проход энкодера, что подходит для роутинга, модерации, определения интентов и отбора документов для RAGi.
Главная особенность: варианты ответа пишутся прямо текстом внутри запроса в виде JSON, поэтому смена набора меток — это новая задача, а не новое обучение модели. Веса и демо уже доступны на HuggingFace, подробности опубликованы на neuraldeep.ru.

Команда исследователей Т-Технологий выступила на международной конференции ACM RecSys 2026i в Миннеаполисе (США) с тремя разработками, решающими проблему нехватки данных в рекомендательных системах — так называемый холодный стартi, когда у нового пользователя нет истории действий, а у редких товаров почти нет взаимодействий. Все три инструмента — библиотека Scikit-Rank, фреймворк Perseus и метод ScaL³AE — выложены в открытый доступ.
Разработки нацелены на разные этапы работы рексистем: Perseus объединяет разрозненные данные о пользователе из разных сервисов экосистемы, Scikit-Rank упрощает внедрение нейросетевых моделей ранжирования в существующие пайплайны, а ScaL³AE позволяет эффективно работать с промышленными каталогами из миллионов товаров, в том числе с малым числом взаимодействий.
ВыводPerseus обучает нейросеть на общей последовательности сигналов о пользователе из разных продуктов (например, покупки в «Шопинге», кэшбэк, обращения в поддержку), благодаря чему даже новый сервис сразу «знает» клиента