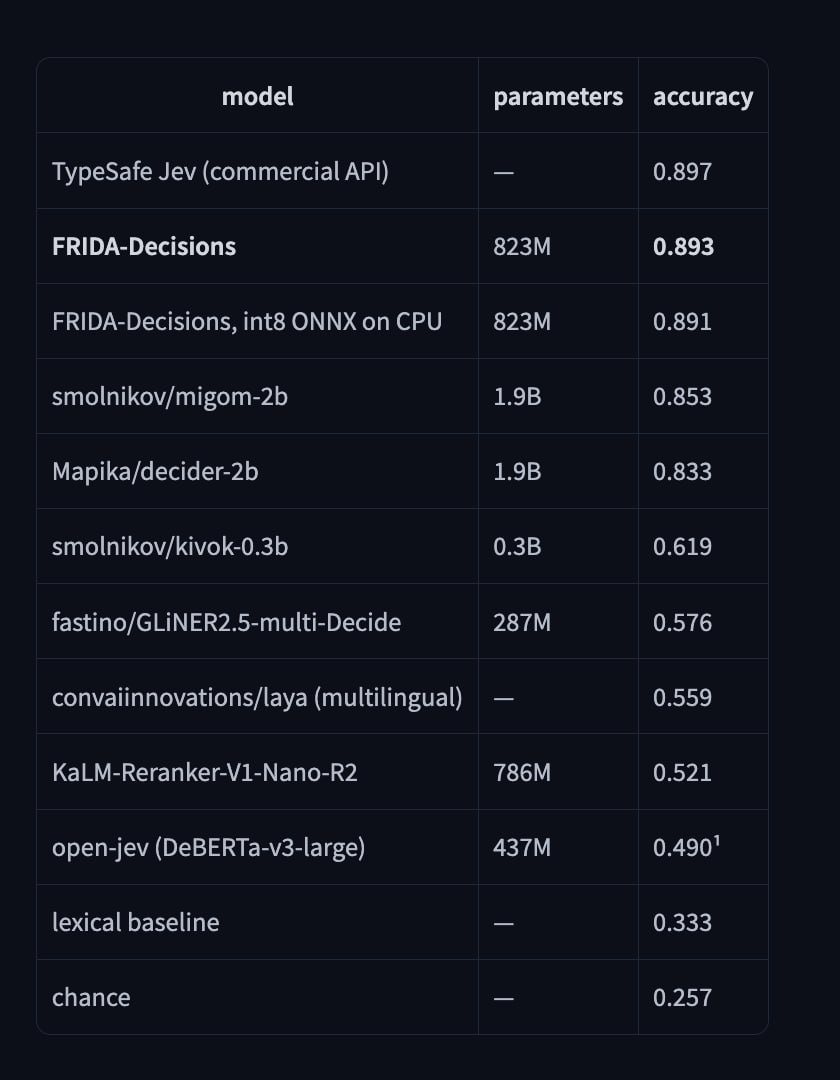
FRIDA-Decisions makes structured decisions over Russian text in a single encoder pass: pick one of K options, place a text on an ordinal scale, answer yes / no, or rank candidates. The options are written as text inside the request, so a new label set is a new JSON, not a new training run. No generation, no output tokens, no parsing: every answer is one of the declared options, with its confidence.Через пару часов будет на neuraldeep.ru Отличное развитие https://huggingface.co/ai-forever/FRIDA (которая у нас тоже есть) от автора канала https://huggingface.co/ai-forever/FRIDA-Decisions UPDATE: https://neuraldeep.ru/models/frida-decisions https://neuraldeep.ru/docs#decisions
Выпуск модели FRIDA-Decisions для структурированного анализа текста
D@dealerAIAI-инженер
3 недПредставлена модель FRIDA-Decisions, позволяющая выполнять структурированные задачи классификации и ранжирования на русском языке без генерации текста.
Новый инструмент для эффективной классификации текстов на русском языке.
- Позволяет выполнять задачи классификации и ранжирования без генерации текста.
- Упрощает настройку новых меток через JSON, исключая необходимость переобучения модели.
- Обеспечивает высокую предсказуемость ответов за счет выбора из заданного списка вариантов.
Наш jev? FRIDA-Decisions!
Ребята из ру сегмента тоже не отстают
Кратко (AI)
Представлена модель FRIDA-Decisions, предназначенная для выполнения структурированных задач на русском языке, таких как классификация, ранжирование и ответы на вопросы типа «да/нет». Модель работает за один проход энкодера без генерации токенов, что позволяет гибко настраивать метки через JSON-запросы.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖