FRIDA-Decisions: быстрый роутинг и классификация текста без LLM
M@mashkka_dsAI-инженер
3 недКоманда Артема Снегирева представила FRIDA-Decisions — энкодер для задач классификации, роутинга и гардрейлов с задержкой ~30 мс.
Позволяет автоматизировать рутинные задачи обработки текста в 10 раз быстрее и дешевле, чем при использовании больших языковых моделей.
- Снижает задержку обработки запросов до 30 мс.
- Позволяет выполнять классификацию и роутинг на обычном железе без GPU-кластеров.
- Подходит для создания быстрых систем модерации и RAG-фильтрации.
⚡️ FRIDA-Decisions: роутинг, гардрейлы и интенты по русскому тексту за ~30 мс без LLM
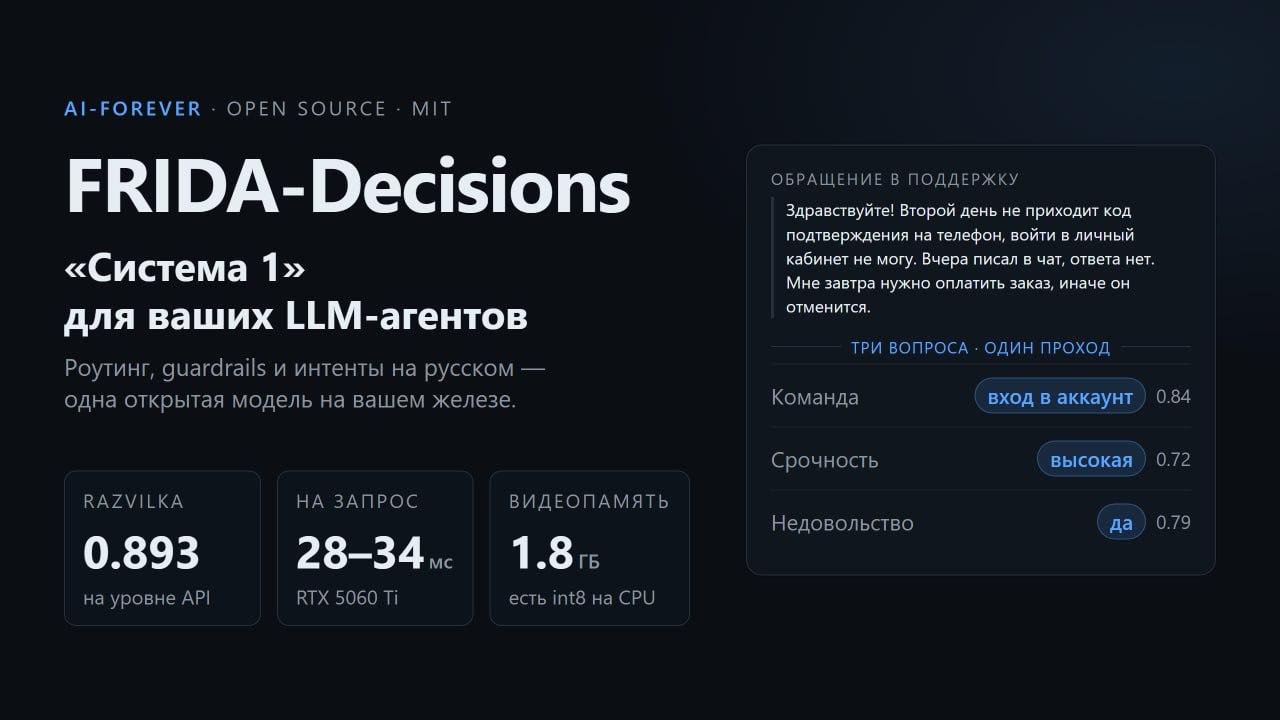
На хайпе нашумевшего jev. Выбрать вариант из списка, поставить оценку, ответить да или нет, упорядочить кандидатов — для таких решений большая LLM не нужна. Наша команда Артема Снегирева выложила в открытый доступ FRIDA-Decisions — быструю "Систему 1" рядом с вашей умной LLM: роутинг, модерация, интенты и отбор документов для RAG за один проход энкодера.
📌 TLDR
• Дообученный энкодер FRIDA (823M параметров). Варианты ответа пишутся прямо в запросе: новая задача — это новый JSON, а не новое обучение.
• На собственном бенчмарке razvilka (735 задач на русском) — метрика 0.893: на уровне коммерческого API TypeSafe Jev (0.897) и лучший результат среди проверенных открытых моделей.
• 28–34 мс на запрос (проверяли на RTX 5060 Ti) — примерно в 10 раз быстрее API по независимым замерам.
• Лицензия MIT, 1.8 ГБ видеопамяти; int8 ONNX для CPU — 0.891 на том же бенчмарке.
• Веса и демо уже доступны!
🎮 Демо
Готовые сценарии: выбор инструмента для агента, guardrails из восьми правил, роутинг тикетов и запросов, ранжирование, разбор тикета. Во вкладке "Свой запрос" — свои текст и возможные варианты. У каждого кейса есть JSON запроса и код на Python: его можно сразу перенести в свою систему.
🛠 Как встроить
pip install и несколько строк кода. Запрос — JSON с текстом и вопросами, ответ — выбранный вариант и распределение по всем. Модель рассчитана на тексты до 512 токенов. Примеры — в Colab и README.
📦 Текст читается один раз
Все варианты всех вопросов идут в одну последовательность, и текст кодируется один раз, а не заново для каждого варианта. Каталог на 243 интента разбирается за 0.44 с вместо 4.65 с. Подробности — в статье на Хабре, выйдет следом. 🌿
📊 Бенчмарк razvilka, 735 задач
Замеры:
• TypeSafe Jev (коммерческий API) — 0.897
• FRIDA-Decisions (823M) — 0.893
• Mapika/decider-2b (1.9B) — 0.833
• GLiNER2.5-multi-Decide (287M) — 0.576
• laya (multilingual) — 0.559
• open-jev (DeBERTa-v3-large, 437M) — 0.490
Попробуйте на своих задачах и расскажите, что получилось! Отдельно передаем привет ИИ-дяде @dealerAI , который стоял у истоков оригинальной FRIDA. 💪
По техническим вопросам обращайтесь к Артему: @artemsnegirev
🎮 Демо
🤗 Модель
🖥 Код
📊 Бенчмарк
📓 Примеры
#decisions #encoder #release #benchmarks #opensource
Кратко (AI)
Команда Артема Снегирева выпустила FRIDA-Decisions — легковесную модель-энкодер для задач классификации, роутинга и модерации текста. Система работает значительно быстрее LLM, обеспечивая высокую точность на бенчмарке razvilka при минимальных требованиях к ресурсам.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖