инференсСбросить фильтр ×

OpenAI открыла Decisions API для быстрых структурированных решений

OpenAI открыла всем разработчикам Decisions APIi — интерфейс на базе GPT-6 Luna для быстрых и недорогих решений с ограниченным форматом ответа. Он может выбрать вариант из списка, выдать вероятность или оценку; по заявлению компании, в таких задачах работает до десяти раз быстрее обращения к той же модели через Responses APIi.

API принимает текст, изображения и структурированные данные и позволяет отправить до 400 вопросов за запрос. Это может ускорить микрорешения в агентных процессах — например, сортировку документов, проверку снимков товаров или передачу звонка оператору.

до десяти разбыстрее Responses API
400вопросов за запрос
$0,10за миллион входных токенов

Полный разбор →

Speculative Sampling ускоряет интерактивные видеомодели без обучения

Н@GreenNeuralRobotsAI-инженер
вчера

Инференс на Blackwell приносит до $38 в час на GPU

С@seeallochnayaAI-инженер
2 дн

Как ограничивать риски открытых моделей

С@seeallochnayaAI-инженер
3 дн

SonicBoom: C++-движок инференса без Python

HardenedVault выпустила SonicBoom — среду исполнения для локального запуска языковых моделей на потребительских процессорах и видеокартах. Движок написан на C++ и CUDA, не требует Python ни для работы, ни для сборки и предоставляет локальный сервер с API OpenAI.

В первых тестах на RTX 3050 SonicBoom быстрее llama.cpp на двух моделях при коротком контексте, но преимущество почти исчезает на глубине 512 токенов. Сторонний замер на RTX 4060 Ti показал результат ниже llama.cpp; сборка не была настроена под эту видеокарту.

RTX 3050видеокарта для тестов
512 токеновглубина контекста
RTX 4060 Tiсторонний тест

Полный разбор →

DeepSeek открыла исходный код движка инференса DeepInfer

20 октября DeepSeek опубликовала DeepInfer — движок, на котором запускает DeepSeek-V4.1-Flash в продакшене. Под лицензией Apache 2.0 его могут использовать другие разработчики и провайдеры; цель — ускорить генерацию и снизить вычислительные затраты.

Релиз раскрывает часть инфраструктуры DeepSeek, но пока не представляет готовую замену полноценной системе обслуживания моделей: поддерживаются одна модель и ограниченный набор ускорителей, а некоторые компоненты масштабирования отсутствуют.

155 трлн токенов в деньзаявленная производительность кластера
$38выручка с видеокарты в час
$3примерная аренда H100 в час

Полный разбор →

У Anthropic высокая валовая маржа, но она не учитывает затраты на обучение моделей

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 нед назад

По данным Bloomberg и FT, валовая маржа Anthropic в третьем квартале составила около 85%; другой источник оценивает её как более 80%. Однако этот показатель учитывает обслуживание запросов клиентов, но не обучение новых моделей и не долю облачных партнёров, поэтому сам по себе не отражает полную экономику бизнеса.

Компания получает около $100В годовой выручки при мощностях в 5 гигаватт, но, по данным одного из источников, лишь 25% ресурсов уходит на обслуживание клиентов, а остальные 75% — на обучение моделей и технические эксперименты. Это ставит высокую маржу в контекст значительных затрат на инфраструктуру и разработку.

около 85%валовая маржа в третьем квартале
около $100Вгодовая выручка
10,5 ГВновые мощности в 2027 году

Полный разбор →

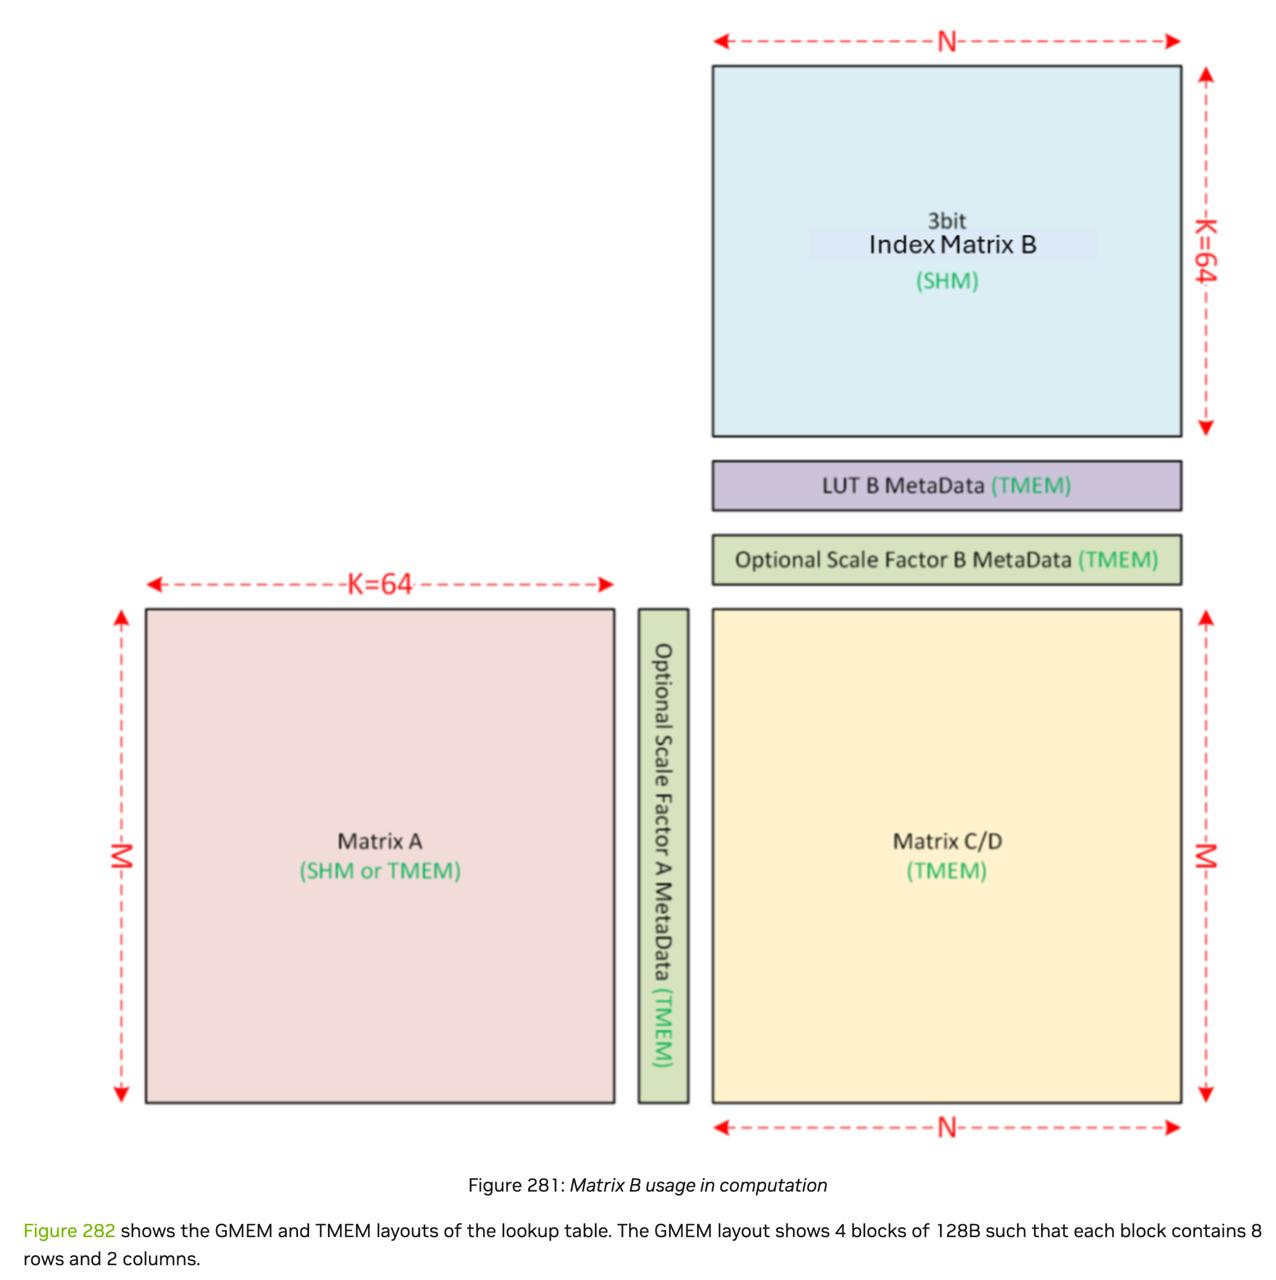
LUT3 в NVIDIA Rubin: новое 3-битное представление весов

К@quant_prune_distillAI-инженер
1 нед
LUT3 в NVIDIA Rubin: новое 3-битное представление весов

Авторы предложили обучаемое низкоранговое сжатие нейросетей

В новой работе предложен метод сжатия нейросетей, который обучает ортогональные проекции на важные для целевой задачи подпространства. В отличие от подходов, опирающихся на приближение весов или прокси-метрики, метод напрямую оптимизирует разложение и распределяет ранги между слоями по расхождению с исходной моделью.

Авторы сообщают о результатах на OPT, Llama-2, Qwen3 и ViT: при сжатии до 50–70% качество оказалось лучше, чем у рассмотренных бейзлайнов, а ускорение инференса достигало 1,5×. При этом источник отмечает, что заметное ускорение всё ещё может сопровождаться серьёзным снижением качества.

ВыводДля слоя обучают ортогональную матрицу U; проектор задаётся как I − U Uᵀ.

50–70%уровень сжатия моделей
1,5×максимальное ускорение инференса

Полный разбор →

Критерии отбора научных статей по AI

К@quant_prune_distillAI-инженер
1 нед
Считаю, статьи без кода, если это только не теор DL или position paper, надо деск реджектить. Нагаллюцинировать у себя можно сколь угодно хорошие результаты. А без возможности валидации со стороны рецензента, авторов сложно уличить во лжи или подлоге результатов. Также надо реджектить спекдек с батчом 1 и без vLLM / SGLang интеграции. И квантизацию OPT-ов и Llama-1/2 в 2026-м году.

AI-агенты тратят в 5 раз больше токенов, чем люди — но методология вызывает вопросы

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 нед назад

Фонд a16zi в отчёте State of Markets опубликовал график: AI-агенты сейчас потребляют в 5 раз больше токенов, чем люди, и этот разрыв сформировался всего за полгода — ещё в феврале 2026 года люди тратили токенов больше, чем агенты. Первоисточник данных — Питер Волкер из OpenRouteri, шлюза, связывающего разработчиков с поставщиками моделей.

Цифра выглядит эффектно, но канал «Дизраптор» указывает на серьёзные ограничения: OpenRouter — это лишь около 1% мирового инференса, работает в основном с опенсорсными моделями, и данные не включают API Claude, ChatGPT и других проприетарных систем. К тому же сравнивались не люди и агенты в буквальном смысле, а автономные циклы задач против диалоговых запросов — если человек запускает из чат-бота масштабную агентную задачу, она засчитывается как «человеческие» токены.

ВыводЗа полгода потребление токенов у людей выросло почти в 3 раза, а у AI-агентов — в 14 раз

в 5 разагенты тратят больше токенов, чем люди
в 14 разрост потребления токенов агентами за полгода
86%венчурных инвестиций США в AI-стартапы в 2026

Полный разбор →

Intel представила ИИ-ускоритель D270 без 3D-графики и трассировки лучей

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 нед назад

Intel анонсировала ускоритель D270, предназначенный исключительно для инференса ИИ-моделей, а не для игр. Из чипа физически убрали блоки 3D-рендеринга и трассировки лучей, отдав освободившуяся площадь под вычислительные ресурсы.

Карта построена на архитектуре Xe3Pi (кодовое имя проекта — Crescent Island), выдаёт до 1,3 Пфлопс в FP8i и поддерживает до 480 Гбайт памяти LPDDR5X, что делает её рассчитанной на модели от сотен миллиардов до триллиона с лишним параметров.

1,3 Пфлопспроизводительность в FP8
480 Гбайтмаксимальный объём памяти LPDDR5X
350 Втэнергопотребление карты

Полный разбор →

AI-Toolkit получил встроенный интерфейс для генерации контента

М@cgeventAI-инженер
2 нед

Anthropic исследует риски самореплицирующихся ИИ-агентов на IoT-устройствах

D@data_secretsAI-инженер
2 нед
Anthropic исследует риски самореплицирующихся ИИ-агентов на IoT-устройствах

Microsoft представила ИИ-чип Maia 300 и делает ставку на собственный инференс

Microsoft анонсировала Maia 300iа)">i — третье поколение собственного чипа для инференса ИИ (использования уже обученной модели для решения задач). С 2027 года компания планирует масштабировать семейство Maia до развёртываний на несколько гигаватт и сделать его основной платформой инференса для своих сервисов вроде Teams и Copilot, снижая зависимость от процессоров Nvidia и AMD.

Главная метрика для Microsoft теперь — не пиковые терафлопсы, а токены на ваттi: от неё напрямую зависит себестоимость каждого ответа Copilot. По заявлению компании, Maia 300 выдаёт на 40% больше токенов на ватт, чем ведущие GPU-решения конкурентов при той же мощности. Это повторяет путь, пройденный ранее Google с чипами TPU и Amazon с Trainium.

40%больше токенов на ватт против GPU-конкурентов
7 разприрост скорости генерации против Maia 200
300 тысяччипов Maia 300 заказано у TSMC

Полный разбор →

Ещё ↓