Исследование ComposeCL: методы предотвращения забывания в LLM
Н@GreenNeuralRobotsAI-инженер
1 месОбзор исследования ComposeCL, посвященного методам сохранения знаний в LLM при последовательном обучении и предотвращению катастрофического забывания.
Это исследование предлагает способ сделать ИИ-агентов более «памятливыми» и способными обучаться новому без потери старых навыков.
- Решает проблему «катастрофического забывания», когда модель теряет старые знания при изучении новых данных.
- Показывает, что комбинация методов (якоря данных, функций и весов) работает в разы лучше, чем использование одного подхода.
- Помогает разработчикам создавать долгоживущих ИИ-агентов, которые могут постоянно обновлять свои знания.
ComposeCL
Давно ничего не постил про память LLM
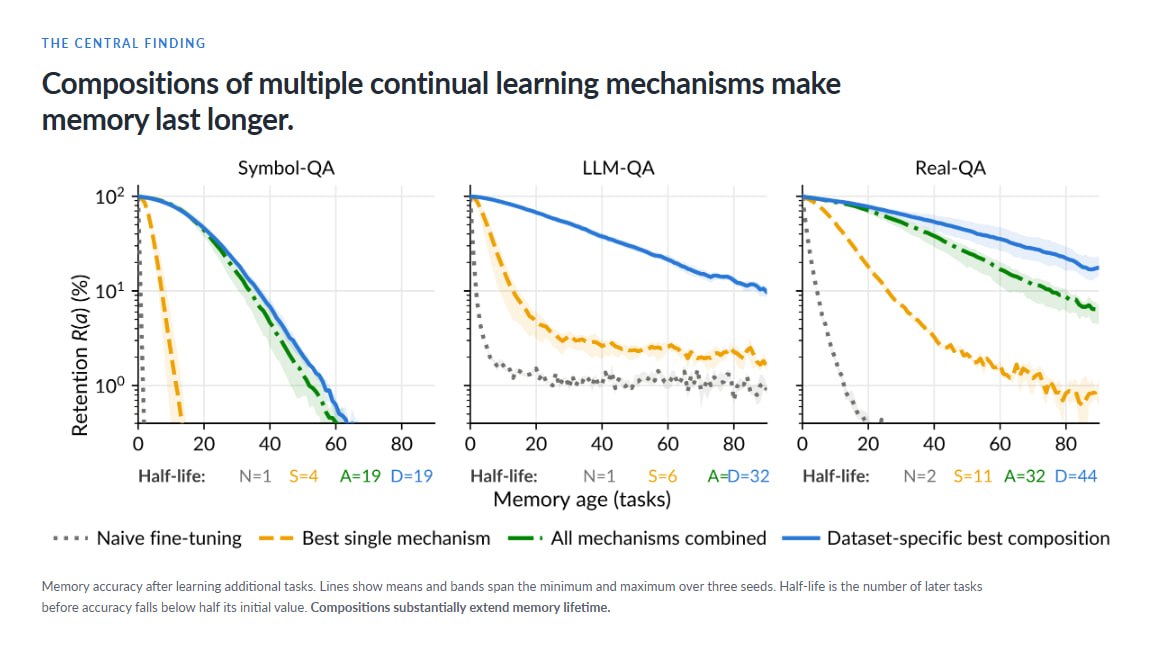
Исследование о том как языковые модели могут запоминать информацию поступающую последовательно и не забывать ее после десятков обновлений. Обычное дообучение на новых задачах стирает старые знания — ComposeCL проверяет какие комбинации механизмов продолжающегося обучения работают лучше всего
- Систематический тест 16 комбинаций 4 механизмов: якорь данных (генеративный реплей), якорь функции (самодистилляция), якорь весов (Synaptic Intelligence) и merged LoRA
- Лучшая комбинация всех 3 якорей + merged LoRA дает 34.9%
- Якорь данных и merged LoRA дают наибольший прирост
- 34.9% среднее финальное удержание против 1.2% у наивного обучения
- Топ-3 на 3 датасетах у одной фиксированной композиции всех механизмов
Вывод: для долгоживущих агентов нужно не выбирать один механизм а комбинировать несколько комплементарных
Гитхаб
#memory
Кратко (AI)
Исследование ComposeCL анализирует проблему катастрофического забывания в языковых моделях при последовательном обучении. Авторы протестировали комбинации из четырех механизмов, включая генеративный реплей, самодистилляцию, Synaptic Intelligence и merged LoRA, доказав, что сочетание нескольких подходов значительно эффективнее одиночных методов.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖