Масштабные блокировки интернета в Туркменистане
З@zatelecomавтор про «it»
2 мес
Китайская компания CXMTi начала массовое производство LPDDR6i — памяти нового поколения для смартфонов, обходящей по скорости топовую LPDDR5X почти вдвое. Один из первых смартфонов с этой памятью — складной Xiaomi 18 Fold на чипе Xring O3i, релиз которого ожидается в сентябре.
За CXMT в производство LPDDR6 намерена войти и южнокорейская SK hynix, что говорит о скором переходе индустрии на новый стандарт мобильной оперативной памяти.
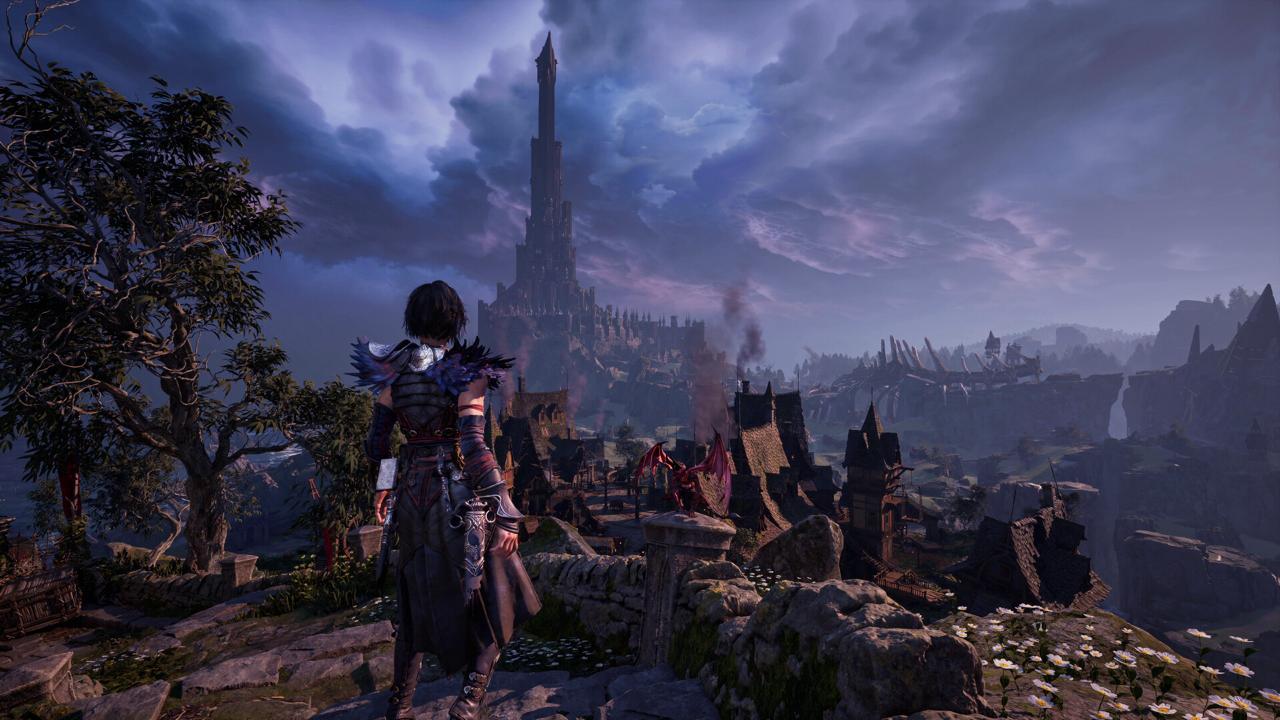
На Opening Night Live перед Gamescom 2026 CD Projekt RED представила The Witcher 3: Wild Hunt — Remastered — переиздание с переработанной графикой, боевой системой и техническими улучшениями, которое получат бесплатно все владельцы игры. Релиз назначен на 29 сентября 2026 года.
Одновременно показали трейлер и первый геймплей финального сюжетного дополнения «Баллады прошлого» (англ. Songs of the Past), которое, как ожидается, свяжет события третьей и четвёртой частей «Ведьмака». Дата выхода DLC — 2027 год.
27 августа Google представила Gemini Omni 1.1 Flashi — production-релиз (GA, не preview) видеомодели gemini-omni-1.1-flash в Gemini API. Главное новшество: ролики теперь можно продлевать кусками по 10 секунд до суммарных 40 секунд, причём при продлении модель учитывает до 10 секунд контекста предыдущего видео вместо примерно одной секунды раньше.
Модель также умеет достраивать середину сцены по заданным первому и последнему кадру, генерировать быстрые черновики в 360p и апскейлить финал до 1080p/4K. Новинка уже доступна в Google Flow и Google AI Studio, а старую preview-версию отключат 30 сентября.
Правительство Южной Кореи запускает программу «Искусственный интеллект для всех» — бесплатный и неограниченный доступ к генеративным ИИ-сервисам для всех граждан страны. Бета-тест программы начнётся в сентябре 2026 года.
Важный нюанс: безлимитный доступ распространяется только на отечественные, национальные модели. Власти хотят ускорить внедрение южнокорейских ИИ-разработок и снизить зависимость от американских и китайских технологий, пока пользовательские привычки граждан ещё не закрепились.
Alibaba представила Qwen3.8-Flash — мультимодальную MoEi-модель, а также открыла веса Qwen3.8-Flash-Next, ранней версии архитектуры, на которой команда строит будущий Qwen4. Модель имеет 125B параметров (из них активируется всего 6B на токен) плюс 51B дополнительных N-gram embeddingsi, повышающих емкость почти без роста вычислений. Обучение обошлось примерно в 9 раз дешевле, чем у Qwen3.7-Plus, а по бенчмаркам модель обходит Qwen3.8-27B и, по разным оценкам, конкурирует с DeepSeek-V4-Flash или превосходит его.
Модель уже доступна и продакшен-версией в QwenCloud, и открытыми весами на HuggingFace (в том числе в GGUF-квантах от Unsloth), поддерживается vLLM и SGLang, появилась на OpenRouter. Благодаря компактному числу активных параметров и оптимизации под unified memory её можно гонять локально на машинах вроде DGX Spark, Mac Studio и Strix Halo с ~128 ГБ памяти.