qwenСбросить фильтр ×

Qwen3.8-Flash помогает в разработке системы поощрений для Telegram-каналов

S@seniorsoftwarevloggerмедиа / агрегатор
1 мес
Qwen3.8-Flash помогает в разработке системы поощрений для Telegram-каналов

Qwen3.8-LiveTranslate: синхронный перевод с клонированием голоса

Н@GreenNeuralRobotsAI-инженер
1 мес
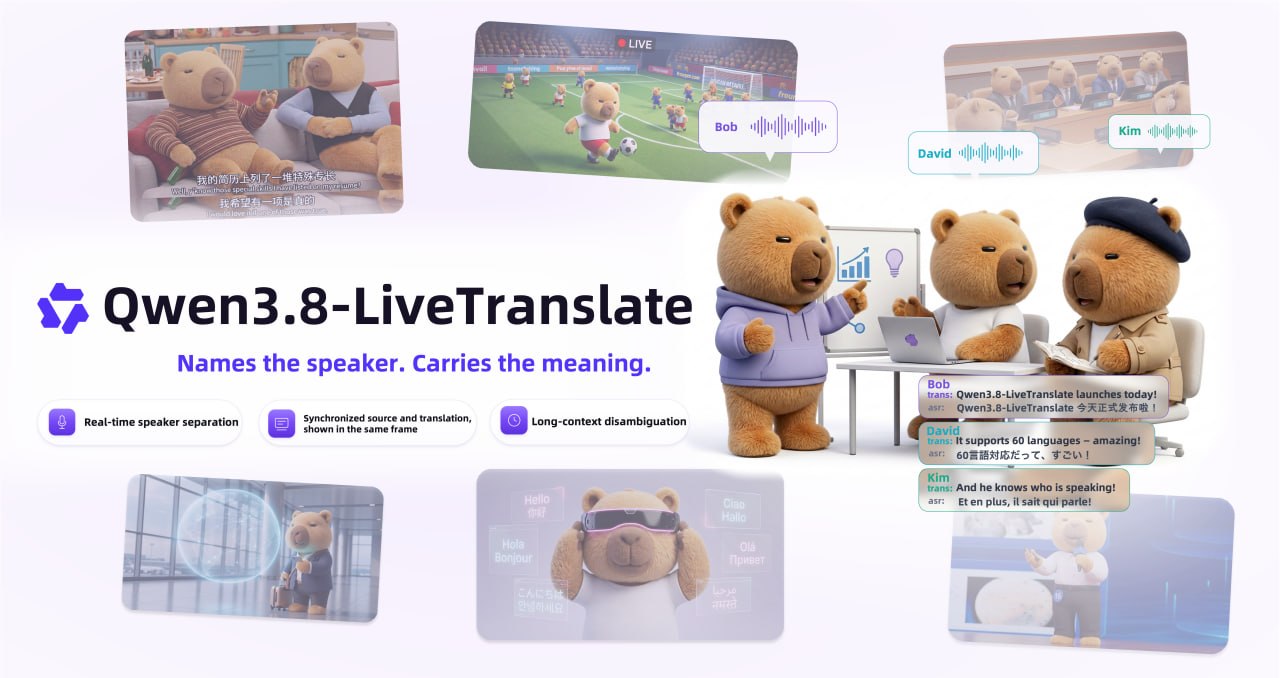
Qwen3.8-LiveTranslate: синхронный перевод с клонированием голоса

Сравнение популярных LLM в профессиональной работе

Е@keymarketingмедиа / агрегатор
1 мес

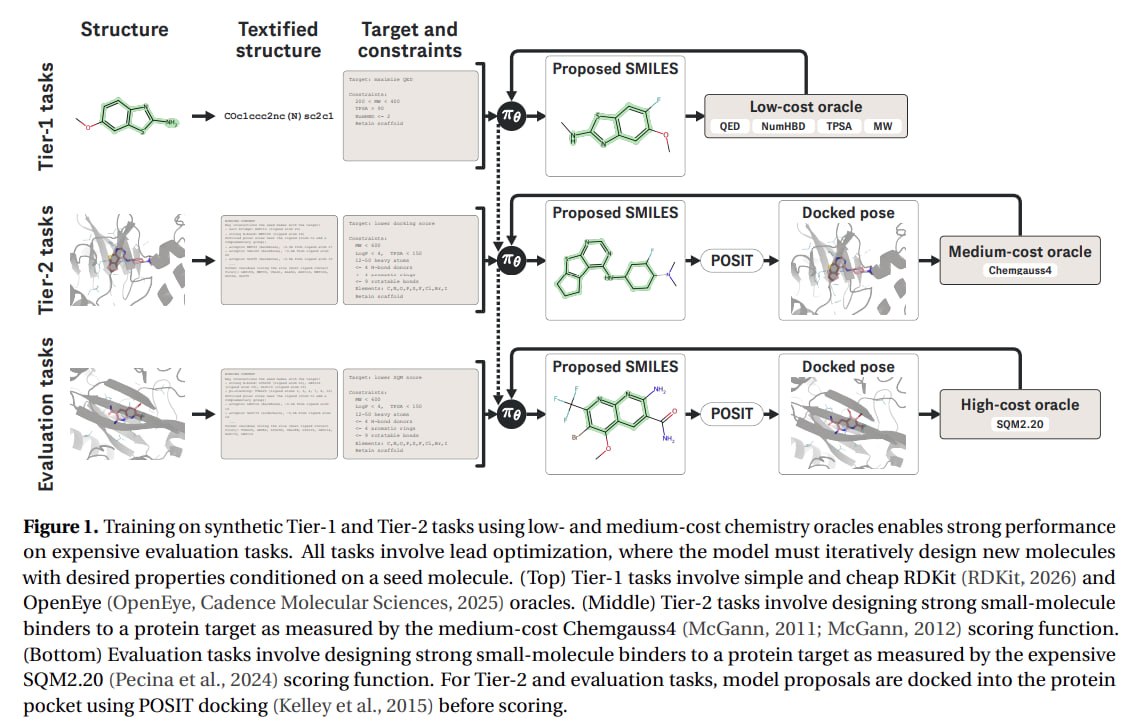
Обучение Qwen 3.5 35B для дизайна молекул

А@AGI_and_RLAI-инженер
1 мес
Обучение Qwen 3.5 35B для дизайна молекул

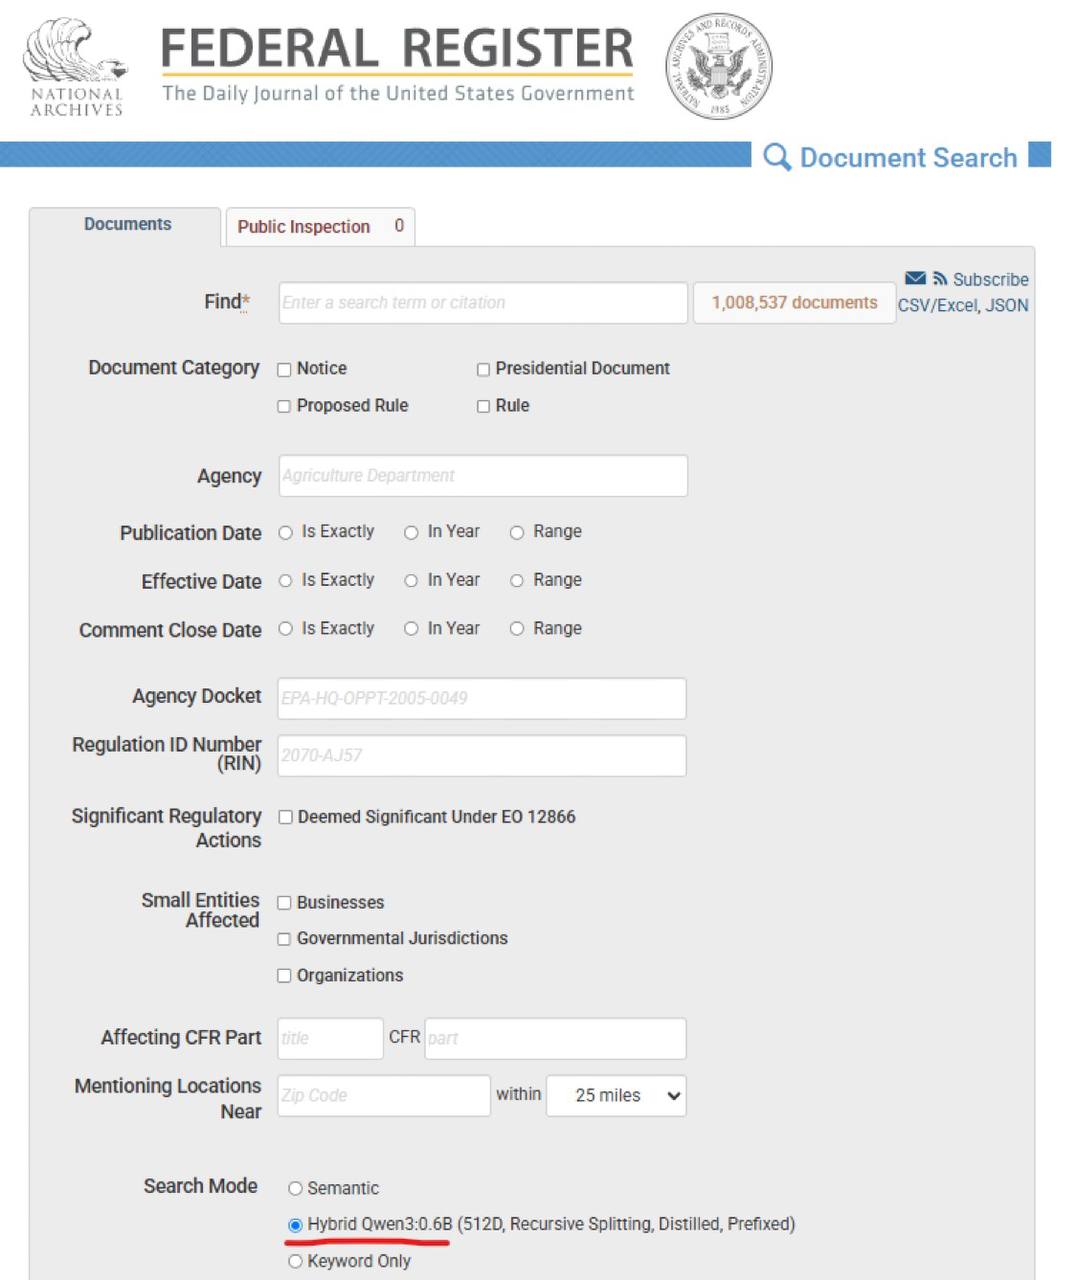
Правительство США использует модель Qwen от Alibaba для поиска по документам

C@campcodeAI-инженер
1 мес
Ирония невиданного масштаба: правительство США использует для поиска по государственным документам… китайскую Qwen 😆 На сайте Federal Register, где публикуются правила, указы и другие документы правительства США, обнаружили несколько ИИ-режимов поиска. И два из них работают на базе маленькой открытой модели Alibaba Qwen3-0.6B. Опенсорс рулит 🕶
Правительство США использует модель Qwen от Alibaba для поиска по документам

Китай внедряет токены ИИ в повседневную экономику

М@myobrechenychannelAI-инженер
1 мес

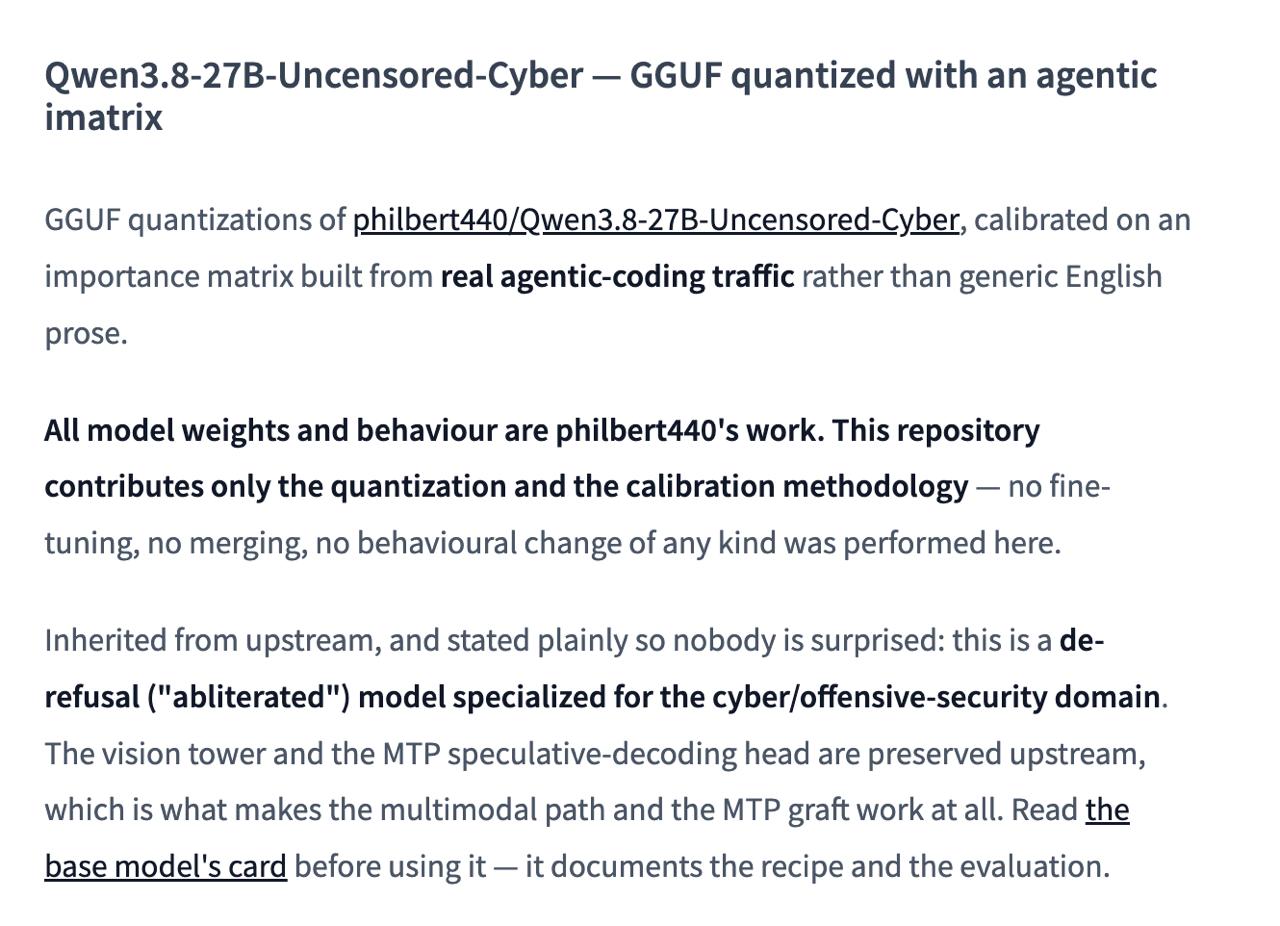
Выпущен Qwen3.8-27B Uncensored в формате GGUF для агентных задач

1 мес
Выпущен Qwen3.8-27B Uncensored в формате GGUF для агентных задач

Qwen 3.8 Flash Next: модель на 125 млрд параметров запускают на 6 ГБ VRAM, но независимые тесты показывают разочаровывающий результат

AI-редакция
3 источника · показать все· свернуть
разгоняется · 3обновлено 1 мес назад

Alibaba выпустила Qwen 3.8 Flash Next — MoEi-модель на 125 млрд параметров с необычным механизмом n-gram embedding-таблицi, которые можно выгружать на диск или в оперативную память. Благодаря этому модель удалось запустить на обычной RTX 4090 с пиковым расходом всего 5,95 ГБ VRAMi — без квантизации и дистилляции, притом полный checkpoint, а не урезанная демо-версия.

Однако независимое тестирование показало противоречивую картину: блогер Галера Морева после 4 часов проверки не увидел разницы в интеллекте между Qwen 3.8 Flash Next и плотной моделью Qwen 3.8, при этом ресурсные требования у Flash Next оказались куда выше. По его словам, тест на роль «ассистента» модель не прошла.

125 млрдпараметров модели
5,95 ГБпиковый расход VRAM на RTX 4090
360 ГБразмер полного checkpoint в bf16

Полный разбор →

Разработчик выпустил Android-клавиатуру «Соучастник», которая считает срок за сообщения в реальном времени

Пользователь GitHub под ником MShverdiakov опубликовал опенсорсную Android-клавиатуру «Соучастник»: она анализирует набираемый текст прямо во время печати и показывает, какой теоретический срок и штраф можно получить за написанное по статьям российского законодательства.

Ключевая особенность — приложение работает полностью локально: в APK нет разрешения android.permission.INTERNETi, а введённый текст никуда не отправляется. Проект уже набрал заметную популярность в соцсетях и на GitHub.
470 МБразмер итогового APK
500звёзд на GitHub-репозитории
4-6 секундвремя обработки фразы на 4 ГБ ОЗУ

Полный разбор →

Microsoft представили FrogNano: 4B модель для кодинга

А@AGI_and_RLAI-инженер
1 мес
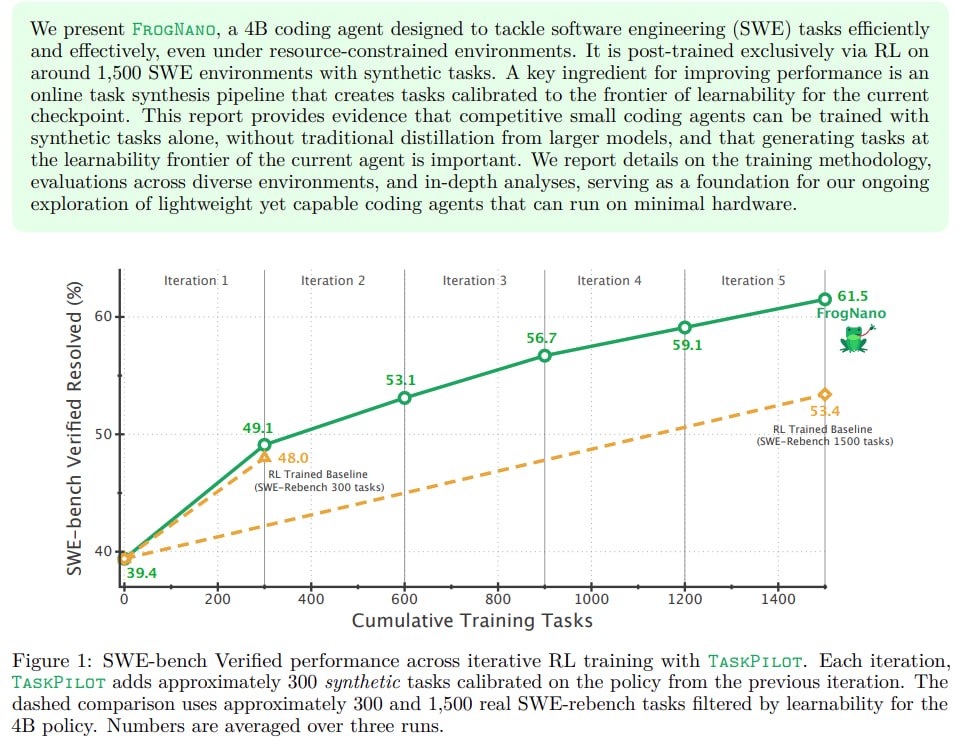
Майкрософты потюнили 4B Qwen-3.5 на 61.5% Swe-bench verified чисто генерацией задач и рлем FrogNano: Training a 4B Coding Agent via Online Task Synthesis https://microsoft.github.io/debug-gym/static/papers/frognano_technical_report.pdf https://microsoft.github.io/debug-gym/
Microsoft представили FrogNano: 4B модель для кодинга

Qwen-Drive 1.0: Foundation Model для автономного вождения

D@datastorieslanguagesAI-инженер
1 мес

Обзор новых квантованных и специализированных моделей Qwen3.8-Flash-Next и Spark-X2.5

Н@GreenNeuralRobotsAI-инженер
1 мес

Релиз MCNL v1 для Qwen Image Edit 5211

Н@GreenNeuralRobotsAI-инженер
1 мес
MCNL v1 — Multi Concept NSFW LoRA for Qwen Image Edit 5211 Если ктото еще пользуется #QIE2511 то вот держите лору без цензуры Демо #uncensored VK | MAX

Qwen представил E-Commerce Bench — бенчмарк, где AI-агент год управляет интернет-магазином

Qwen (по данным Source 2 — совместно с Taobao & Tmall) выпустила E-Commerce Benchi: агенту выдают 100 000 юаней и 365 виртуальных дней, за которые он должен вести до четырёх интернет-магазинов — искать поставщиков, торговаться, назначать цены, запускать акции, управлять складом и денежным потоком. Среда построена на реальных данных электронной коммерции и не подсказывает агенту ни потолок спроса, ни себестоимость товара — это нужно выяснять самостоятельно.

Оценка идёт по семи направлениям одновременно, и единой модели-лидера во всём пока нет: лучшие результаты по капиталу показал GPT-5.6 Sol, а среди моделей с открытыми весами — Qwen3.8-Max-Preview. При этом переговоры и торг с поставщиками не даются практически никому, а часть агентов доводит бизнес до банкротства.
100 000 юанейстартовый капитал агента
1,43 млн юанейитоговый капитал лидера GPT-5.6 Sol
26,4%доля поставщиков-мошенников (152 из 576)

Полный разбор →

Alibaba представила Qwen 3.6-35B-A3B для стриминговых аватаров

А@AGI_and_RLAI-инженер
1 мес
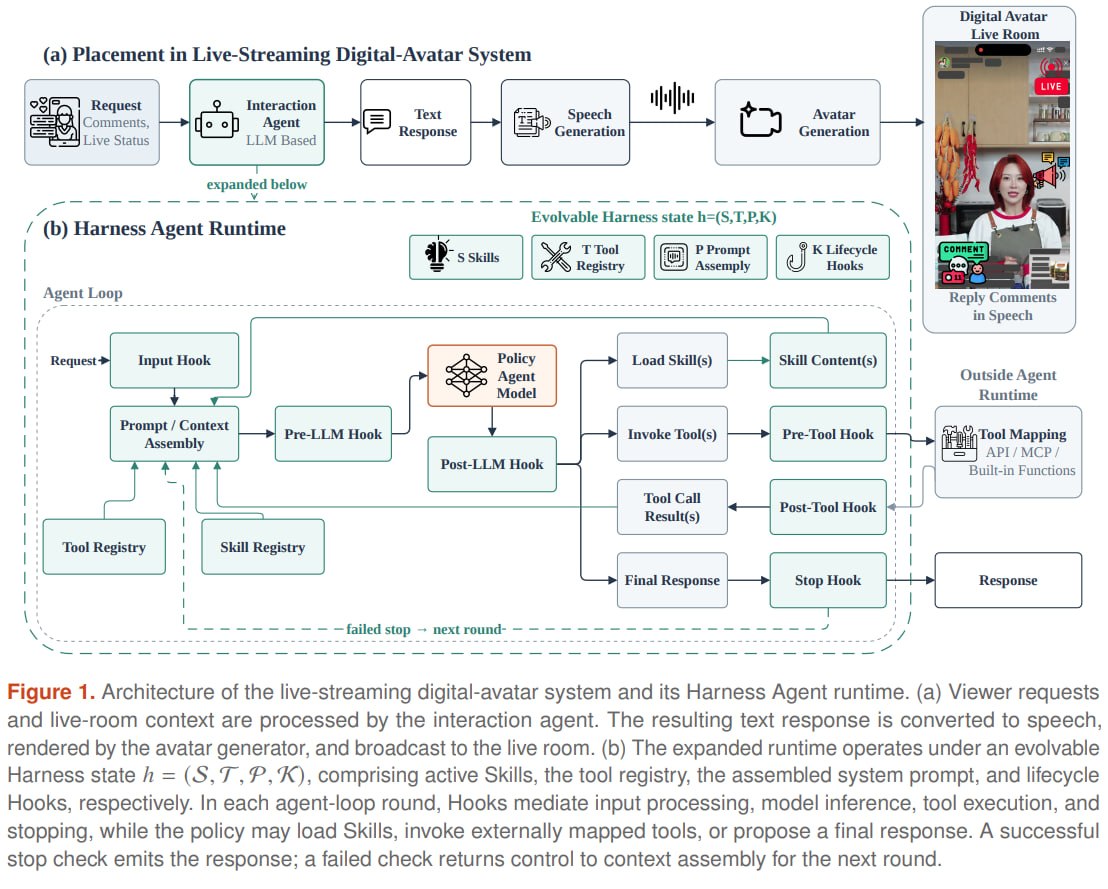
Алибаба потюнили Qwen 3.6-35B-A3B чтобы он лучше обслуживал аватара на стримах нуи в целом схема как там устроено все на скрине, прикольно Training Agents to Evolve with Their Harness: TaoLive Digital Avatar Agent Technical Report https://arxiv.org/abs/2608.15763 https://www.alphaxiv.org/ru/abs/2608.15763
Alibaba представила Qwen 3.6-35B-A3B для стриминговых аватаров

Сравнение Qwen 3.8: Q8_0 против FP8

Г@gmorevaAI-инженер
1 мес
Qwen 3.8 Q8.0 против FP8 Продолжаю цепочку роликов про Qwen 3.8. Сегодня — битва двух титанов: квант Q8_0 от Unsloth (llama.cpp, 2×2080, NVLink) против официального FP8 от Qwen (vLLM, 2×3090). Условия максимально честные: у обеих 8-битный KV-кэш (вы меня убедили отказаться от 4-битного), 200 000 контекста и самый крутой режим reasoning — X-High с неограниченным бюджетом на размышления. Никаких синтетических бенчмарков — только реальные задачи из моей работы, с одного и того же промпта, параллельно. 📹 YouTube | VK | Rutube | Dzen 📹

Небольшая лаба выпустила инференс-движок со спекулятивным декодингом для Apple Silicon

Небольшая независимая лаба анонсировала мажорный релиз своего инференс-движка с поддержкой спекулятивного декодинга. По заявлению авторов, движок значительно превосходит все существующие стеки для Apple Siliconi по производительности — за счёт того, что кернелы, квантизация и механизм спекуляции были спроектированы совместно (ко-дизайн) и написаны с нуля, без заимствований.

На старте поддерживаются модели Qwen3.6 27B, в разработке — поддержка Qwen3.8 27B и Muse Glimmer. Попробовать движок можно уже сегодня.

Полный разбор →

Qwen выпустила открытую мультимодальную модель Qwen-Drive-1.0 для автопилота

Команда Qwen представила Qwen-Drive-1.0 — модель для беспилотных автомобилей, построенную на компактной мультимодальной Qwen3.5-4B. Модель одновременно понимает дорожную обстановку по видео с нескольких камер, может отвечать на вопросы о происходящем вокруг машины и строит траекторию движения на 5 секунд вперёд.

Важность в том, что это открытый и относительно небольшой (4B) фундамент для автопилота: веса и код опубликованы под лицензией Apache 2.0i, а по собственным тестам Qwen модель обходит более крупные специализированные решения в ряде задач понимания дорожных сцен.

4Bразмер базовой модели Qwen3.5
50 точек / 5 секунддлина генерируемой траектории движения
32 слояглубина диффузионного трансформера planning expert

Полный разбор →

Ещё ↓