аватарыСбросить фильтр ×

Vidu S2: реалтайм-аватары и живое редактирование видео от Tsinghua University и Shengshu Technology

Tsinghua University и Shengshu Technology представили две новые видеомодели — Vidu S2-Avatar и Vidu S2-Editing, позволяющие вести видеозвонок или стрим с цифровым аватаром и редактировать видеопоток в реальном времени. Разрешение выросло с 540p у прежней версии Vidu S1 до 720p при 25–42 FPS.

S2-Avatar по одной фотографии и аудиодорожке создаёт живого аватара, который реагирует на голосовые и текстовые команды, а S2-Editing на лету перекрашивает стиль, меняет одежду, персонажа или фон видеопотока. Обе модели умеют отдавать результат стереопарой для VR — это заявляется как шаг к интерактивному AI-видео для стриминга и виртуальной реальности.
720p при 25–42 FPSразрешение и частота кадров
$27цена часа непрерывного стрима
85.7–100%предпочтение S2-Avatar в слепых тестах

Полный разбор →

Alibaba представила Qwen 3.6-35B-A3B для стриминговых аватаров

А@AGI_and_RLAI-инженер
1 мес
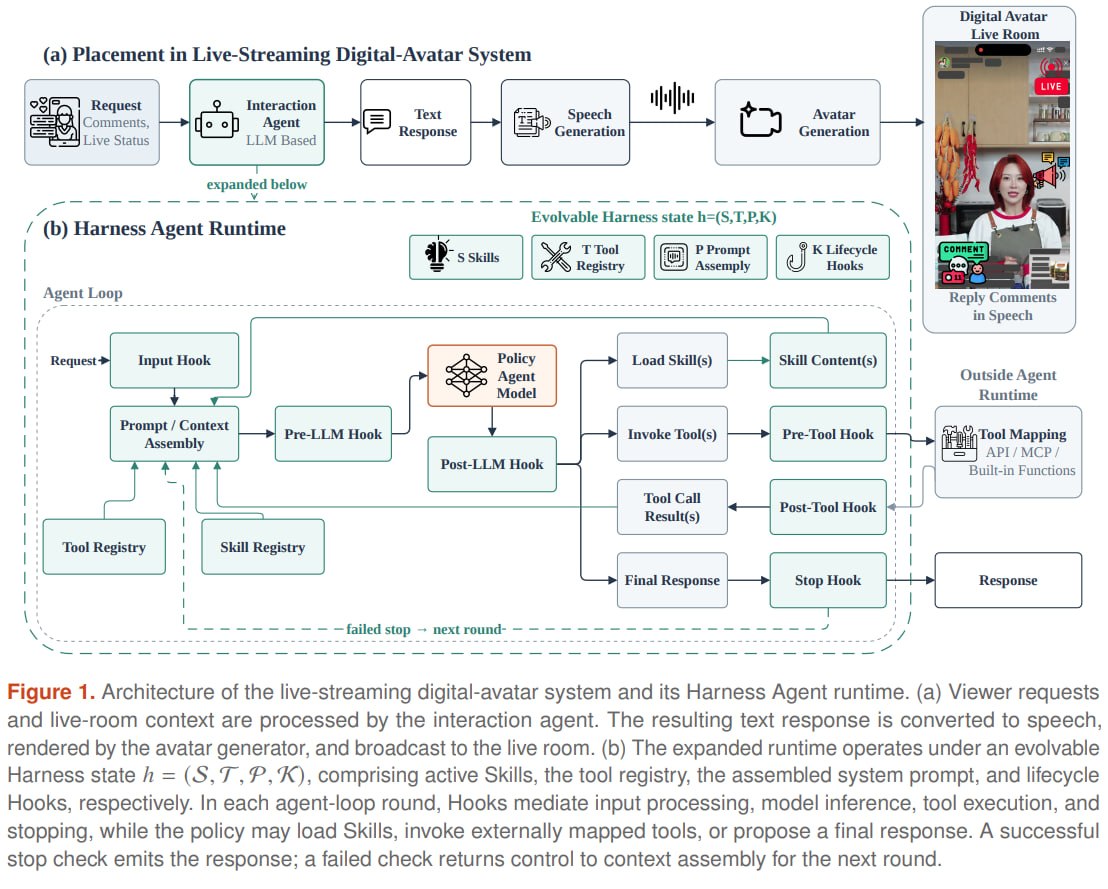
Алибаба потюнили Qwen 3.6-35B-A3B чтобы он лучше обслуживал аватара на стримах нуи в целом схема как там устроено все на скрине, прикольно Training Agents to Evolve with Their Harness: TaoLive Digital Avatar Agent Technical Report https://arxiv.org/abs/2608.15763 https://www.alphaxiv.org/ru/abs/2608.15763
Alibaba представила Qwen 3.6-35B-A3B для стриминговых аватаров

Synthesia обновила функционал создания и редактирования видео

N@v_neuroAI-инженер
1 мес
✴️ Ролик с говорящим ведущим теперь правится сообщением в чат Synthesia научилась собирать видео из статьи, файла или короткого описания, а потом переделывать его по просьбе, без пересборки с нуля. Так теперь делается ролик: ✧ Кидаешь ссылку или документ ✧ Смотришь план до генерации ✧ Просишь короче, бодрее, другим тоном ✧ Ведущий двигается и жестикулирует живее ✧ Своего персонажа рисуешь по описанию Агента и новых ведущих отдали всем тарифам, а фирменный стиль подтягивается только у корпоративных. 🔗 Разобрал, что даётся даром, где у агента потолок и на чём его стоит проверить #synthesia #аватары #генерациявидео

Arrival.Space добавила функцию создания аватаров из сплатов

М@olya_tashitмедиа / агрегатор
2 мес
Платформа Arrival.Space теперь позволяет не только загружать сплаты и гулять по ним, но и аватар создать из сплатов. То есть, отсканить себя и ходить по виртуальному миру собой. И результат даже выглядит довольно реалистично. Без зловещей долины, хоть и все еще не идеально. Я думаю такой прикол зайдет как развлечение на каких-нибудь выставках, но не на постоянке. Люди в виртуальные миры ходят, не потому что хотят своим реальным лицом торговать. А потому что хотят хоть немного побыть кошкодевкой, а не уставшим бородатым айтишником. 🌚

Vidu представил инструменты для создания музыкальных видео и интерактивных аватаров

Н@GreenNeuralRobotsAI-инженер
2 мес

В ChatGPT появились анимированные «аватары» в разделе персонализации

OpenAI добавила в ChatGPT новую функцию — «аватары» в категории «Peti» внутри настроек персонализации. Пользователь может создать своего аватара из картинки или текстового описания, а анимирует его сам ChatGPT.

Аватар оживает в режиме «Worki» — то есть в момент, когда ChatGPT «думает» над ответом, — и его можно поделиться с другими в интернете.

Полный разбор →

Опасные аватары в VRChat

М@olya_tashitмедиа / агрегатор
3 мес
Прекрасный аватар для сжигания чужих компов в виарчате. 🤩 Напомнило, как я однажды решила отключить настройки безопасности, чтобы видеть вообще все аватары вокруг без ограничений. В первый же день мне продемонстрировали, почему не стоило этого делать 🚬

Выход версии Wan-Streamer v0.3

Н@GreenNeuralRobotsAI-инженер
3 мес

История стартапа Hour One: от инвестиций до продажи Wix

С@startupofthedayавтор про «startups»
3 мес

Alibaba обновила Wan-Streamer до версии v0.2 — realtime AI-аватар с более высоким разрешением

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 мес назад

Wan Team (Alibaba) выпустила версию v0.2 экспериментальной модели Wan-Streameri — системы для общения с AI-аватаром в реальном времени, которая одновременно «видит», «слышит», «думает», говорит и генерирует видео прямо во время стрима.

Основное изменение — рост разрешения с 192×336 до 640×368 при сохранении прежней скорости генерации (25 FPS), а также расширение формата: теперь модель работает не только с крупными планами говорящих лиц, но и со сценами среднего плана, где важна общая картина взаимодействия — мимика, взгляд, жесты рук и контекст остаются различимыми в реальном времени.

640×368новое разрешение видео в v0.2
192×336разрешение предыдущей версии
25 FPSчастота кадров в реальном времени

Полный разбор →

Это всё на сейчас.