vlmСбросить фильтр ×

System One: семейство видеомоделей от NJU и JD.com

Н@GreenNeuralRobotsAI-инженер
1 нед
VideoJev Адаптировали #rlcd #decision для понимания видео Семейство открытых «System One» видеомоделей от NJU и JD.com. Объединяют временную локализацию и видео-QA через общий интерфейс оценки кандидатов — без авторегрессивного декодирования. Видео-QA до 100-129× быстрее Thinking-режима На QA качество сравнимо с бэкбонами в Thinking-режиме, но в разы быстрее. Точность высокая, но уверенность модели переоценена — calibration error ~8 пунктов Гитхаб HF #vlm MAX

GroundingPI: фундаментальная модель для визуальной локализации

Н@GreenNeuralRobotsAI-инженер
1 нед

In-context learning в обучении роботов

З@CVML_teamAI-инженер
2 нед
In context learning подход появился ещё года 2 назад. Но безумные обороты он набрал полтора-два месяца назад. Ведь это именно то что надо для простого обучения роботов. Но термин этот пока мало знает. Да, для VLM-ок я его давно использовал. Только называл "запихать побольше в промпт". А теперь это прямо мейнстрим. И для роботов он более чем оправдан. В этом видео небольшое овервью. https://youtu.be/Cj5XdeP7VtM

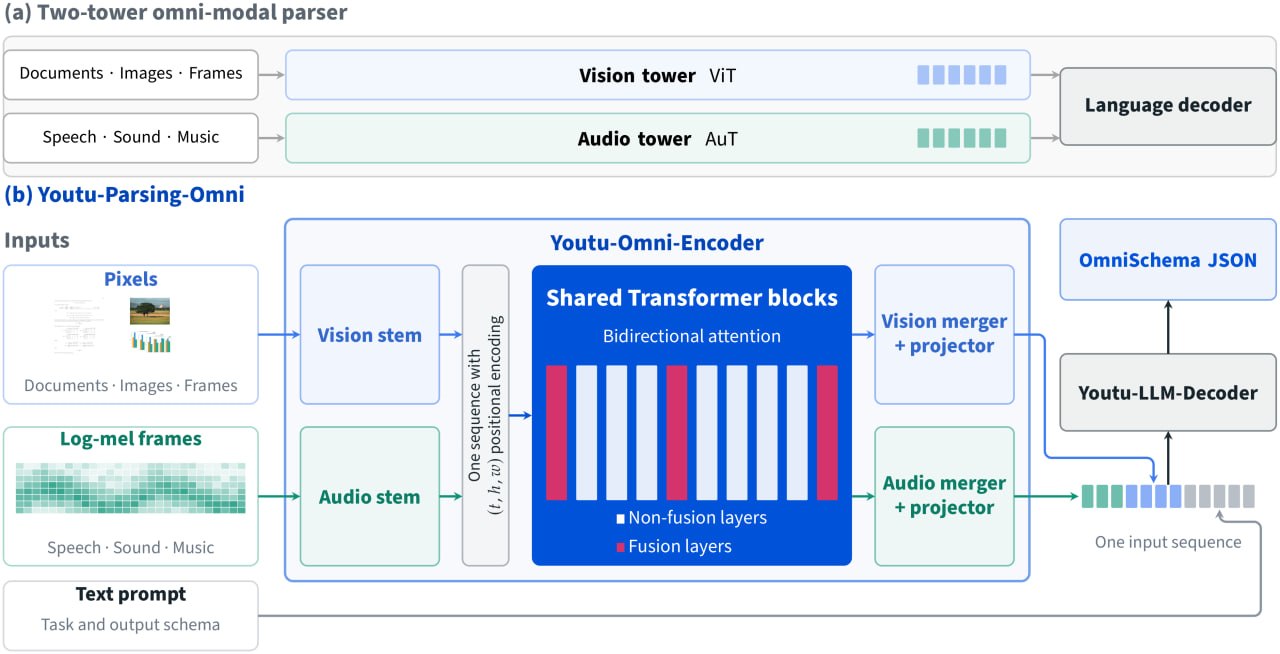
Tencent представила Youtu-Parsing-Omni: омнимодальную модель для парсинга данных

Н@GreenNeuralRobotsAI-инженер
2 нед
Tencent представила Youtu-Parsing-Omni: омнимодальную модель для парсинга данных

Дайджест материалов DeepSchool за август-сентябрь

D@deep_schoolAI-инженер
3 нед

AI RnD Day: анонсированы 10 докладов конференции

Каналы Mashkka про Data Science и Сергей Марков: машинное обучение, искусство и шитпостинг опубликовали идентичный список из 10 докладов конференции AI RnD Day со ссылкой на канал @rndml_team. Пост охватывает широкий спектр тем в области ИИ — от full-duplex моделей и работы с видео в VLMi до бенчмарков русского языка и долгосрочной омнимодальной памяти.

Это краткий анонс программы конференции без дополнительных деталей о дате, месте проведения или содержании самих докладов — только названия и имена докладчиков.

10докладов на AI RnD Day
5новых линеек бенчмарков русского языка

Полный разбор →

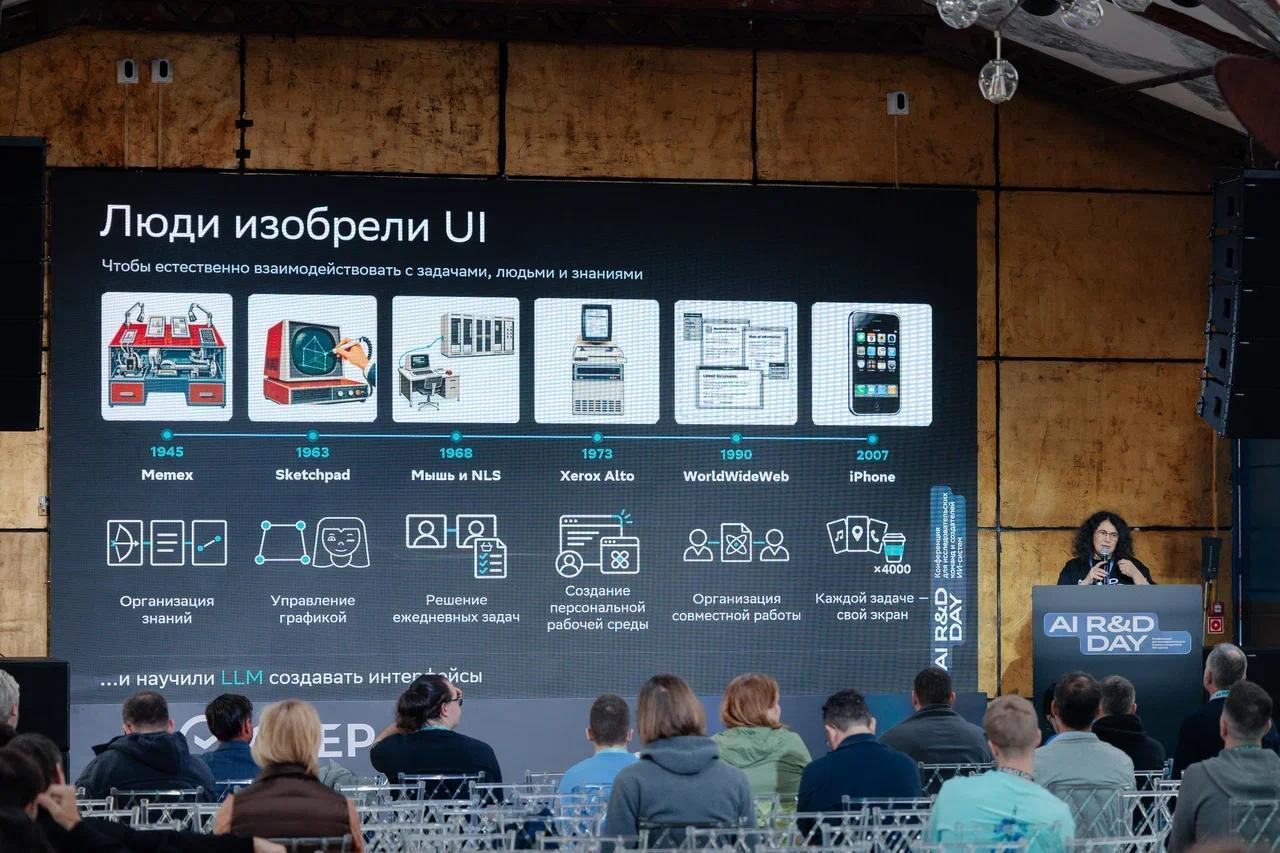
Generative UI: от генерации кода к проверяемым интерфейсам

С@oulenspiegel_channelAI-инженер
3 нед
Generative UI: от генерации кода к проверяемым интерфейсам

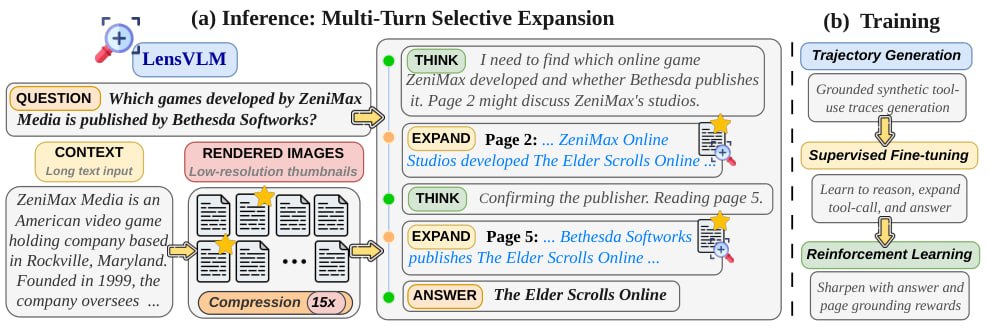
Apple представила LensVLM-9B: визуально-языковую модель для эффективной работы с документами

Н@GreenNeuralRobotsAI-инженер
1 мес
Apple представила LensVLM-9B: визуально-языковую модель для эффективной работы с документами

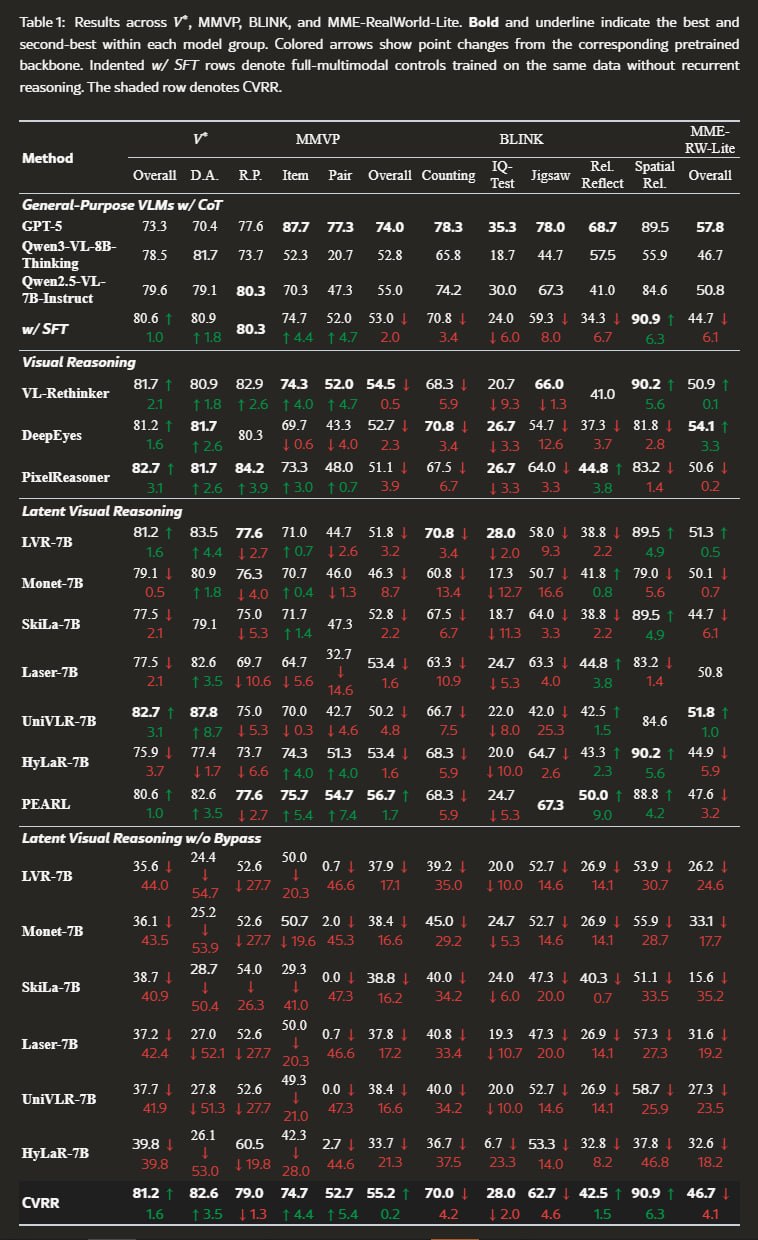
CVRR: новый метод принудительного визуального мышления для VLM

Н@GreenNeuralRobotsAI-инженер
1 мес
CVRR (DMIS-Lab — KAIST) Принудительное визуальное мышление: модель не может ответить на вопрос по картинке, не подумав скрытым состоянием, отделенным от прямого доступа к визуальным данным Обычная #VLM может жульничать — ответ приходит прямым путем из визуальных токенов. CVRR перекрывает этот обход: ответный декодер видит только рекуррентное скрытое состояние, а не оригинальные визуальные ряды. Если модель ответила — значит она действительно рассуждала через латент. - Доступны чекпоинты на Qwen2.5-VL-7B, Qwen3-VL-8B, Gemma3-4B/12B, Gemma4-12B, InternVL3-9B - Apache 2.0 Гитхаб HF VK | MAX
CVRR: новый метод принудительного визуального мышления для VLM

Qwen-Drive 1.0: Foundation Model для автономного вождения

D@datastorieslanguagesAI-инженер
1 мес

Tencent представила EVIE: визуальный ретривер документов

Н@GreenNeuralRobotsAI-инженер
1 мес
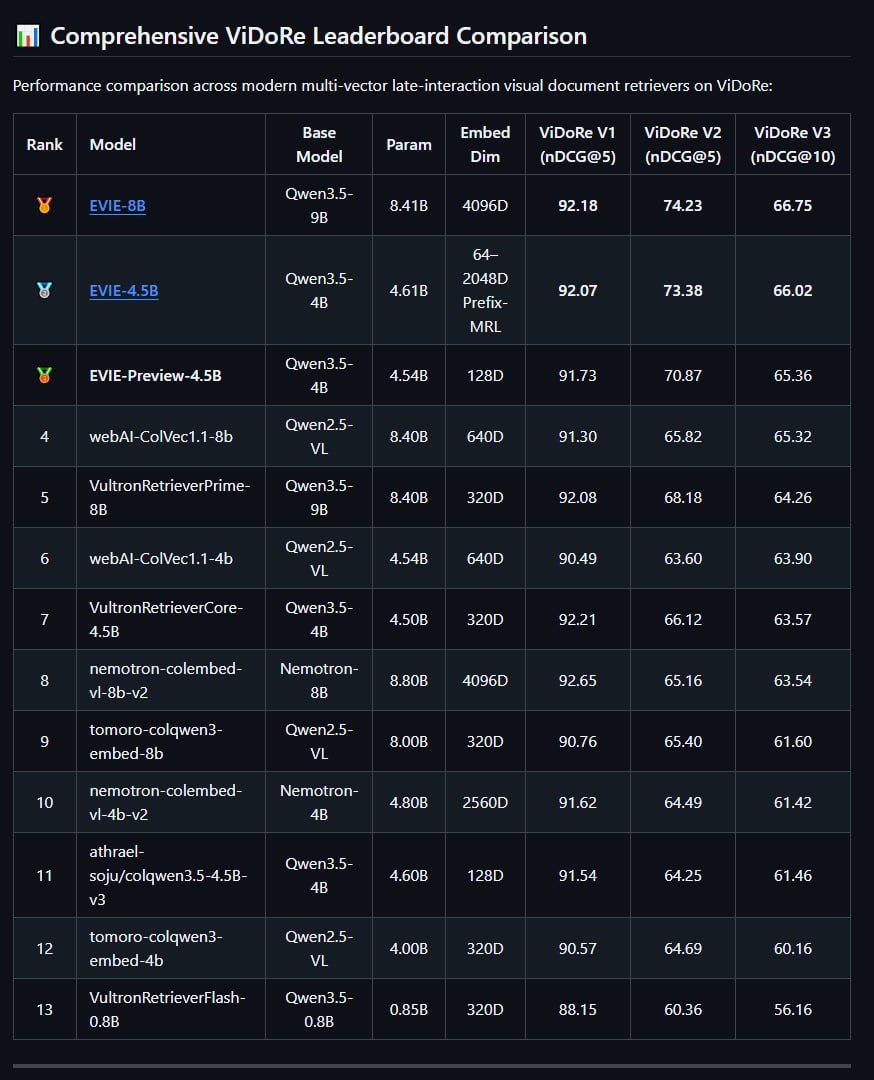
EVIE Открытый визуальный ретривер документов от Tencent. Самый точный на Hugging Face. Ищет нужные страницы PDF по смыслу и верстке, не полагаясь на #OCR Получается конкурент NeoMME - Понимает страницу целиком: текст, таблицы, графики, типографику — визуальный слой участвует в поиске - Multi-vector late-interaction: сравнивает запрос с фрагментами документа, а не только с одним эмбеддингом — точнее семантика - Apache-совместимая открытая лицензия - Две версии: EVIE-8B и EVIE-4.5B Гитхаб #vlm VK | MAX
Tencent представила EVIE: визуальный ретривер документов

NeoMME: поиск по PDF без OCR

Н@GreenNeuralRobotsAI-инженер
1 мес
NeoMME Поиск по PDF-документам без OCR. Страницы обрабатываются как изображения, поиск учитывает верстку, таблицы, графики и типографику - Ретривер для RAG: ищет нужные страницы PDF по запросу, а не генерирует ответ - Понимает визуальную структуру — таблицы, графики, колонки, дизайн страницы. OCR выбросил бы всё это - Загрузка документа + запрос → модель возвращает релевантные страницы - 2 размера: 260M и 800M — под разное железо Демо #vlm #ocr VK | MAX

Editable Visual Design: новый подход к генерации дизайна в Codex

Н@GreenNeuralRobotsAI-инженер
1 мес
Editable Visual Design Скилл для Codex который делает дизайн иначе: не одну плоскую картинку, а редактируемый артефакт. VLM придумывает, модель-изображений рисует отдельные ассеты, кодинг-агент собирает все в HTML с настоящим текстом и слоями - Работает через два Codex-скилла: editable-design (постеры и инфографика) и html-to-pptx (конвертация в редактируемый PowerPoint) - Готовый результат: HTML + PNG + визуальный редактор + разборка слоёв - Лучше всего с GPT-5.6 на high reasoning #skill #design VK | MAX

PereStruct: модульный подход к распознаванию структуры газетных страниц

Х@habr_comмедиа / агрегатор
1 мес
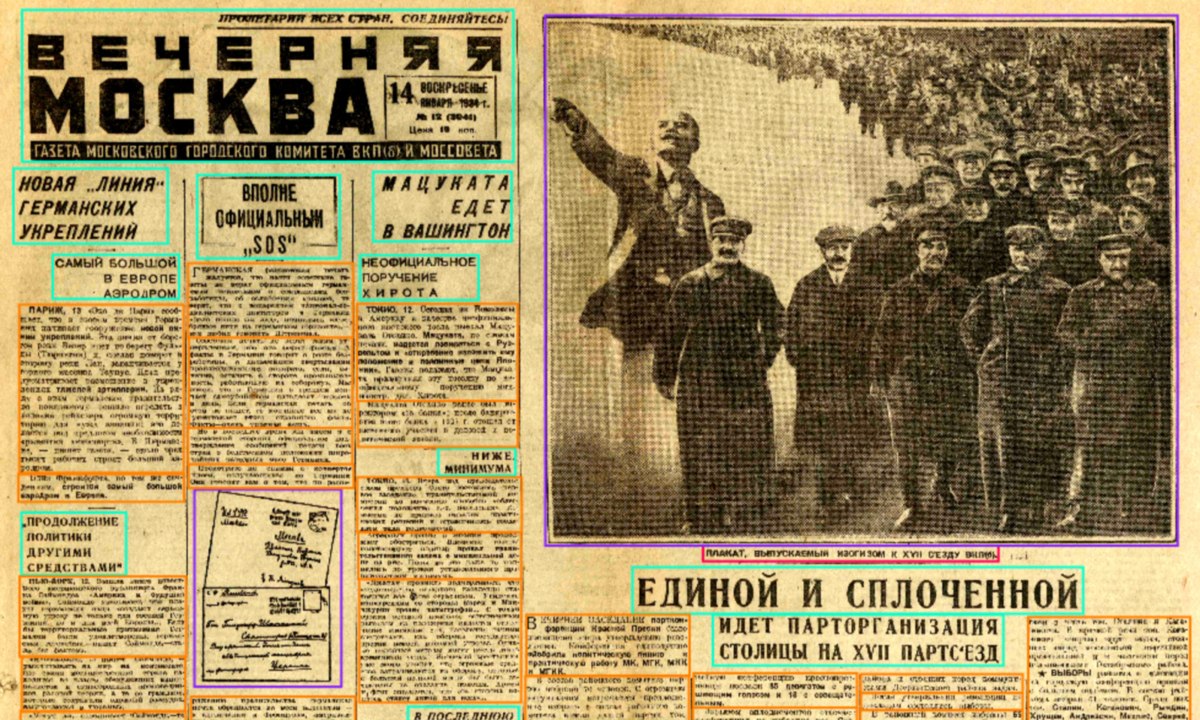
PereStruct: модульный подход к распознаванию структуры газетных страниц

DeepSeek открыла веса мультимодальной модели V4-Flash-Vision-Exp

DeepSeek опубликовала под лицензией MIT веса экспериментальной модели DeepSeek-V4-Flash-Vision-Exp — спустя 10 дней после её релиза. Модель на 305 млрд параметров построена на архитектуре V4-Flash, но дополнена визуальными модулями и дообучена на понимание изображений, чтобы получился агент, умеющий разбирать скриншоты, читать графики и работать с инструментами.

По заявлению компании и части тестировщиков (по данным vc.ru), новинка приблизилась по возможностям к Claude Opus 4.8 — на ряде бенчмарков обходит его, на других пока отстаёт.

305 млрдпараметров модели
10 днейпрошло с релиза до открытия весов
36,5балл на ApexBench у новой модели

Полный разбор →

Code as Worlds: VLM-агент для генерации физических симуляций

Н@GreenNeuralRobotsAI-инженер
1 мес
Code as Worlds VLM-агент, который пишет код симуляции физики на каждом шаге генерации видео - Смотрит видео и пишет код сцены: объекты, их свойства, отношения, правила движения, камера, освещение - Код в симуляторе проверяет как изменится сцена если поменять параметры - Композиция: можно разобрать сцену на части и менять части - Отделяет физическое состояние от внешнего вида — знает, что тяжёлый предмет не зависит от того, какого он цвета Гитхаб HF Демо #vlm #simulation #t2v #physics VK | MAX

Обновление ComfyUI-QwenVL: оптимизация работы с видео

Н@GreenNeuralRobotsAI-инженер
1 мес
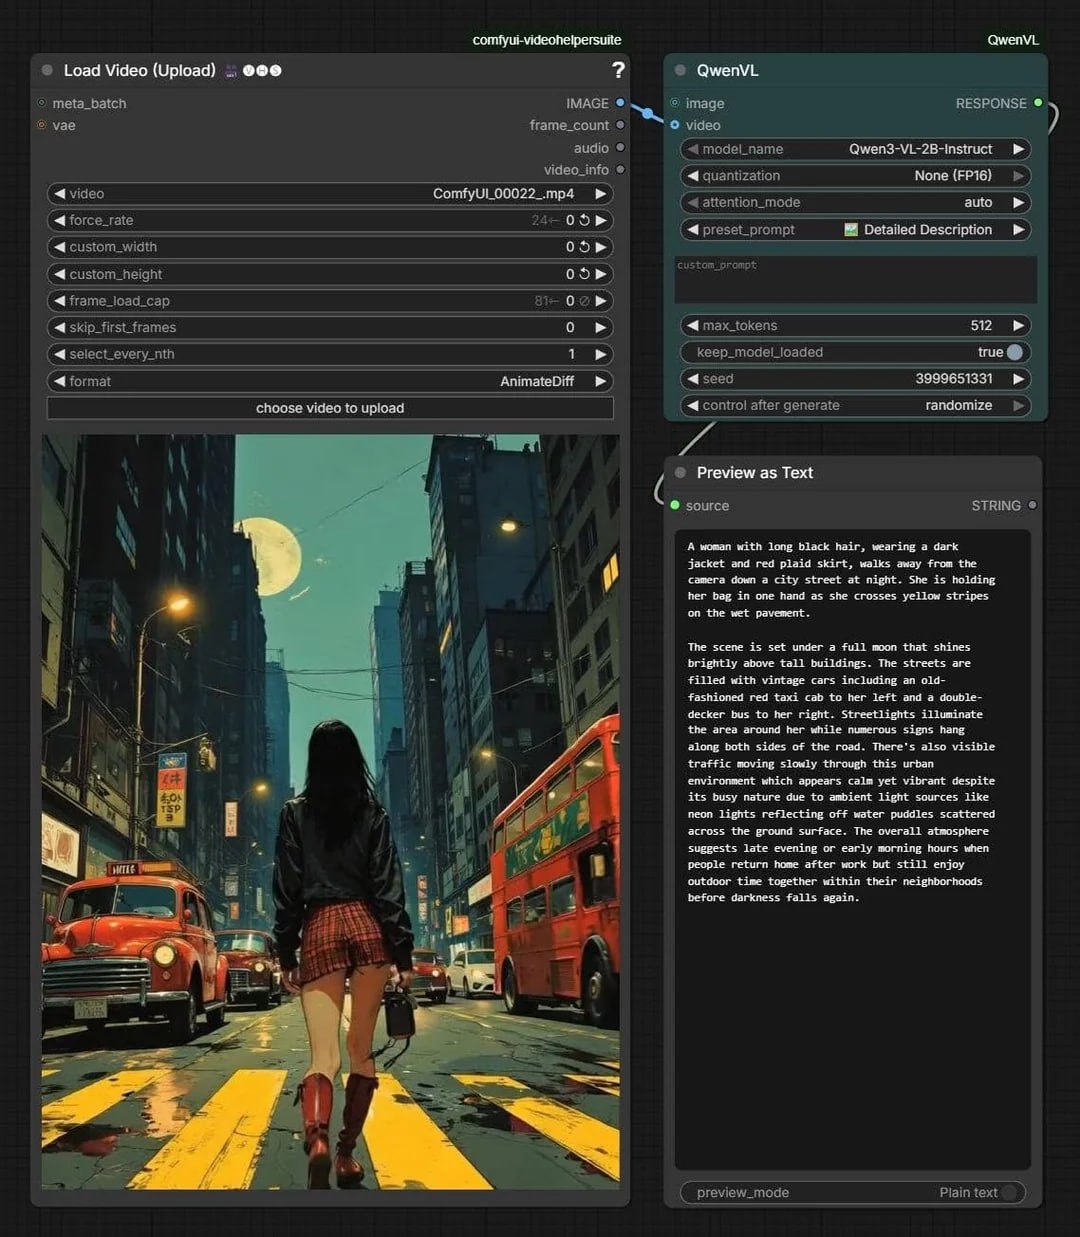
ComfyUI-QwenVL запуск Qwen-VL внутри #ComfyUI - визуальное понимание и генерация текста. Раньше при попытке скормить видео 1080p нода вылетала с OOM, теперь автоматический рассчет токенов и масштабирование кадров под контекст модели - Умное масштабирование видео: 1080p/4K автоматически поджимается под безопасный бюджет токенов — 16-32 кадра без вылета - Маленькие видео (480p) не трогает — идут в оригинале - Можно переопределить вручную через dropdown: auto, 384, 448, 512, 768, original Работает с GGUF (llama.cpp) и Transformers (Hugging Face) #vlm VK | MAX
Обновление ComfyUI-QwenVL: оптимизация работы с видео

Алиса AI научилась распознавать рукописный текст, даже когда буквы слились в закорючки

Яндекс представил обновление голосового помощника Алиса AIi: теперь он умеет распознавать рукописный текст с фотографий — от студенческих конспектов до врачебных рецептов. Возможность появилась благодаря новой VLM-модели (vision-language model, модель, объединяющая распознавание изображений и текста).

Чтобы продемонстрировать возможности технологии, в Москве появились плакаты, на которых буквы «И», «ш», «л» и «м» написаны физически одинаково и слипаются в сплошную волну — различить их человеку можно только по смыслу фразы. Алиса AI при этом выдаёт с фото корректно распознанный текст даже на такой слитной скорописи.

Полный разбор →

Google DeepMind представили TIPS: модель для пространственного понимания изображений

Н@GreenNeuralRobotsAI-инженер
2 мес
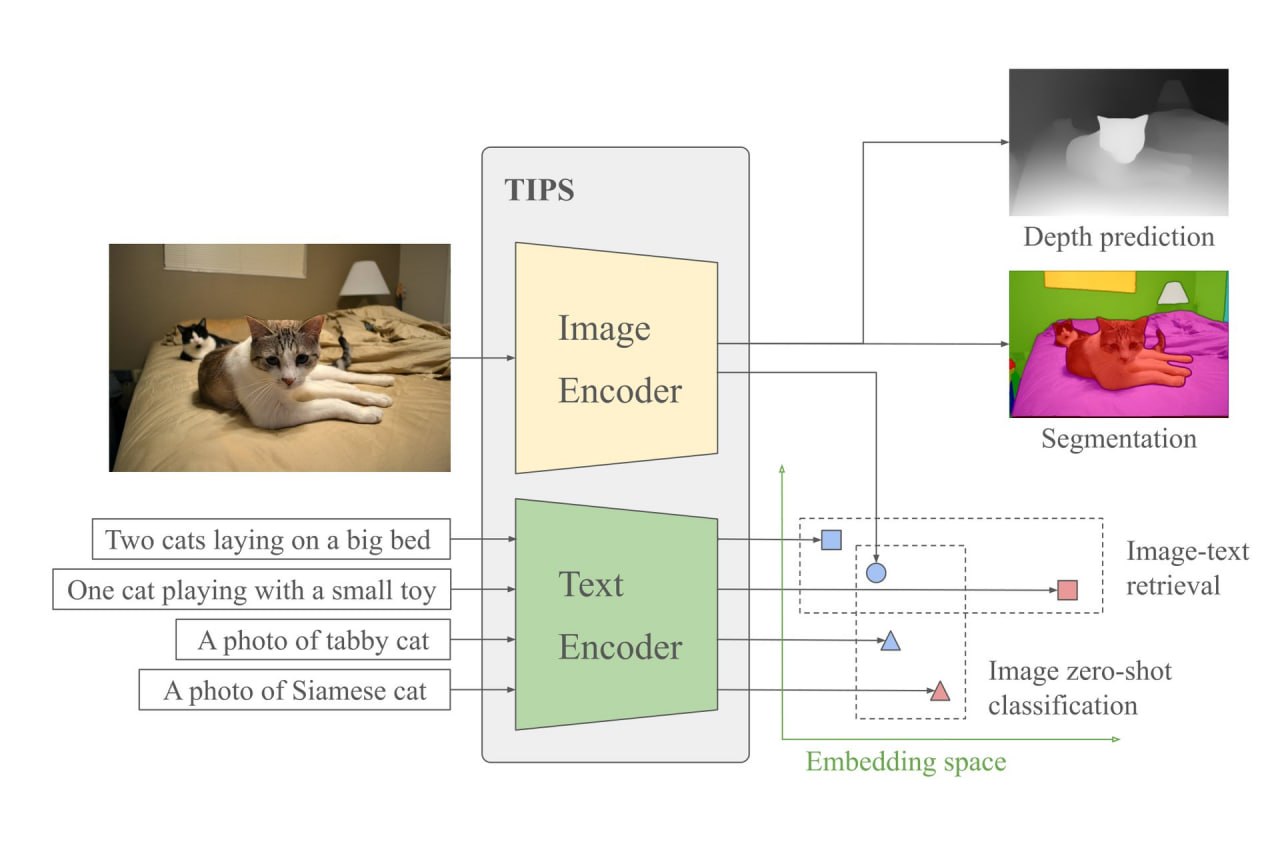
Google DeepMind представили TIPS: модель для пространственного понимания изображений

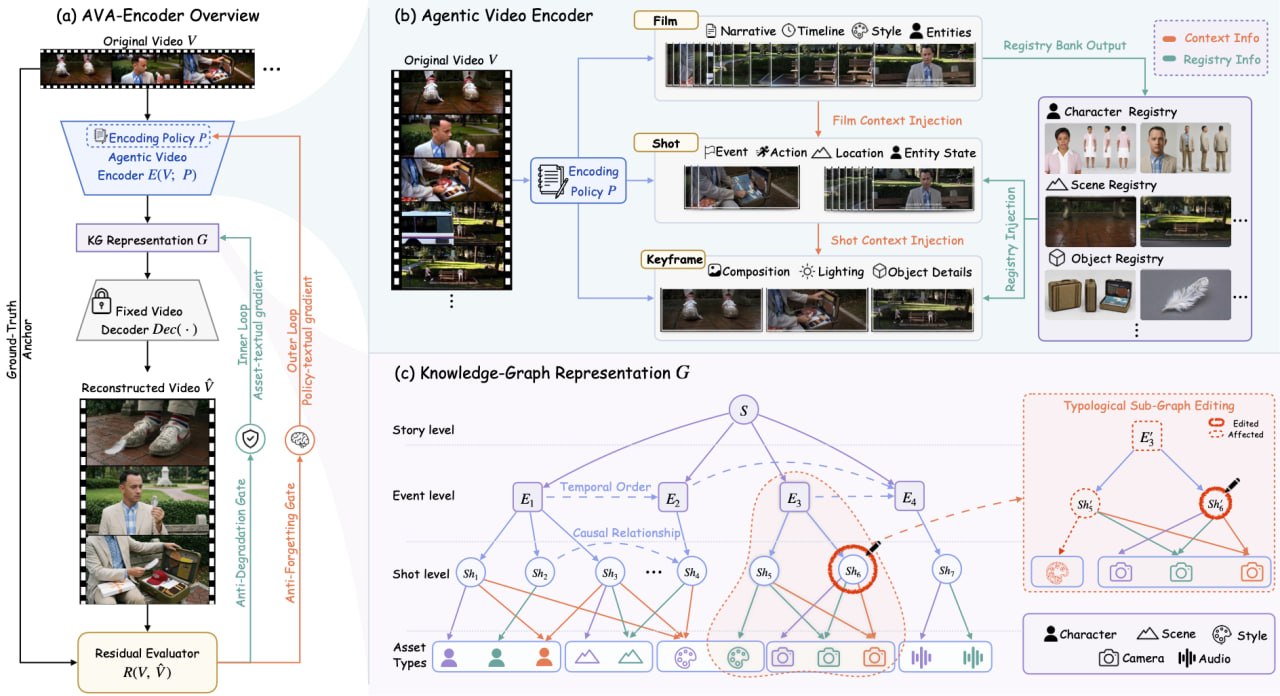
AVA-Encoder: система графов знаний для видеогенерации от Qwen

Н@GreenNeuralRobotsAI-инженер
2 мес
AVA-Encoder: система графов знаний для видеогенерации от Qwen

MOSS-VL: открытая визуально-языковая модель с реалтайм-стримингом

Н@GreenNeuralRobotsAI-инженер
2 мес
MOSS-VL Семейство открытых визуально-языковых моделей от OpenMOSS. Флагманская фишка - реалтайм-стриминг: модель смотрит на входящие кадры и отвечает параллельно, не дожидаясь конца видео модель живёт в настоящем времени, а не смотрит запись постфактум. Вместо внешних планировщиков и опроса раз в секунду - три встроенных поведения: ответ в любой момент, проактивное молчание, своевременная коррекция. • 11B параметров, контекст 256K • Кванты FP8 и NF4 Гитхаб HF Демо #vlm #realtime #fp8 #nf4 #dialog #interactive VK | MAX

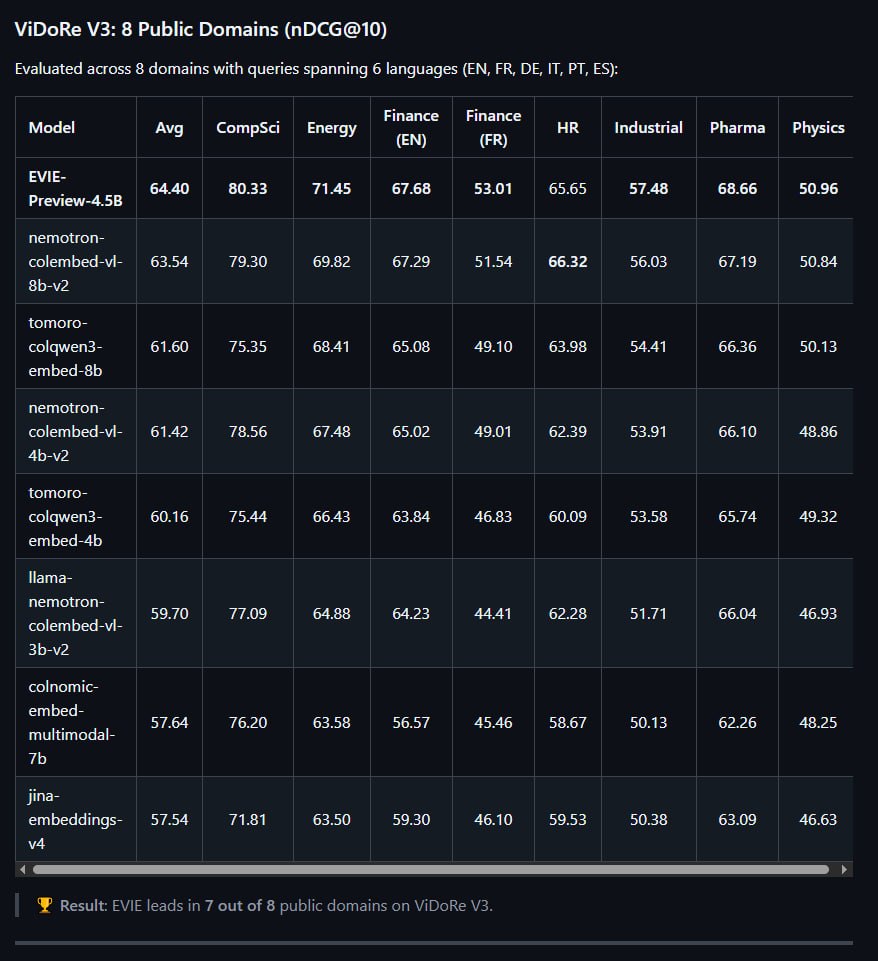
Tencent представила модель EVIE-Preview-4.5B для визуального поиска по документам

Н@GreenNeuralRobotsAI-инженер
2 мес
EVIE-Preview-4.5B Модель Tencent для визуального поиска по документам на базе Qwen3.5-4B ищет релевантные страницы по запросу, глядя на картинки, а не на извлечённый текст. Эмбеддинги ультракомпактные, 128 измерений на токен, отсюда низкие требования к памяти и быстрый поиск. • Поиск по сканам, PDF, таблицам, диаграммам и отчётам без OCR • Мультиязычность - EN, FR, DE, IT, ES, PT, ZH и другие • Zero-shot на новых языках и форматах #SOTA на ViDoRe • Обходит 8B модели, будучи вдвое меньше Гитхаб HF #vlm #search #ocr VK | MAX
Tencent представила модель EVIE-Preview-4.5B для визуального поиска по документам

Cohere Labs представила компактную VLM North Micro Vision

2 мес
Cohere Labs представила компактную VLM North Micro Vision

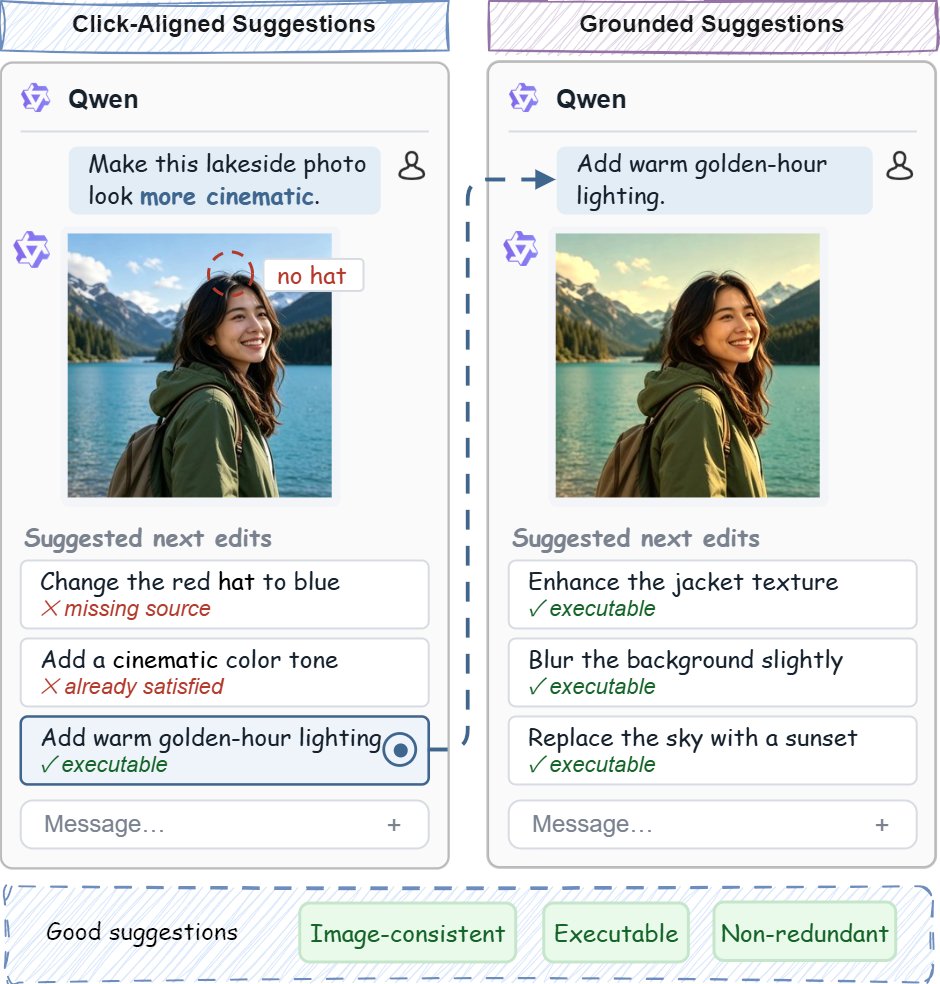
Alibaba представила фреймворк для рекомендаций правок в генерации изображений

Н@GreenNeuralRobotsAI-инженер
2 мес
What to Edit Next Фреймворк от Alibaba для рекомендаций следующих правок в чате по генерации картинок. После каждой итерации подсказывает, что отредактировать дальше - чтобы совет был уместным, разнообразным и выполнимым на текущем изображении. На базе Qwen3-VL-8B кода-весов нет #research #vlm
Alibaba представила фреймворк для рекомендаций правок в генерации изображений

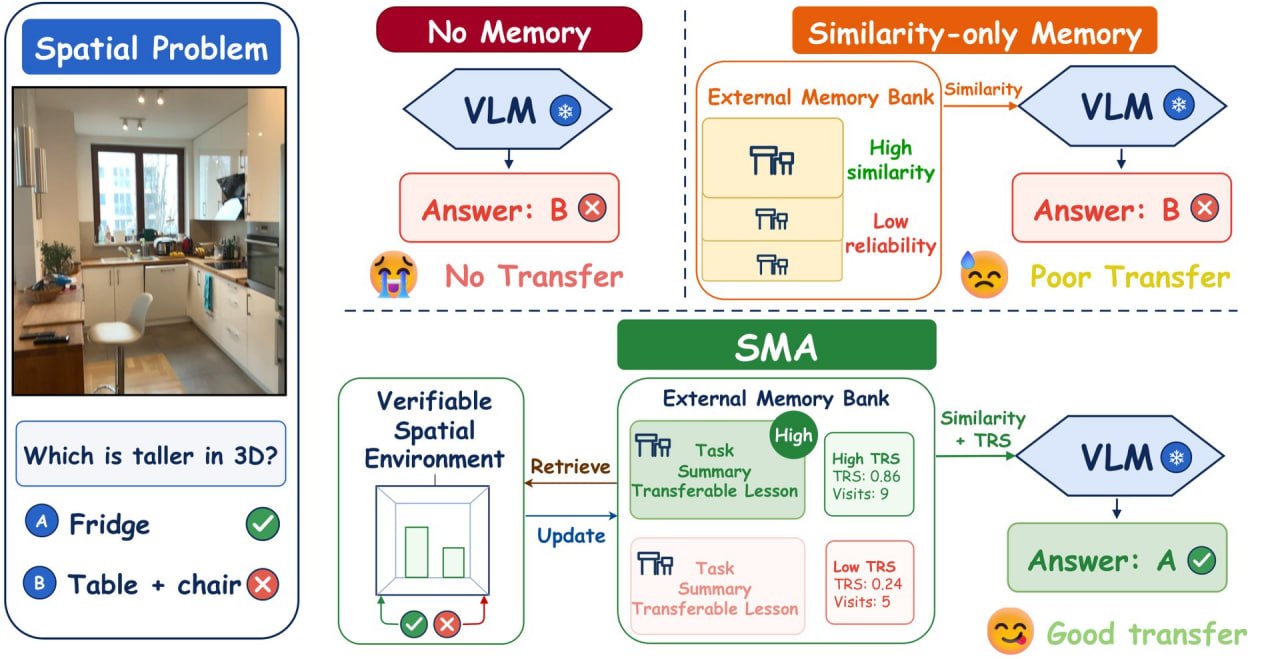
Spatial Memory Agent: улучшение пространственного мышления VLM

Н@GreenNeuralRobotsAI-инженер
2 мес
Spatial Memory Agent Фреймворк для улучшения пространственного мышления VLM без дообучения. Замороженная модель сама улучшает рассуждения, превращая проверенный опыт в переносимые уроки. • Самоэволюция без обновления параметров и внешних пространственных инструментов • Дистилляция проверенного опыта в компактные карточки памяти • Перенос памяти между моделями и бенчмарками Прикручено к Qwen3.5-9B, Qwen3.6-27B, Qwen3.6-35B-A3B, Qwen3.5-122B-A10B Код ждем #vlm
Spatial Memory Agent: улучшение пространственного мышления VLM

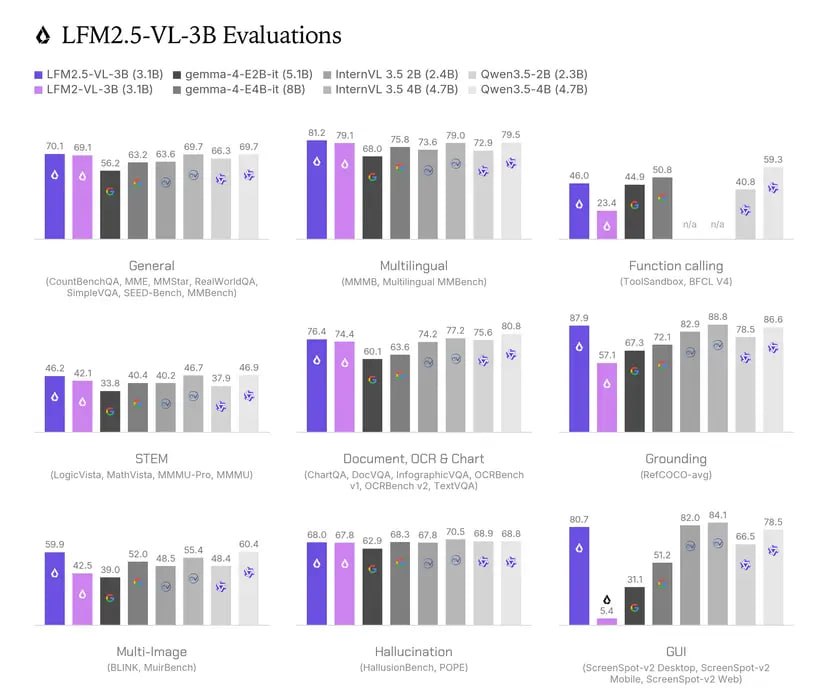
Liquid AI представила мультимодальную модель LFM2.5-VL-3B

Н@GreenNeuralRobotsAI-инженер
2 мес
Liquid AI представила мультимодальную модель LFM2.5-VL-3B

RE-GoT: эволюция вознаграждений через графы мыслей

T@kryak_startupAI-инженер
2 мес
RE-GoT: эволюция вознаграждений через графы мыслей
Ещё ↓