Tencent представила Youtu-Parsing-Omni: омнимодальную модель для парсинга данных
Н@GreenNeuralRobotsAI-инженер
2 недTencent выпустила Youtu-Parsing-Omni, 5B модель для преобразования документов, аудио, видео и графики в структурированный JSON.
Универсальный инструмент для автоматизации обработки неструктурированных данных.
- Позволяет переводить сложные форматы (чертежи, аудио, видео) в машиночитаемый JSON.
- Оптимизирована для работы с 5B параметров, что делает её доступной для локального запуска.
- Упрощает создание пайплайнов для анализа документов и мультимедиа.
Youtu-Parsing-Omni
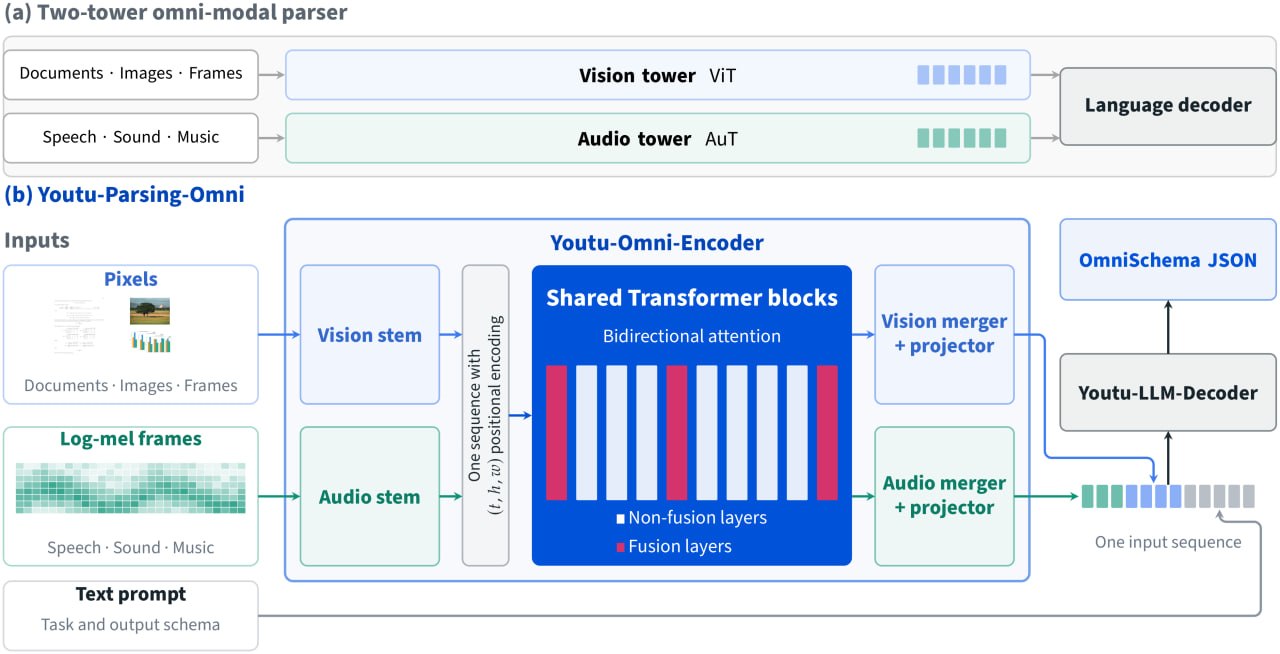
Компактная омнимодальная парсинг-модель от Tencent: один 5B трансформер превращает в структурированный JSON почти что угодно — документ, картинку, график, чертеж, аудио и видео.
• Парсинг документов: лейаут, текст, таблицы, формулы, порядок чтения
• Картинки, графики, блок-схемы, геометрические фигуры
• Аудио: ASR, спикеры, сцены, акустические события
• Видео: кадры, OCR+ASR, отчёт о клипе
• Один унифицированный JSON-конверт для семи семейств задач
• Распознавание химструктур (ChemOCR) и нот (PDMX)
• 5B параметров, один энкодер на все модальности
• #SOTA на OmniDocBench v1.6 (96.96)
• Лучшая опенсорс на OmniParsingBench (75.08), после Gemini-3-Pro
• vLLM-плагин для быстрого сервинга
github.com/TencentCloudADP/youtu-parsing
learn2play.fun
#omnimodal #multimodal #any2json #vlm #alm
MAX
Кратко (AI)
Tencent представила Youtu-Parsing-Omni — компактную омнимодальную модель с 5 млрд параметров, способную преобразовывать различные типы данных (документы, аудио, видео, графики) в единый формат JSON. Модель демонстрирует высокие показатели в бенчмарках и поддерживает интеграцию с vLLM для ускоренного развертывания.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖