multimodalСбросить фильтр ×

Выпуск мультимодальных моделей MiniCPM-V 4.7 для мобильных устройств

Н@GreenNeuralRobotsAI-инженер
1 нед
Выпуск мультимодальных моделей MiniCPM-V 4.7 для мобильных устройств

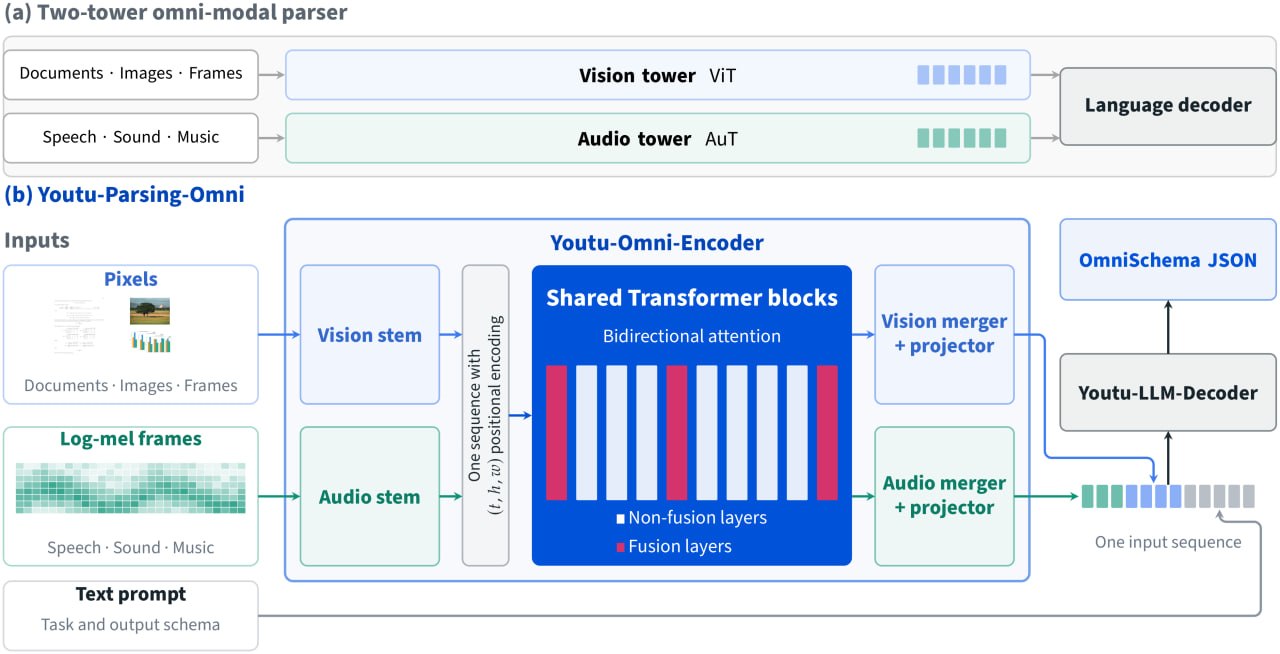
Tencent представила Youtu-Parsing-Omni: омнимодальную модель для парсинга данных

Н@GreenNeuralRobotsAI-инженер
2 нед
Tencent представила Youtu-Parsing-Omni: омнимодальную модель для парсинга данных

Google выпустила EmbeddingGemma 2 — мультимодальную модель эмбеддингов для поиска прямо на устройстве

Google представила EmbeddingGemma 2 — открытую модель, которая переводит текст, код, изображения, видео и аудио в единое векторное пространство. Это позволяет искать нужный кадр в видео по голосовой заметке, находить фото по текстовому описанию или искать по аудиозаписям текстом — всё локально, без отправки данных в облако.

Модель построена на Gemma 4i и работает даже на смартфонах: по данным Google, на Pixel 11 Pro полная модель потребляет около 567 МБ активной RAM. В отличие от первой версии EmbeddingGemma, которая работала только с текстом, вторая версия мультимодальна и, по заявлению Google, показывает лучший результат среди мультимодальных эмбеддеров до 1 млрд параметров.

740 млнпараметров модели
8K токеновразмер контекста
567 МБRAM на Pixel 11 Pro для полной модели
Полный разбор →

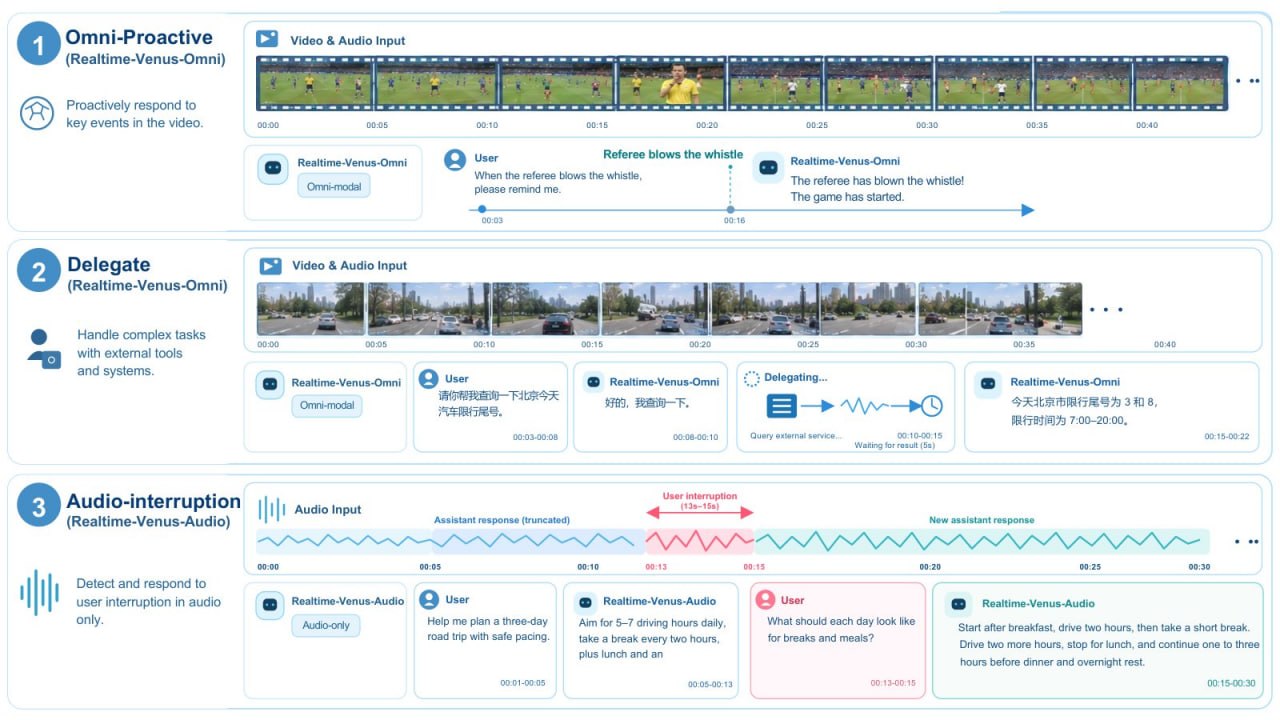
Представлена модель Realtime-Venus с поддержкой аудио-видео дуплекса

Н@GreenNeuralRobotsAI-инженер
1 мес
Представлена модель Realtime-Venus с поддержкой аудио-видео дуплекса

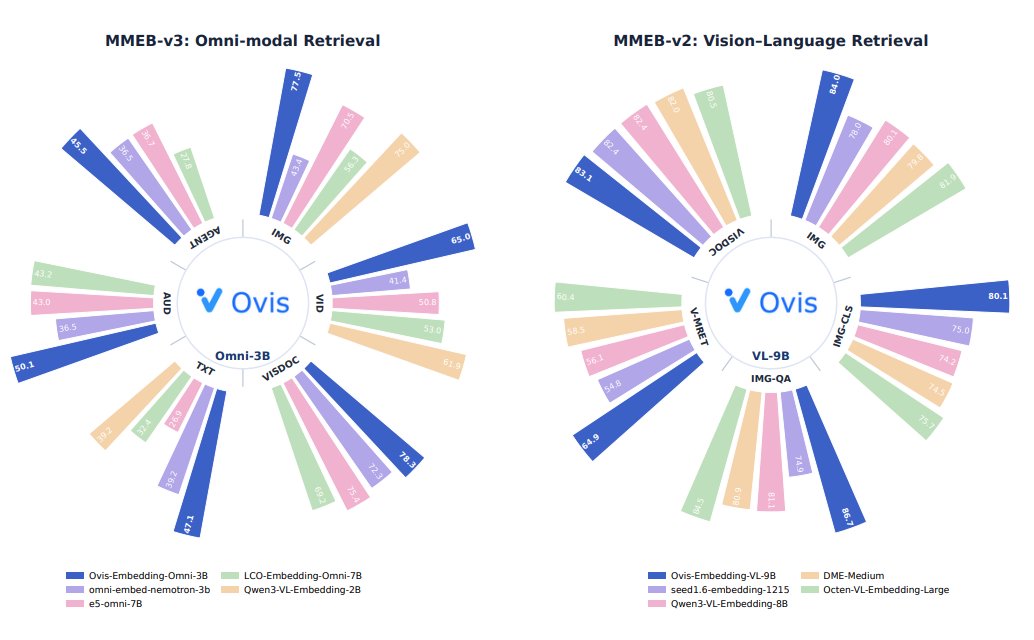
Ovis-Embedding: универсальные мультимодальные эмбеддинг-модели

Н@GreenNeuralRobotsAI-инженер
1 мес
Ovis-Embedding: универсальные мультимодальные эмбеддинг-модели

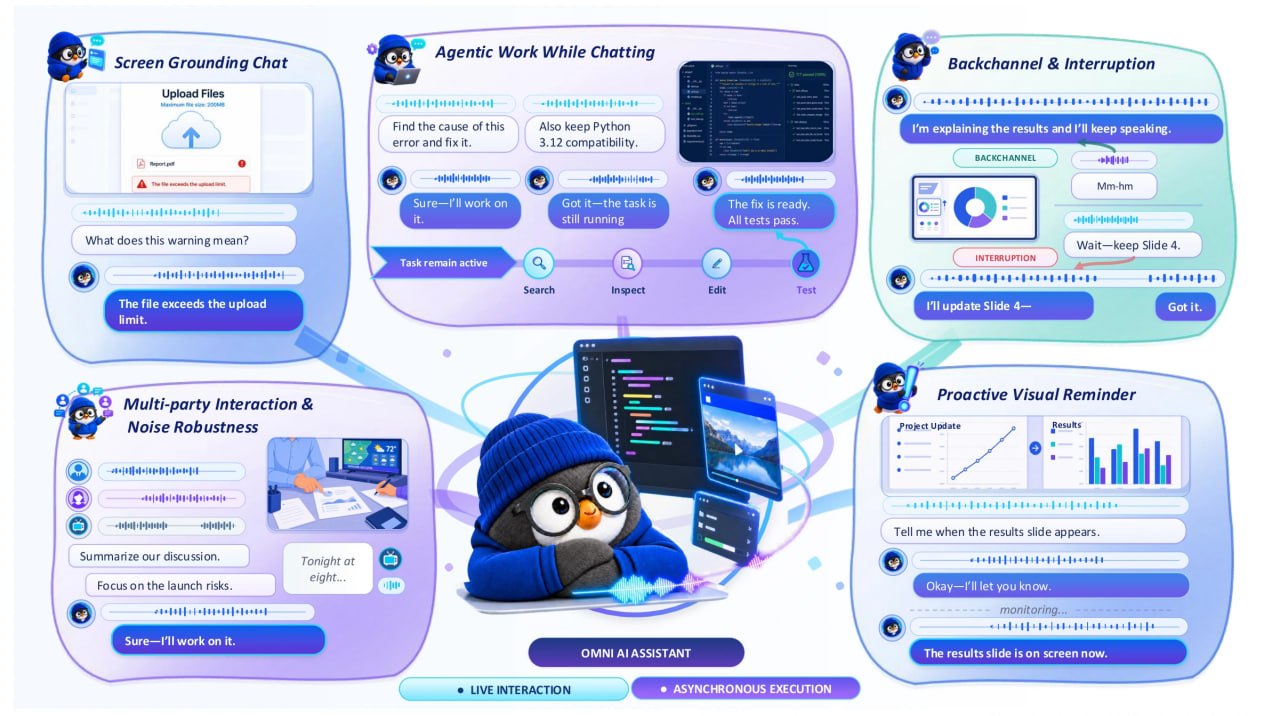
Анонс Gander: мультимодальный агент на базе MiniCPM-o 4.5

Н@GreenNeuralRobotsAI-инженер
1 мес
Gander (Tencent Hunyuan + openbmb) Агент который смотрит, слушает, говорит и работает одновременно, в реальном времени, в одной открытой модели. Пока Gander отвечает, он видит экран, слышит тебя, различает "ага, продолжай" и "стоп, дай сказать" Может параллельно запускать долгие задачи. Apache 2.0 На базе MiniCPM-o 4.5 - Full-duplex - Видит то, что ты видишь: экран, видео, камера. Может комментировать, отвечать на вопросы, реагировать на события - Помнит о чем его просили Гитхаб HF #agent #dialog #interactive VK | MAX
Анонс Gander: мультимодальный агент на базе MiniCPM-o 4.5

SenseNova-Vision: мультимодальная модель для компьютерного зрения

Н@GreenNeuralRobotsAI-инженер
3 мес
SenseNova‑Vision Мультимодальная генеративная модель для компьютерного зрения (7B, MoT) • решает сразу несколько задач без отдельных голов под каждую: детекция, OCR, сегментация, ключевые точки, нормали, глубина, поза камеры • принимает инструкции на естественном языке • генерирует текст, изображения или смешанные выходы • единый подход вместо набора узкоспециализированных моделей Гитхаб HF Демо #vlm #multimodal #t2i #i2t #detection #segmentation #image2depth #image2normals

Это всё на сейчас.