Google выпустила мультимодальную EmbeddingGemma 2
D@data_secretsAI-инженер
3 недGoogle представила EmbeddingGemma 2 — мультимодальную модель для создания эмбеддингов, работающую с текстом, кодом, изображениями, аудио и видео.
Новый инструмент от Google упрощает работу с мультимодальными данными в AI-системах.
- Модель позволяет объединять текст, код, изображения и аудио в единое векторное пространство.
- Модульная архитектура позволяет оптимизировать использование ресурсов, загружая только нужные энкодеры.
- Открытая лицензия Apache 2.0 делает модель доступной для широкого использования в коммерческих и исследовательских проектах.
Google выпустила мультимодальную EmbeddingGemma 2
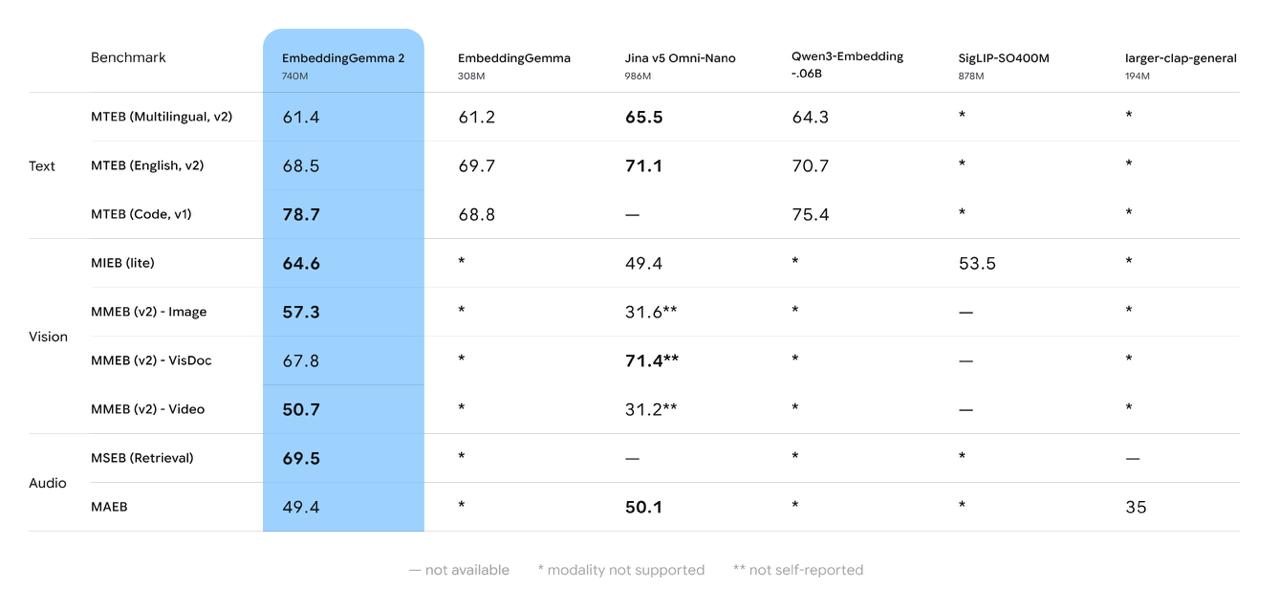
Первая версия работала только с текстом, вторая построена на Gemma 4 и переводит в одно векторное пространство текст, код, изображения, видео и аудио. Так что на вход теперь можно подавать и смешанные данные.
Модель весит 740M параметров, но устроена модульно. Текстовая часть занимает 270M, а энкодеры изображений и аудио загружаются отдельно при необходимости. Контекст вырос до 8K токенов, это около 5,5 минут аудио или 29 картинок за раз.
На текстовых задачах качество осталось на уровне первой версии, а на коде заметно выросло. Google заявляет, что среди мультимодальных эмбеддеров до 1B параметров это лучший результат.
Веса открыты под Apache 2.0.
https://blog.google/innovation-and-ai/technology/developers-tools/embeddinggemma-2/
Кратко (AI)
Google представила EmbeddingGemma 2, мультимодальную модель для создания векторных представлений данных. Она поддерживает текст, код, изображения, аудио и видео, обладая модульной архитектурой и контекстным окном в 8K токенов.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖