Ovis-Embedding: универсальные мультимодальные эмбеддинг-модели
Н@GreenNeuralRobotsAI-инженер
1 месПредставлены универсальные эмбеддинг-модели Ovis-Embedding для работы с текстом, изображениями, аудио и видео в едином пространстве.
Новые модели позволяют искать информацию в разных типах данных (текст, фото, видео) с помощью одного инструмента.
- Упрощает создание систем поиска и RAG для мультимодальных данных.
- Позволяет сжимать эмбеддинги до 128 измерений для экономии ресурсов при деплое.
- Модели распространяются под лицензией Apache 2.0, что удобно для коммерческого использования.
Ovis-Embedding
Универсальные эмбеддинг-модели для всего сразу: текст, изображения, документы, видео, аудио и смешанные входы в одном пространстве представлений
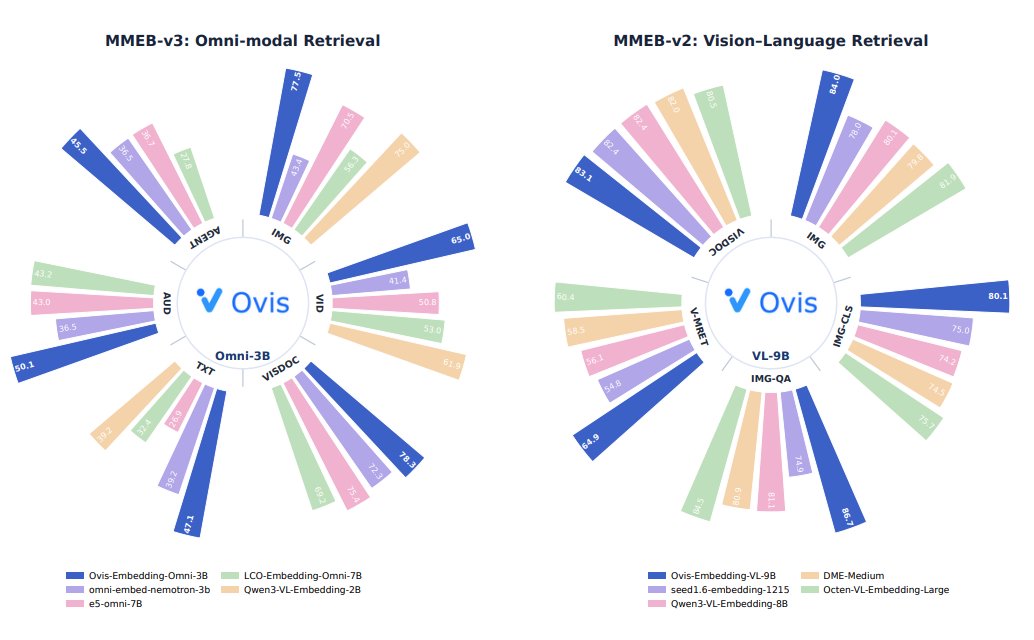
• Omni-Embedding-3B - база на Qwen2.5-Omni, any-to-any поиск одним энкодером
• VL-Embedding 2B и 9B - для текста и изображений, документов
• любые задачи ретрива: поиск, RAG, рекомендации, ретрив инструментов для агентов
• сжатие эмбеддингов до 128 измерений для ограниченных деплоев
• эмбеддинг - хидден-стейт последнего токена, без проекционных голов
• выход 2048 измерений, сжимается до 1024/512/256/128
• Apache 2.0
На бенчмарке MMEB-v3 (190 датасетов) обходит сильнейший байзлайн на 5.19 балла во всех модальностях
Гитхаб
HF
#multimodal #embedding
MAX
Кратко (AI)
Выпущены новые мультимодальные эмбеддинг-модели Ovis-Embedding, поддерживающие обработку текста, изображений, аудио и видео. Модели базируются на архитектуре Qwen2.5-Omni и показывают преимущество в 5.19 балла на бенчмарке MMEB-v3 по сравнению с существующими решениями.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖