PereStruct: модульный подход к распознаванию структуры газетных страниц
Х@habr_comмедиа / агрегатор
1 месРазбор PereStruct — открытого датасета и пайплайна для парсинга сложных газетных макетов, решающего проблемы галлюцинаций мультимодальных моделей.
Это решение помогает точнее оцифровывать сложные архивные документы, где обычные нейросети часто ошибаются.
- Модульный подход позволяет проверять каждый этап обработки документа отдельно.
- Снижается риск появления «галлюцинаций» и склеивания несвязанных фрагментов текста.
- Полезно для разработчиков систем распознавания текста и архивистов.
Где VLM не читали старых газет: разбираем PereStruct, открытый датасет и модульный парсер
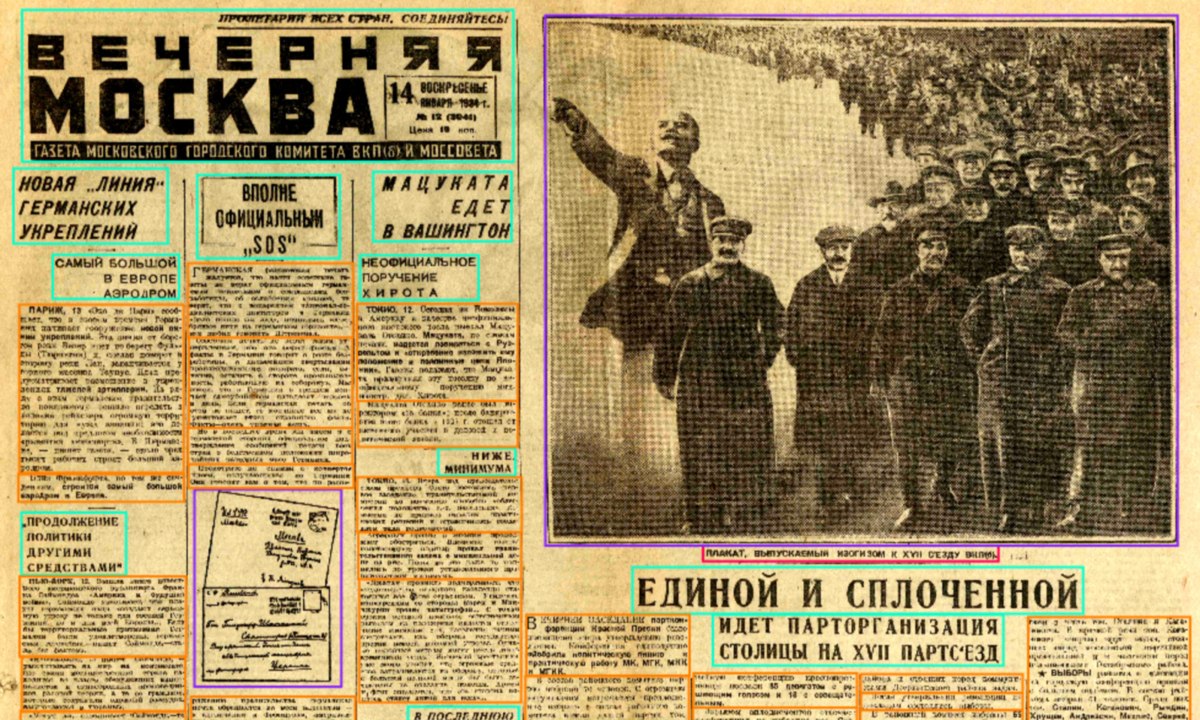
Откройте скан советской газеты. Глаз сам находит крупный заголовок, ведёт к продолжению в соседней колонке, отличает подпись под фотографией от основного текста. Для алгоритма перед ним выцветшая страница с десятками тесно расположенных прямоугольников, нестандартными шрифтами и неоднозначным порядком чтения.
Казалось бы, тут и пригодится большая мультимодальная модель, которой можно отдать картинку страницы и сразу получить готовый текст. Один запрос вместо детектора, распознавания и сборщика структуры. На деле такая модель дописывает несуществующий текст, зацикливает фразы и склеивает соседние статьи в одну.
Авторы PereStruct пошли другим путём и собрали пайплайн из отдельных узких компонентов, каждый со своей проверяемой задачей.
Кратко (AI)
Авторы проекта PereStruct представили решение для распознавания структуры газетных страниц, отказавшись от использования одной большой мультимодальной модели в пользу модульного пайплайна. Это позволяет избежать типичных проблем VLM, таких как галлюцинации, зацикливание текста и некорректная сборка структуры документа.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖