CVRR: новый метод принудительного визуального мышления для VLM
Н@GreenNeuralRobotsAI-инженер
1 месИсследователи из KAIST представили CVRR — метод, заставляющий VLM рассуждать через скрытое состояние, исключая прямой доступ к визуальным данным.
Этот метод делает работу нейросетей с изображениями более логичной и прозрачной.
- Исключает возможность «угадывания» ответа моделью без реального анализа.
- Повышает надежность рассуждений VLM при работе со сложными визуальными задачами.
- Метод совместим с популярными открытыми моделями, что упрощает его внедрение.
CVRR (DMIS-Lab — KAIST)
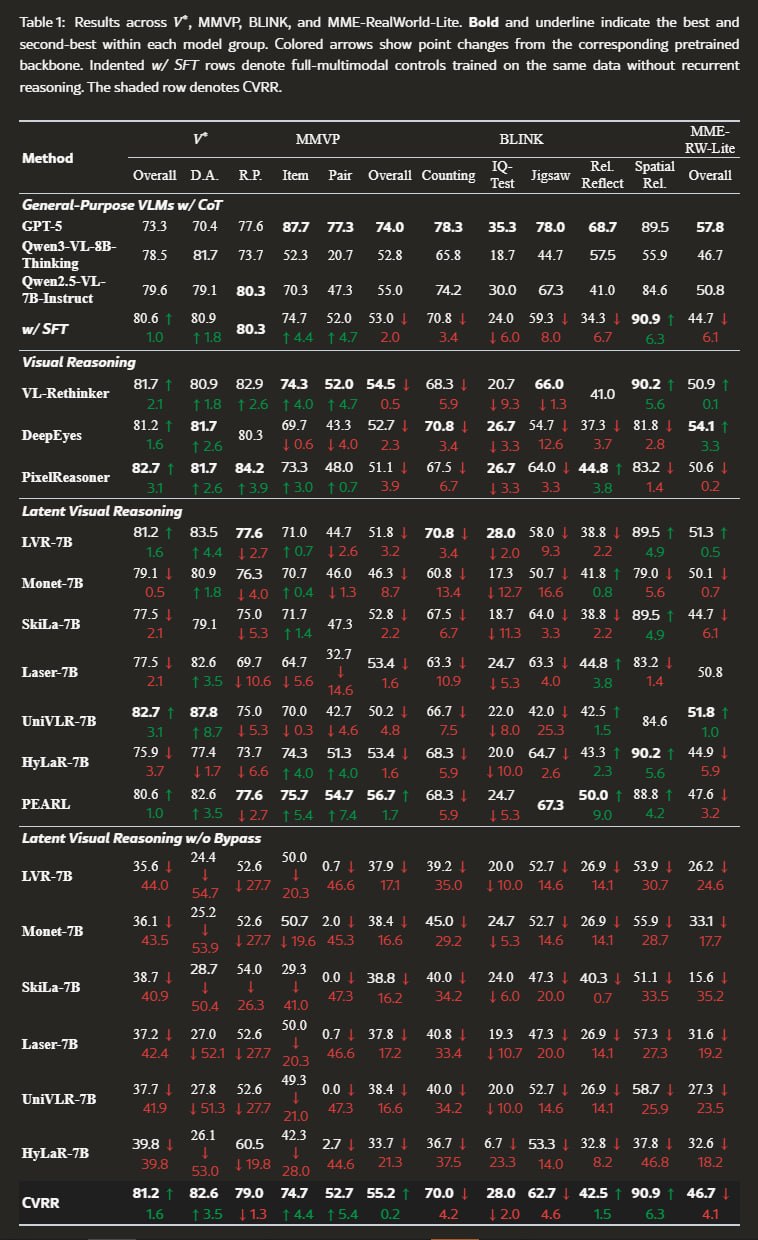
Принудительное визуальное мышление: модель не может ответить на вопрос по картинке, не подумав скрытым состоянием, отделенным от прямого доступа к визуальным данным
Обычная #VLM может жульничать — ответ приходит прямым путем из визуальных токенов. CVRR перекрывает этот обход: ответный декодер видит только рекуррентное скрытое состояние, а не оригинальные визуальные ряды. Если модель ответила — значит она действительно рассуждала через латент.
- Доступны чекпоинты на Qwen2.5-VL-7B, Qwen3-VL-8B, Gemma3-4B/12B, Gemma4-12B, InternVL3-9B
- Apache 2.0
Гитхаб
HF
VK | MAX
Кратко (AI)
Исследователи из DMIS-Lab (KAIST) представили метод CVRR, который ограничивает доступ VLM к визуальным данным при генерации ответа. Модель вынуждена использовать промежуточное скрытое состояние для рассуждений, что предотвращает «жульничество» и прямое копирование визуальных признаков. Метод доступен для ряда популярных моделей, включая Qwen и Gemma, под лицензией Apache 2.0.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖