Запуск Qwen3.8-Flash-Next 125B на 6 ГБ VRAM
Х@habr_comмедиа / агрегатор
1 месРазбор того, как удалось запустить полную версию модели Qwen3.8-Flash-Next 125B на потребительском железе с использованием всего 6 ГБ VRAM.
Это прорыв в эффективности запуска огромных нейросетей на обычном домашнем оборудовании.
- Позволяет запускать мощные модели уровня 125B без покупки дорогостоящих серверных GPU.
- Снимает ограничение VRAM как главного узкого места при работе с большими языковыми моделями.
- Демонстрирует, что архитектурные оптимизации могут быть эффективнее простого увеличения объема видеопамяти.
Как запустить Qwen3.8-Flash-Next 125B на 6 ГБ VRAM
Полный checkpoint Qwen3.8-Flash-Next в bf16 занимает около 360 ГБ на диске. Одна только вспомогательная n-gram таблица внутри модели весит 102 ГБ. По всем прикидкам такое должно требовать серверного железа или облака. А запустили её на обычной RTX 4090 с пиковым расходом VRAM 5,95 ГБ, без квантизации и дистилляции.
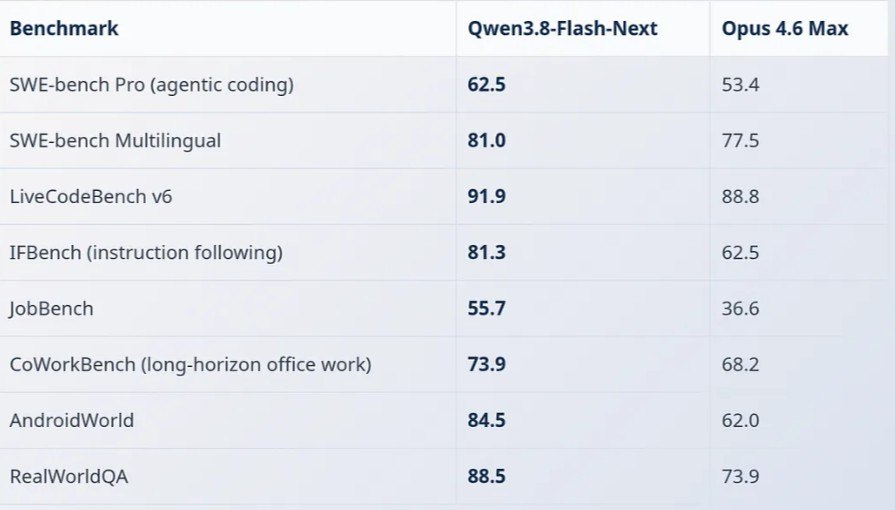
Причём это не урезанная версия ради демо. Полный checkpoint, native vision, контекст на 262K токенов, по собственным бенчмаркам Qwen конкурирует с закрытыми frontier-моделями в коде и работе с агентами. Фокус в том, что VRAM перестаёт быть узким местом, а нагрузка уходит совсем в другое место.
Кратко (AI)
Автор описывает техническую возможность запуска тяжелой модели Qwen3.8-Flash-Next 125B на обычном потребительском GPU RTX 4090. Несмотря на огромный размер чекпоинта в 360 ГБ, модель потребляет менее 6 ГБ видеопамяти без потери качества, квантования или дистилляции.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖