ggufСбросить фильтр ×

SonicBoom: C++-движок инференса без Python

HardenedVault выпустила SonicBoom — среду исполнения для локального запуска языковых моделей на потребительских процессорах и видеокартах. Движок написан на C++ и CUDA, не требует Python ни для работы, ни для сборки и предоставляет локальный сервер с API OpenAI.

В первых тестах на RTX 3050 SonicBoom быстрее llama.cpp на двух моделях при коротком контексте, но преимущество почти исчезает на глубине 512 токенов. Сторонний замер на RTX 4060 Ti показал результат ниже llama.cpp; сборка не была настроена под эту видеокарту.

RTX 3050видеокарта для тестов
512 токеновглубина контекста
RTX 4060 Tiсторонний тест

Полный разбор →

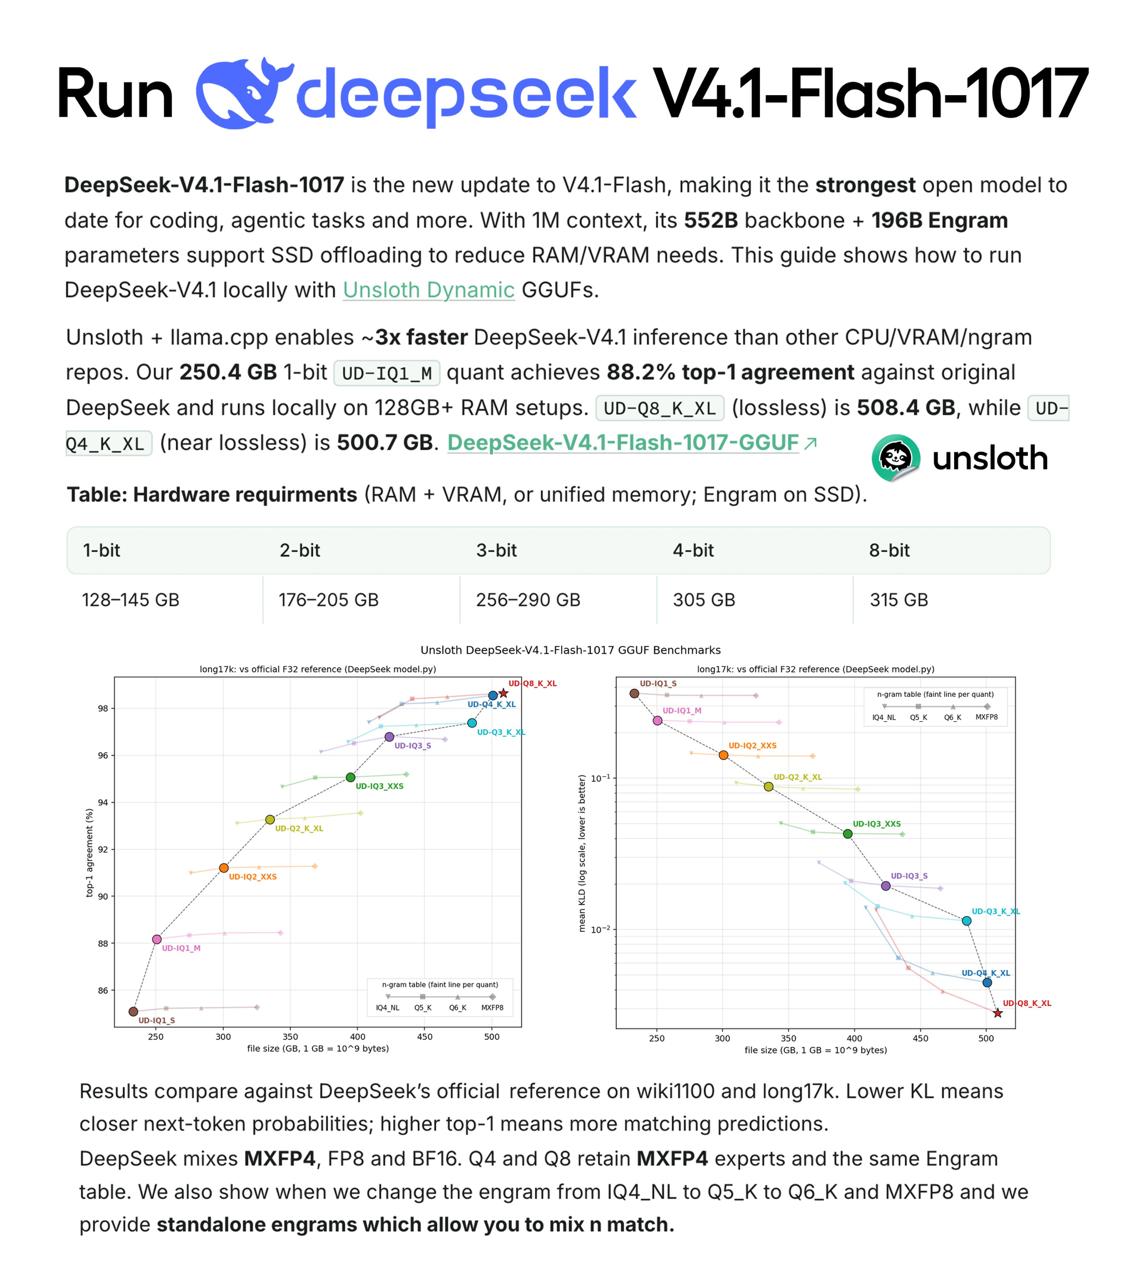
DeepSeek V4.1 Flash 1017 ужали до 1 бита для локального запуска

1 нед
DeepSeek V4.1 Flash 1017 ужали до 1 бита для локального запуска

Обзор новых локальных LLM и инструментов оптимизации

Н@GreenNeuralRobotsAI-инженер
3 нед

Обзор инструментов и оптимизаций для Qwen Image 2.1

Н@GreenNeuralRobotsAI-инженер
1 мес

Обзор новых весов и квантованных моделей на Hugging Face

Н@GreenNeuralRobotsAI-инженер
1 мес

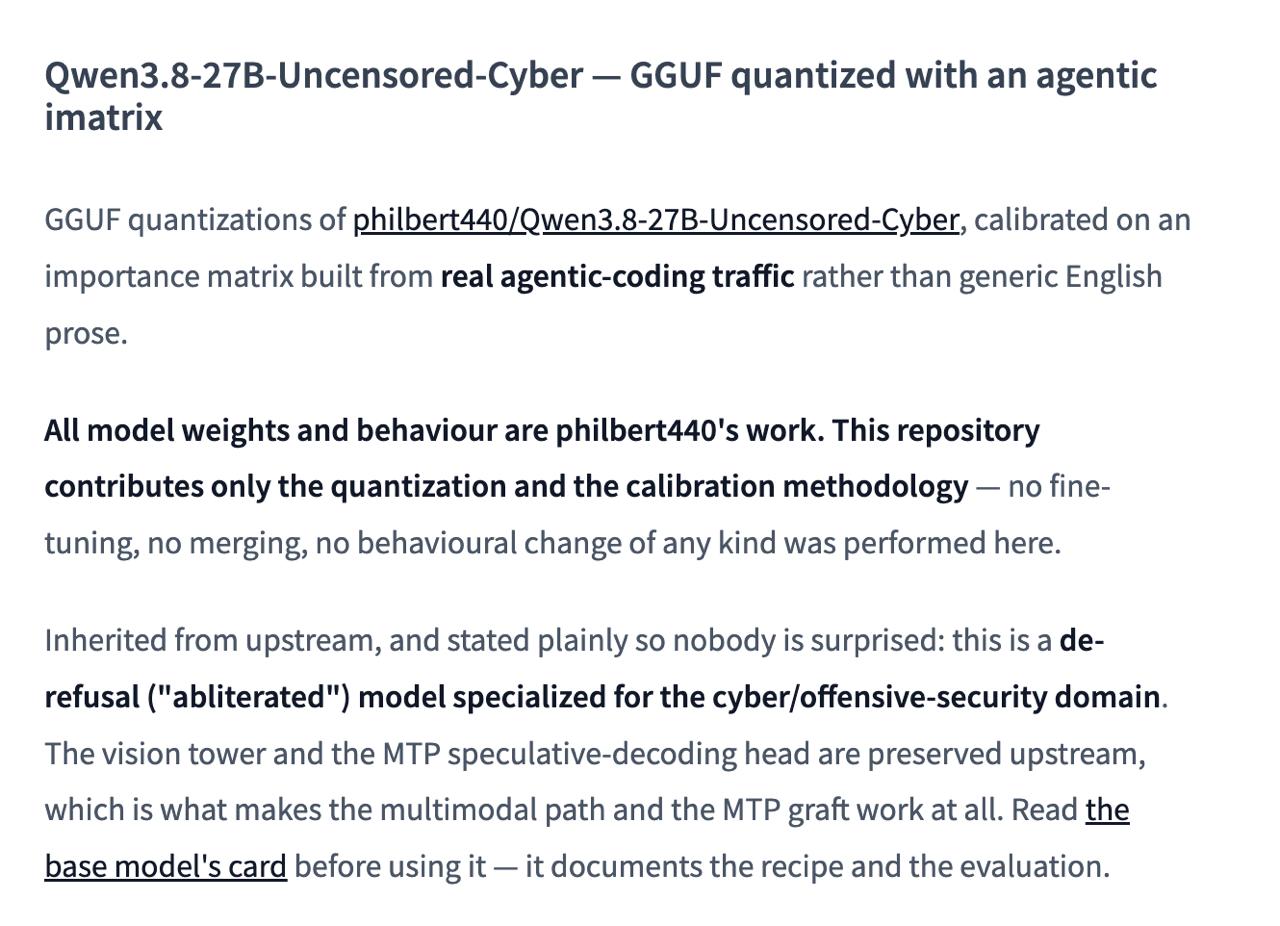
Выпущен Qwen3.8-27B Uncensored в формате GGUF для агентных задач

1 мес
Выпущен Qwen3.8-27B Uncensored в формате GGUF для агентных задач

Поддержка YuE2 в формате GGUF

Н@GreenNeuralRobotsAI-инженер
1 мес
YuE2 на GGUF — влезает в 8-9 ГБ VRAM audio.cpp реализовал поддержку #YuE2 в #GGUF Теперь музыкальная модель, для которой раньше нужно было 24 ГБ, помещается в 8-9 ГБ видеопамяти - DEV-ветка: https://github.com/0xShug0/audio.cpp/tree/dev - Prebuilt-бинарники в Artifacts на странице релиза Q4/Q8 GGUF веса #musicediting VK | MAX

Обзор новых квантованных и специализированных моделей Qwen3.8-Flash-Next и Spark-X2.5

Н@GreenNeuralRobotsAI-инженер
1 мес

Обзор ключевых технологий LLM: от токенизации до квантования и архитектур

T@extremecodeAI-инженер
1 мес
Обзор ключевых технологий LLM: от токенизации до квантования и архитектур

Релиз дообученных моделей Gemma 4 26B и GLM-5.3-Flash-UNCENSORED

Н@GreenNeuralRobotsAI-инженер
1 мес
UNSEEN Gemma 4 26B NSFW Дообученная версия Gemma в формате GGUF, заточена под NSFW-контент ——— GLM-5.3-Flash-UNCENSORED-FP8 Обесцензуренный FP8 GLM-5.3-Flash #uncensored #gguf #fp8 VK | MAX

Z.ai открыла веса GLM-5.3, но впервые ограничила лицензию для крупных сервисов

В середине августа 2026 года китайская Z.ai выпустила GLM-5.3 — по её собственному описанию, «самую способную» модель компании для агентного программирования (agentic codingi) и киберзащиты. Это дообученная версия GLM-5.2 с 743 млрд параметров. Спустя пару недель, после оценки безопасности, компания опубликовала веса модели на HuggingFace — это полноценный релиз весов, а не просто доступ по API, так что модель можно скачивать, запускать локально и дообучать под свои задачи.

Однако, в отличие от предыдущих релизов, Z.ai отказалась от свободной лицензии MIT: теперь сервисы с годовой выручкой выше $10 млрд обязаны проходить проверку безопасности у Z.ai перед использованием GLM-5.3. Это отмечают как признак того, что китайский открытый ИИ начинает «закрываться».

743 млрдпараметров у GLM-5.3
$10 млрдпорог выручки для проверки безопасности
320B/18Bобщие/активные параметры GLM-5.3 Flash

Полный разбор →

Alibaba выпустила Qwen3.8-Flash и Qwen3.8-Flash-Next — превью архитектуры Qwen4

Alibaba представила Qwen3.8-Flash — мультимодальную MoEi-модель, а также открыла веса Qwen3.8-Flash-Next, ранней версии архитектуры, на которой команда строит будущий Qwen4. Модель имеет 125B параметров (из них активируется всего 6B на токен) плюс 51B дополнительных N-gram embeddingsi, повышающих емкость почти без роста вычислений. Обучение обошлось примерно в 9 раз дешевле, чем у Qwen3.7-Plus, а по бенчмаркам модель обходит Qwen3.8-27B и, по разным оценкам, конкурирует с DeepSeek-V4-Flash или превосходит его.

Модель уже доступна и продакшен-версией в QwenCloud, и открытыми весами на HuggingFace (в том числе в GGUF-квантах от Unsloth), поддерживается vLLM и SGLang, появилась на OpenRouter. Благодаря компактному числу активных параметров и оптимизации под unified memory её можно гонять локально на машинах вроде DGX Spark, Mac Studio и Strix Halo с ~128 ГБ памяти.

125Bвсего параметров модели
6Bактивных параметров на токен
9 раздешевле обучение, чем Qwen3.7-Plus

Полный разбор →

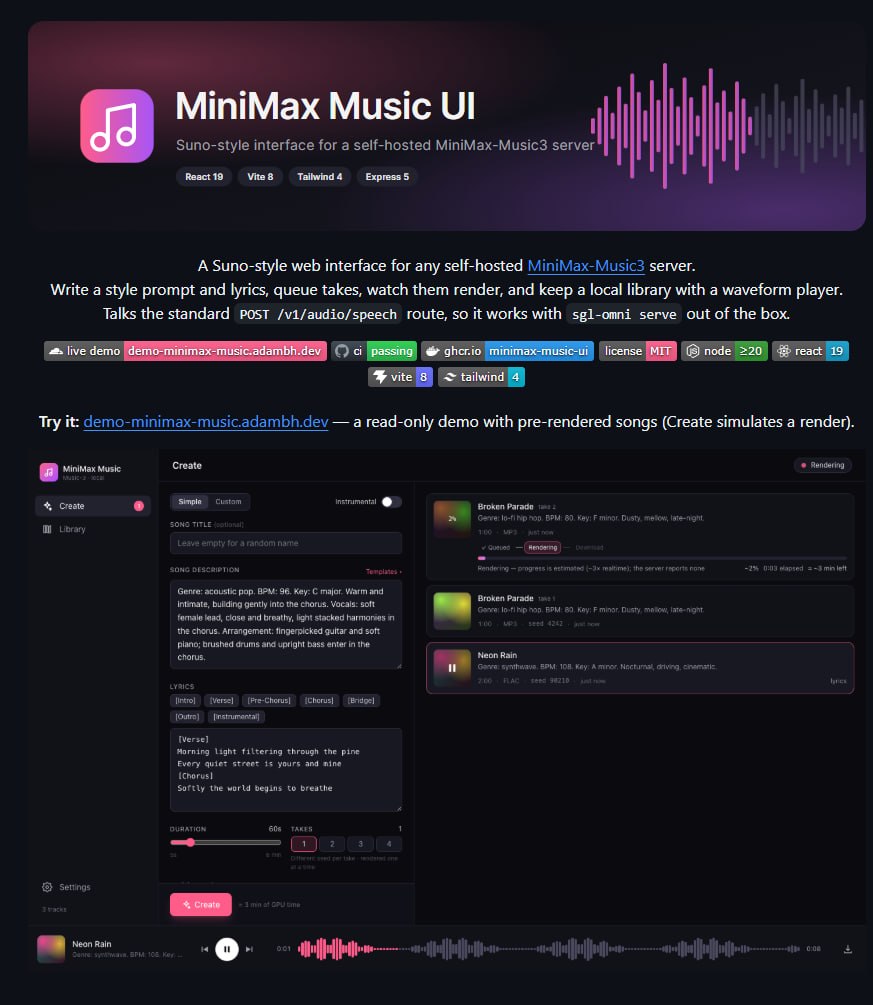
Обзор инструментов и обновлений для MiniMax Music 3

Н@GreenNeuralRobotsAI-инженер
1 мес
Накопилось по #minimaxmusic3 huggingface.co/nerualdreming/open-rvq-encoder-minimax-music3-169m-v4-onnx - RVQ-энкодер 169M для MiniMax Music: трек в коды, доработка, замена секций, ONNX github.com/deepbeepmeep/Wan2GP - Wan2GP обновился до MiniMax Music 3, FL2VA, Ref2VA github.com/adambenhassen/minimax-music-ui - Suno-интерфейс локально для MiniMax Music с библиотекой треков github.com/Senzube4n/AIPLAY-Studio - локальная студия: музыка, обложки, видео, DAW, композитор, MCP для агентов huggingface.co/ChrisColeTech/minimax-music3-GGUF/tree/main/split/text_encoders - текстовый энкодер GGUF #text2music #gguf VK | MAX
Обзор инструментов и обновлений для MiniMax Music 3

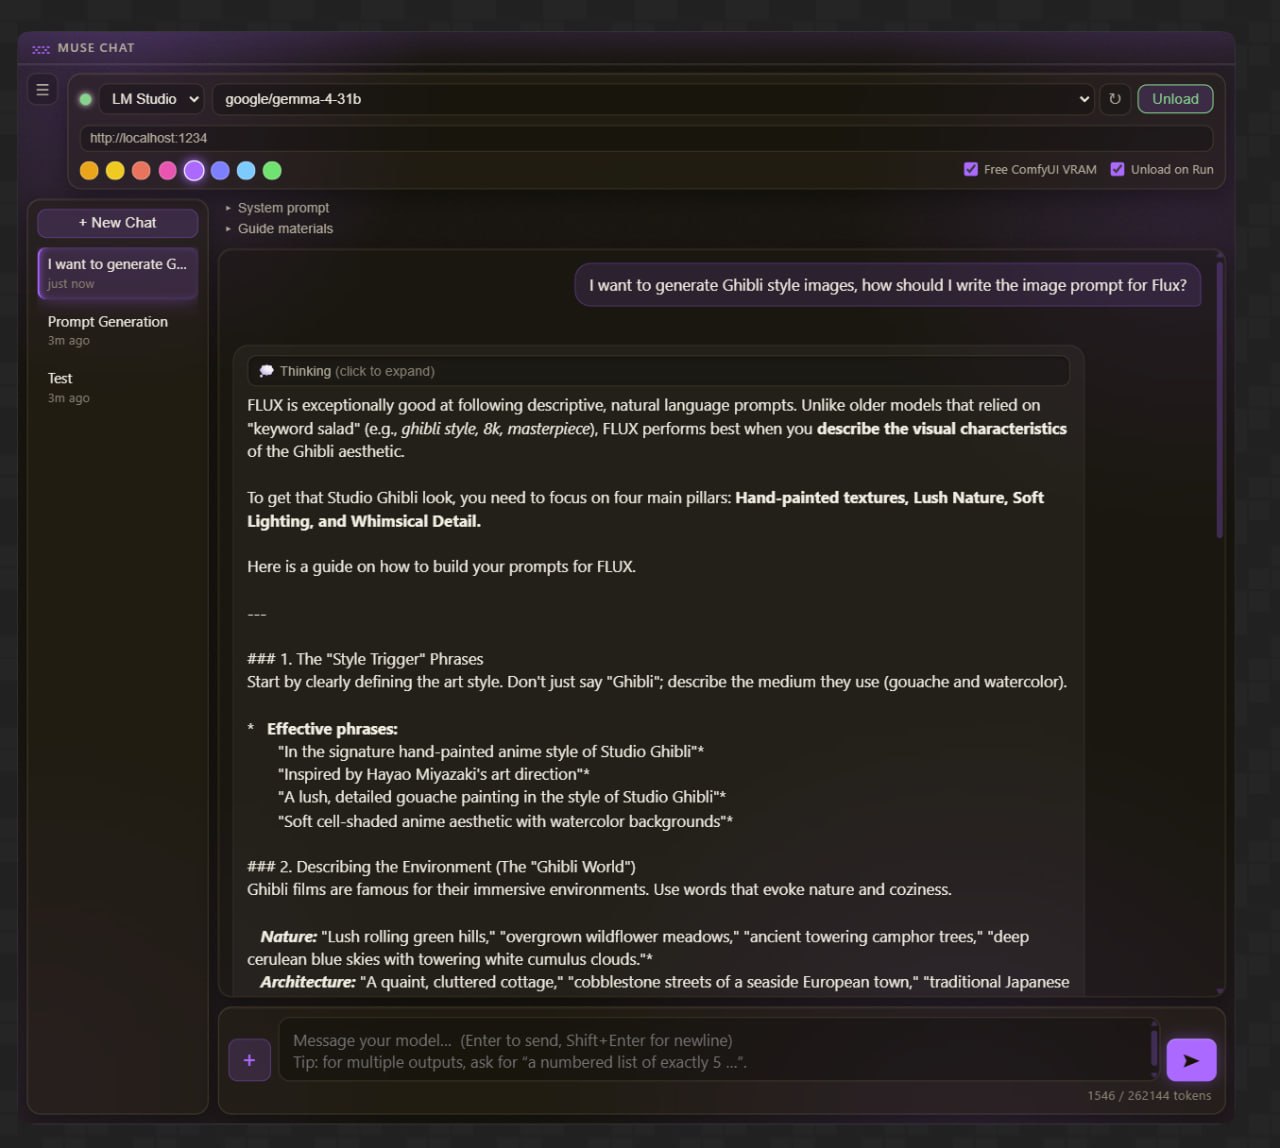
Muse V2: чат-панель с LLM для ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес
Muse V2: чат-панель с LLM для ComfyUI

Qwen выпустила веса модели-гиганта Qwen3.8-2.4T-A95B на 2,4 трлн параметров

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Разработчики Qwen опубликовали на Hugging Facei открытые веса новой модели Qwen3.8-2.4T-A95Bi — с общим числом параметров 2,4 трлн. Это один из крупнейших публично доступных весовых релизов ИИ-модели на сегодня.

Сообщество уже подготовило квантованные GGUFi-версии для локального запуска (через unsloth), хотя большинство пользователей отмечают, что запустить модель такого масштаба у себя просто негде.

2,4 трлнвсего параметров модели
95Bактивных параметров (A95B)
27Bожидаемая меньшая модель

Полный разбор →

Появился каталог ресурсов Awesome MiniMax-H3

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

В открытом доступе появился постоянно обновляемый репозиторий awesome-minimax-H3 на GitHub — единая точка сбора всех материалов по модели MiniMax H3i. Ресурс собирает веса моделей, LoRAi, квантизации, VAEi, текстовые энкодеры, кастомные ноды для ComfyUI, а также гайды и туториалы, освобождая пользователей от необходимости искать разрозненные материалы по разным каналам.

Полный разбор →

Выпущены GGUF-версии модели Qwen3-TTS

Н@GreenNeuralRobotsAI-инженер
2 мес
Qwen3-TTS-12Hz-1.7B-Base-GGUF Пачка GGUF версий говорилки Qwen3-TTS с клонированием голоса и управлением через текстовые инструкции.  - 4-bit Q4_K_M: размер файла 1.04 ГБ - 8-bit Q8_0: размер файла 1.85 ГБ - 16-bit BF16: размер файла 3.47 ГБ Спасибо @Endorpheen #tts #gguf

Оптимизация модели Qwen-Image-2512 от ByteShape

Н@GreenNeuralRobotsAI-инженер
2 мес
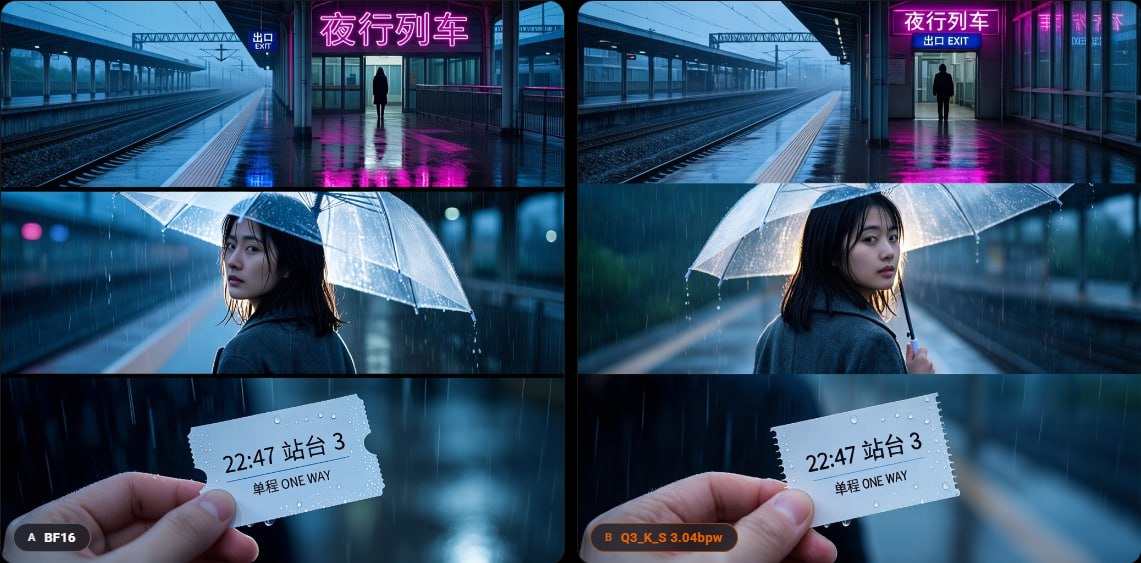
Qwen-Image-2512 GGFU/Humming Пока Алибаба зажал новые квены, ByteShape оптимизировали старый. • шесть уровней квантизации для GGUF от 8 до 17 ГБ • Humming - экспериментальная интеграция, но быстрее GGUF • для vLLM-Omni: 8–17 ГБ, ускорение в 2–3 раза сравнение с оригинальной моделью #qi2512 #gguf #humming
Оптимизация модели Qwen-Image-2512 от ByteShape

Релиз POCKET-35B-GGUF: LLM для запуска на смартфонах

Н@GreenNeuralRobotsAI-инженер
3 мес
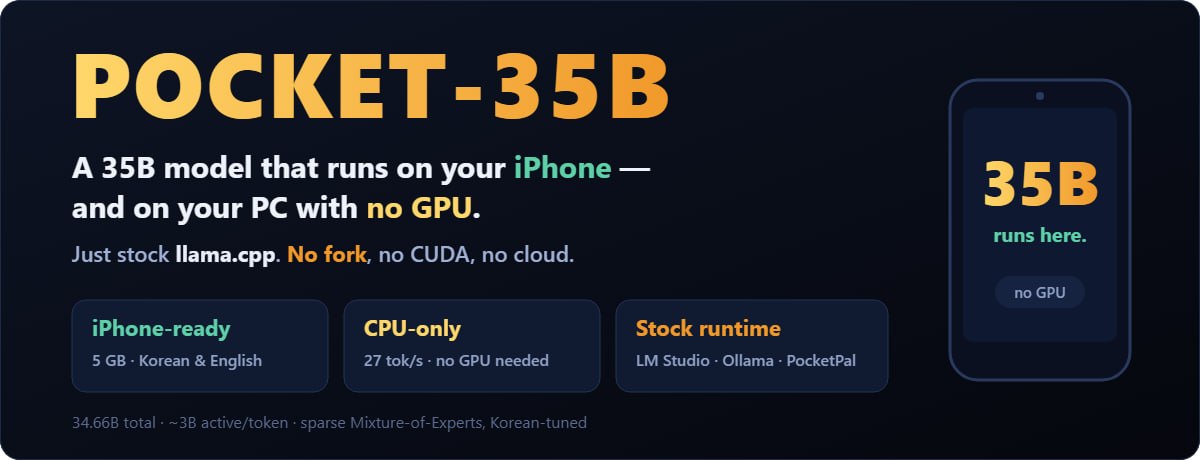
POCKET-35B-GGUF Модель на 35B параметровна базе Darwin-36B-Opus, которая запускается без GPU на смартфоне! • Поддержка английского и корейского языков • Интеграция с популярными инструментами (Ollama, LM Studio) • Размер модели от 8.2 до 21 ГБ в зависимости от квантизации Демо Коллекция компактных моделей Спасибо @m_franz #gguf #compact #mobile
Релиз POCKET-35B-GGUF: LLM для запуска на смартфонах

Релиз компактной агентной модели Nanbeige4.2-3B

Н@GreenNeuralRobotsAI-инженер
3 мес
Nanbeige4.2‑3B Компактная агентная модель на 3B параметров, показывает сильные результаты - Превосходит более крупные модели. По бенчмаркам в задачах для агентов (в том числе общих и кодовых), а также в рассуждениях она обходит Qwen3.5‑9B и Gemma4‑12B. - Агентные сценарии. Заточена под работу в роли агента, может планировать шаги, выполнять цепочки действий и взаимодействовать с инструментами. - Подходит для локального использования - 269★ за 1 час HF Квантизации Демо #gguf #agent #compact
Ещё ↓