cudaСбросить фильтр ×

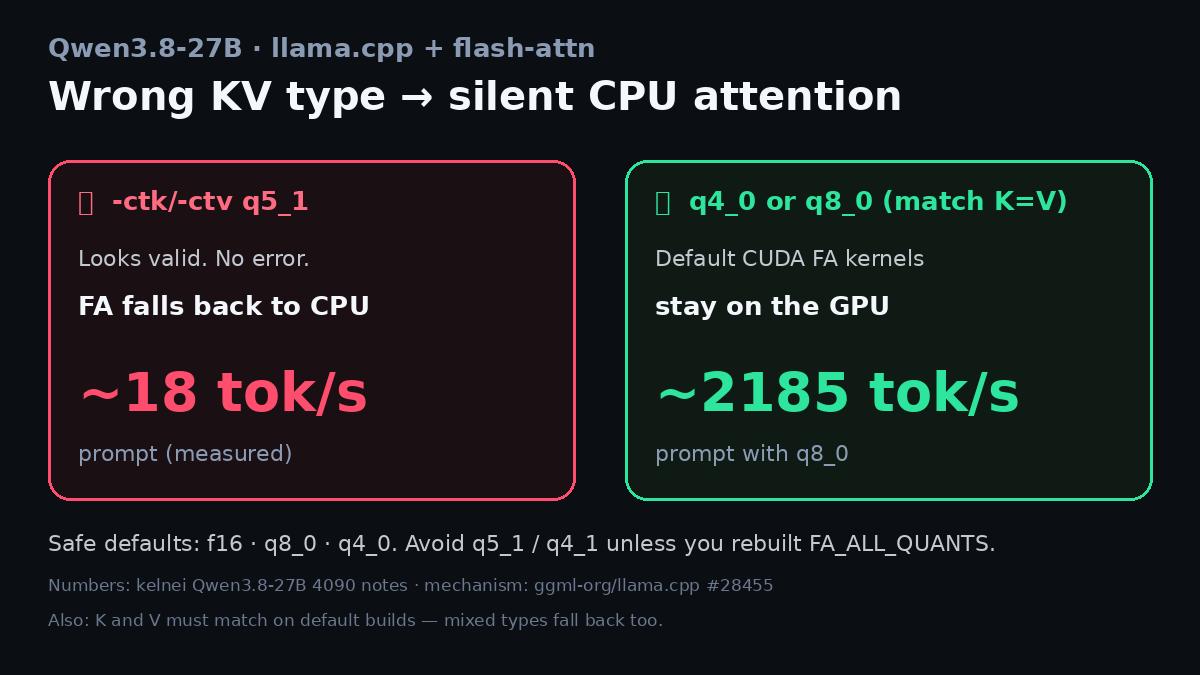
q5_1 в KV-кэше llama.cpp может перенести внимание на CPU

19 ч
q5_1 в KV-кэше llama.cpp может перенести внимание на CPU

SonicBoom: C++-движок инференса без Python

HardenedVault выпустила SonicBoom — среду исполнения для локального запуска языковых моделей на потребительских процессорах и видеокартах. Движок написан на C++ и CUDA, не требует Python ни для работы, ни для сборки и предоставляет локальный сервер с API OpenAI.

В первых тестах на RTX 3050 SonicBoom быстрее llama.cpp на двух моделях при коротком контексте, но преимущество почти исчезает на глубине 512 токенов. Сторонний замер на RTX 4060 Ti показал результат ниже llama.cpp; сборка не была настроена под эту видеокарту.

RTX 3050видеокарта для тестов
512 токеновглубина контекста
RTX 4060 Tiсторонний тест

Полный разбор →

DirtyMoCap: восстановление движения из неразмеченных маркеров

Н@GreenNeuralRobotsAI-инженер
2 нед

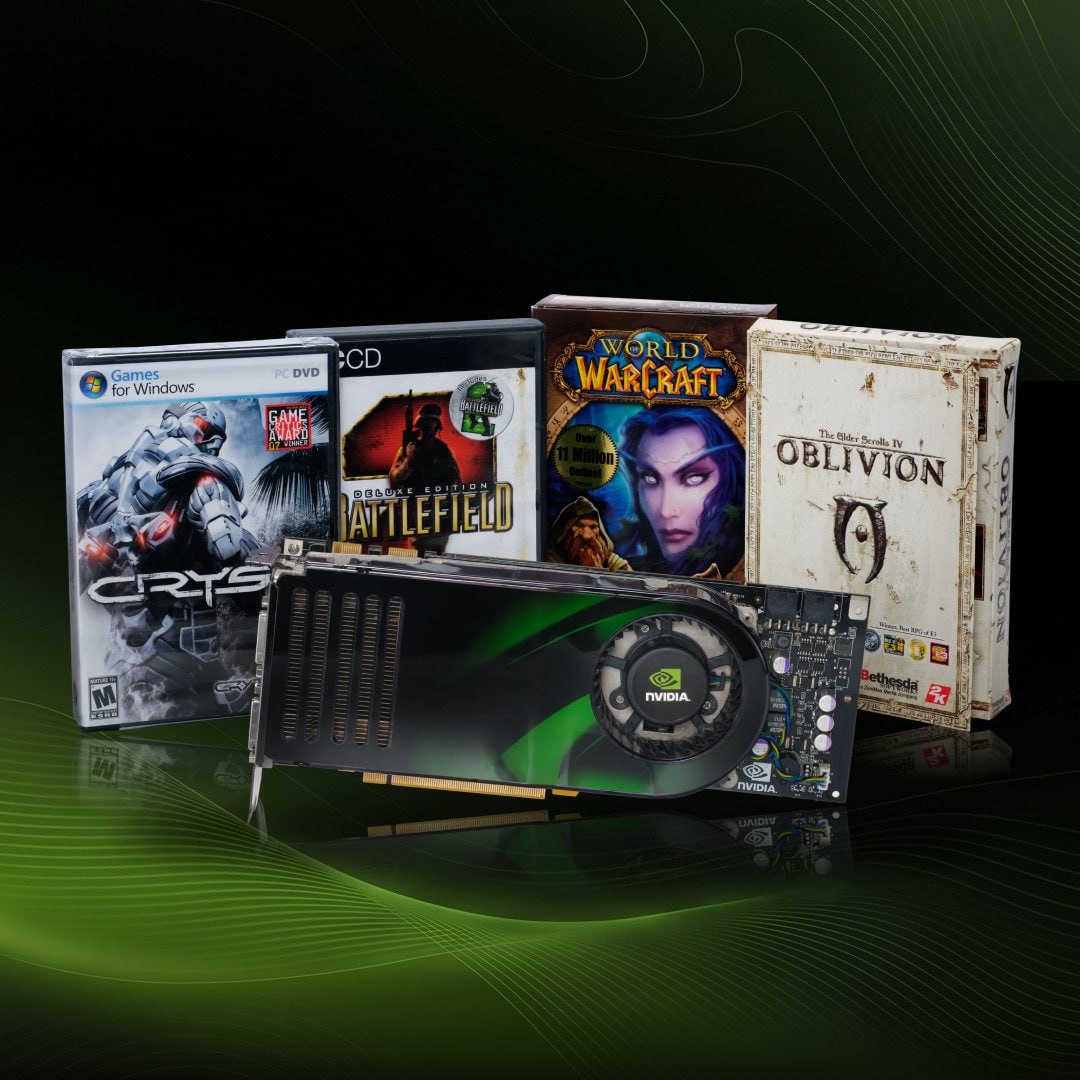
NVIDIA отмечает 20-летие видеокарты GeForce 8800 GTX

P@prohitecавтор про «tech»
2 нед
NVIDIA отмечает 20-летие видеокарты GeForce 8800 GTX

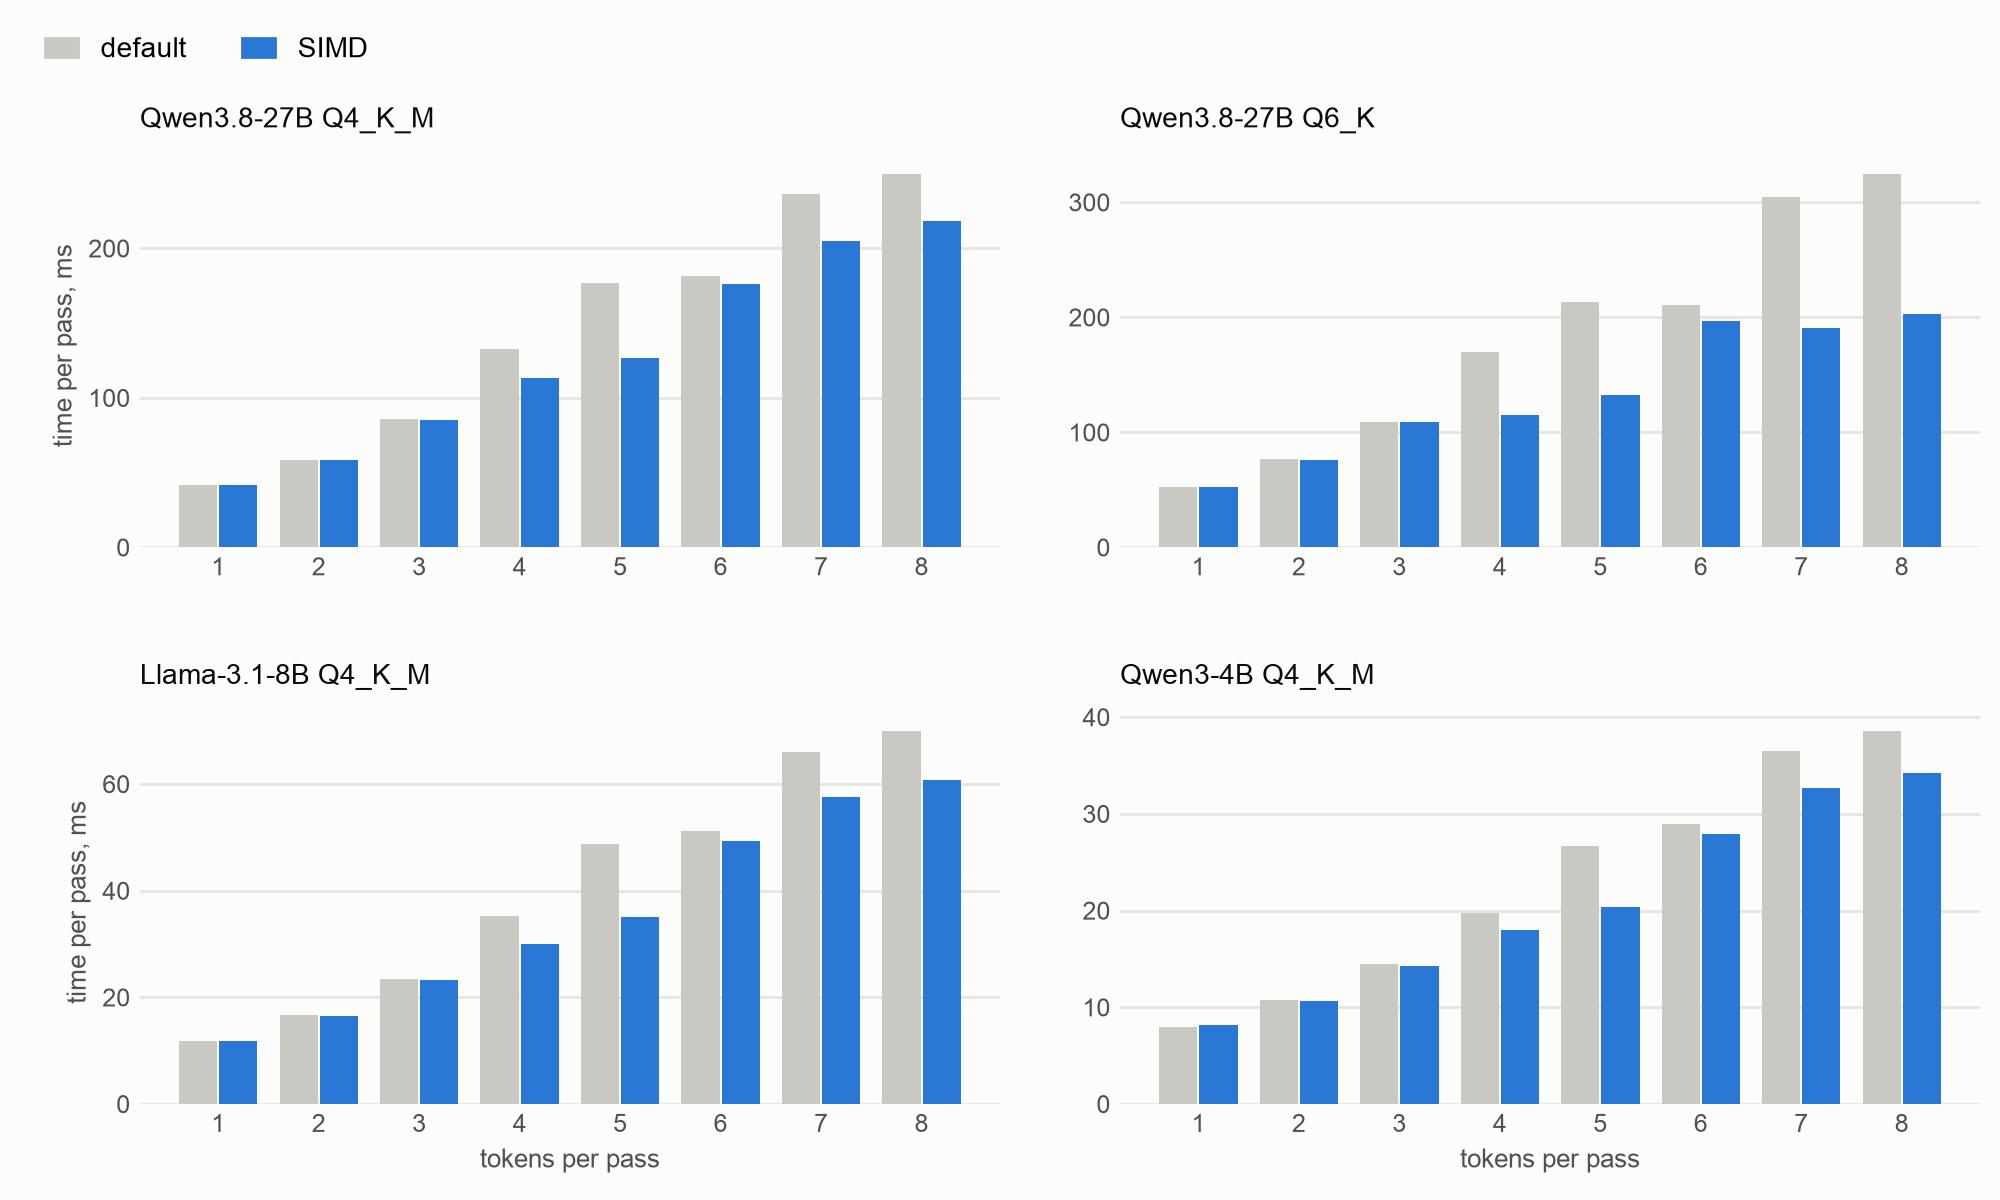
Оптимизация производительности GPU Apple Silicon через ограничение SIMD-групп

L@lovedeathtransformersAI-инженер
2 нед
Оптимизация производительности GPU Apple Silicon через ограничение SIMD-групп

MachGen опубликовала открытую реализацию VC-Attention для ускорения видео-генерации на NVIDIA Blackwell

Команда MachGen выпустила в открытый доступ реализацию VC-Attentioni (предположительно описанного в некой статье метода) для архитектуры NVIDIA Blackwell. На GPU B200 она почти в 2 раза быстрее BF16 FlashAttention-4i при генерации видео такими моделями, как MiniMax H3, и даёт ещё около 20% прироста сверх оригинального метода из статьи.

Это важно для разработчиков видео-генеративных моделей: ускорение attention напрямую снижает время и стоимость рендера роликов на Blackwell-картах без потери качества.

2×ускорение против BF16 FlashAttention-4 на B200
~20%прирост сверх оригинального метода из статьи
0.5%доля токенов V, исправляемых V residual repair

Полный разбор →

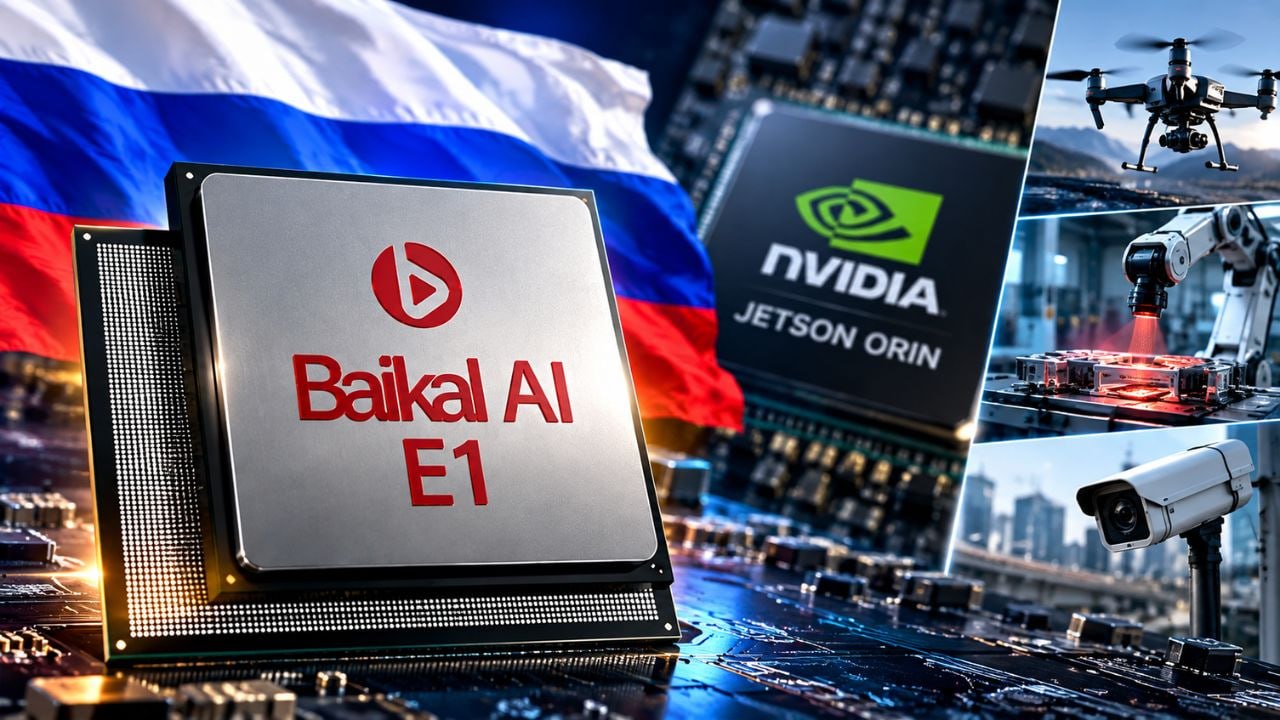
Baikal-AI Electronics представили российское GPGPU-ядро с поддержкой Cuda

P@prohitecавтор про «tech»
3 нед
Baikal-AI Electronics представили российское GPGPU-ядро с поддержкой Cuda

DeepSeek и Huawei выпустили open-source альтернативу CUDA для чипов Ascend

DeepSeek и Huawei открыли исходный код инструментов для программирования китайских ИИ-ускорителей Ascend, включая язык TileLangi от Nvidia">i — аналог Nvidia CUDA. Цель — снизить зависимость китайской ИИ-индустрии от экосистемы Nvidia, которая более 10 лет была стандартом для написания вычислительного софта.

Это не просто отдельная библиотека: Китай выстраивает полноценный альтернативный AI-стек — от чипов до компиляторов и библиотек, — чтобы устройства Huawei Ascend могли заменить Nvidia на всех уровнях, а не только по «железу».

128ускорителей Ascend 950 в системе Supernode
160 000ускорителей Huawei для нового дата-центра DeepSeek
2027год, на обучение моделей которого рассчитан Supernode

Полный разбор →

Настройка P2P на GPU NVIDIA CMP 90HX

Х@habr_comмедиа / агрегатор
4 нед
P2P на CMP 90HX заработал — и сначала оказался медленнее обмена через RAM Штатный драйвер NVIDIA считает, что CMP 90HX не поддерживает прямой обмен между GPU. Но внутри всё тот же GA102, а в драйвере остались внутренние механизмы, позволяющие принудительно переопределять обычные ограничения возможностей. После нескольких дней сборки модулей, чтения логов и CUDA-тестов P2P наконец заработал. И выдал около 250 МБ/с — против 1,60 ГБ/с через системную память. То есть задача из «как включить P2P» превратилась в «почему рабочий P2P передаёт данные со скоростью флешки». Дальше пришлось разбираться уже с причиной этой скорости.
Настройка P2P на GPU NVIDIA CMP 90HX

Claude Opus 5.5 написала рабочий трассировщик путей на C++ и CUDA

P@prohitecавтор про «tech»
1 мес
Claude Opus 5.5 написала рабочий трассировщик путей на C++ и CUDA

NVIDIA открывает нативное GPU-программирование на Rust (CUDA Rust)

NVIDIA официально представила CUDA Rust — возможность писать GPU-ядра (kernels) прямо на Rust и компилировать их в PTXi, без промежуточного C++. Разработка ведётся сразу по двум направлениям: классическая SIMTi-модель через `cuda-oxide` и новая tile-basedi модель через `cutile-rs`.

Значение шага в том, что для AI-инфраструктуры появляется возможность писать больше кода на одном языке — Rust, а система владения (ownership) и типов Rust позволяет отлавливать часть гонок потоков (race conditions) и ошибок доступа к памяти ещё на этапе компиляции, до запуска kernel на видеокарте.

Rust 1.89+минимальная версия Rust для cutile-rs
CUDA 13.3требуемая версия CUDA

Полный разбор →

NVIDIA выпустила CUDA 13.4 с поддержкой Windows на Arm

P@prohitecавтор про «tech»
1 мес
NVIDIA выпустила CUDA 13.4 с поддержкой Windows на Arm

Обзор инструментов и оптимизаций для Minimax H3

Н@GreenNeuralRobotsAI-инженер
1 мес
Обзор инструментов и оптимизаций для Minimax H3

Prime Flash MoE: оптимизированные кернелы для архитектуры Blackwell

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Компания Prime Intellect представила Prime Flash MoEi — специализированный fused-кернелi, предназначенный для ускорения работы моделей с архитектурой Mixture-of-Experts (MoE) на графических процессорах NVIDIA Blackwell.

Решение направлено на устранение узких мест при работе с памятью и синхронизацией потоков, что позволяет значительно повысить производительность вычислений по сравнению со стандартными методами PyTorch.

20%прирост скорости в формате bf16
2 разаускорение в формате mxfp8

Полный разбор →

Обзор блога Simon Veitner по оптимизации GPU-кернелов

К@quant_prune_distillAI-инженер
2 мес
Наткнулся на интересный блог от некоего Simon Veitner. Дизайн суровый, минималистичный, максимально дешево и сердито, но есть немало интересных статей про написание и ускорение кернелов, компоненты современных GPU, а также реализации различных алгоритмов в CuTe / CuTeDSL . В частности: • Making RMSNorm really fast • Making matrix transpose really fast on Hopper GPUs • CuTeDSL on Hopper - WGMMA and TMA intro Будет полезно интересующимся написанием кернелов и эффективными программными реализациями алгоритмов на видеокартах, в особенности, на архитектурах Hopper и Blackwell.

Прохождение курса Language Modeling from Scratch

Т@tech_priestessAI-инженер
2 мес

Лаба Song Han из MIT выпустила агентский скилл для оптимизации CUDA-кернелов под Hopper и Blackwell

Лаборатория Song Han (MIT), известного специалиста по эффективному глубокому обучению, опубликовала репозиторий со скиллом для AI-агентов, предназначенным для оптимизации кернеловi под архитектуры Hopperi и Blackwelli.

Скилл содержит набор скриптов, которые позволяют агенту самостоятельно обращаться к базам знаний, блогам, PR'ам и другим артефактам, посвящённым тензорным ядрам и архитектурным особенностям Hopper и Blackwell — то есть автоматизирует часть рутинной работы по низкоуровневой оптимизации GPU-кода.

Полный разбор →

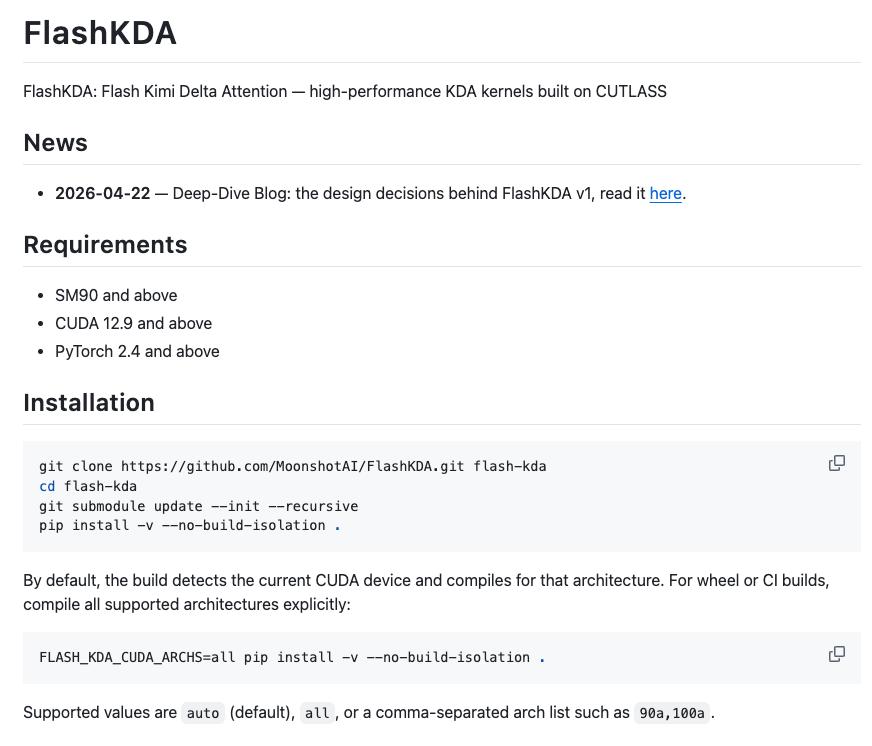
Moonshot AI представила FlashKDA для ускорения Kimi Delta Attention

3 мес
Moonshot AI представила FlashKDA для ускорения Kimi Delta Attention

Сотрудники Anthropic иронизируют над призывами к открытому коду

D@data_secretsAI-инженер
3 мес
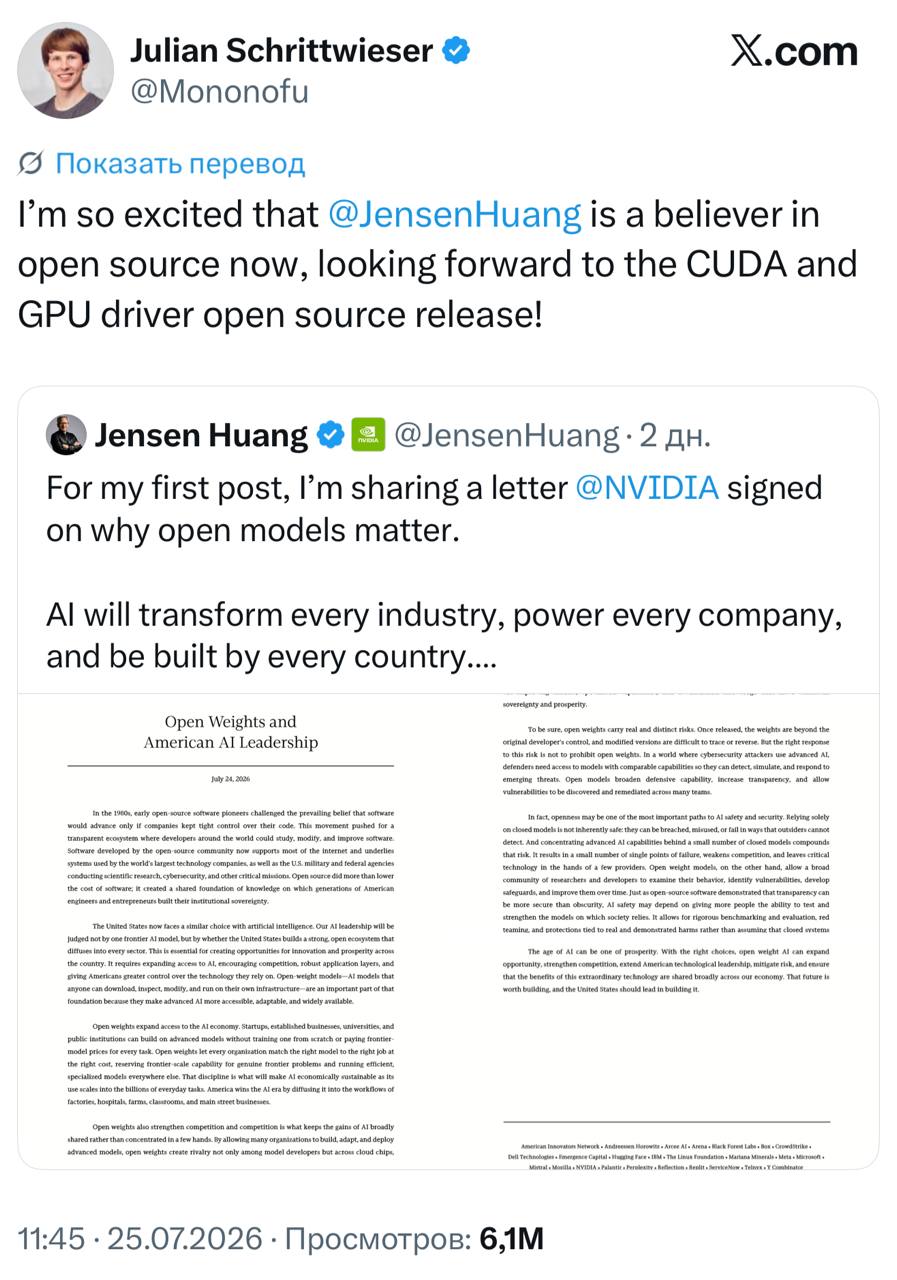
Сотрудники Anthropic тем временем еще и публично подсмеиваются над компаниями, подписавшими письмо 6.1 миллион просмотров набрал твит Julian Schrittweiser. В био у него числится «Member of Technical Staff at Anthropic». Разработчик недвусмысленно поиздевался над Хуангом, «поздравив» его с обретением веры в открытый код, и добавив, что ждет опенсорса CUDA и GPU. Под этим же твиттом он также обратился к Сатье Наделла. «Я также жду опенсорса Windows и MS Office!». Давайте дружно поможем антропикам найти хорошего кризис-менеджера, он им пригодится 🙏
Сотрудники Anthropic иронизируют над призывами к открытому коду

Почему Python стал стандартом в машинном обучении

Х@habr_comмедиа / агрегатор
3 мес
Ещё ↓