DeepSeek и Huawei разрабатывают альтернативу CUDA
D@data_secretsAI-инженер
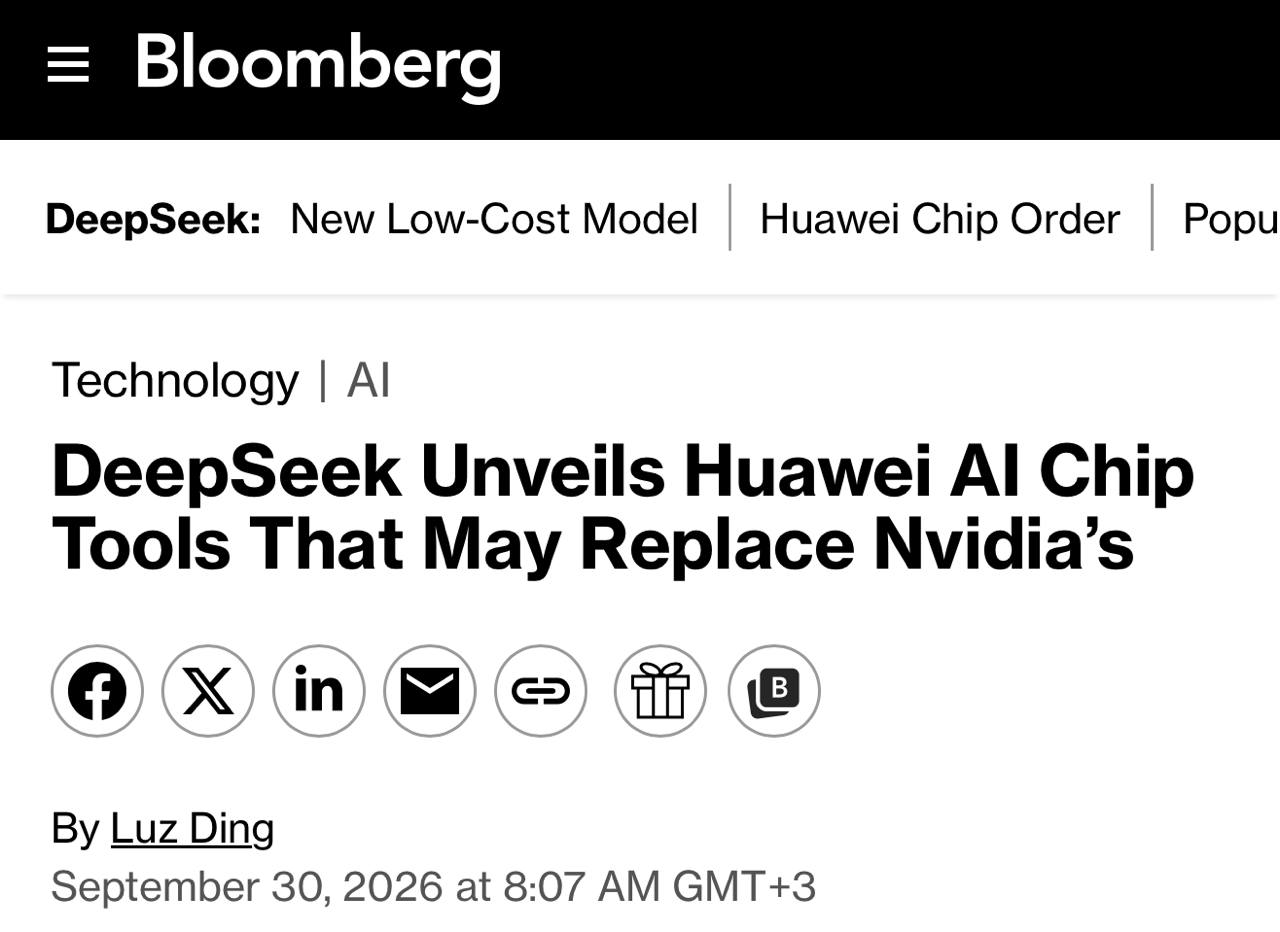
3 недDeepSeek и Huawei представили инструменты для чипов Ascend, упрощающие перенос AI-моделей с CUDA на китайское железо.
Китай делает важный шаг к технологической независимости в сфере AI-вычислений.
- Снижается зависимость китайских разработчиков от экосистемы Nvidia CUDA.
- Упрощается миграция существующих AI-моделей на чипы Huawei Ascend.
- Автоматизация низкоуровневой оптимизации через TileLang ускоряет разработку для альтернативного железа.
DeepSeek вместе с Huawei разрабатывают альтернативу CUDA
Компании выложили в опенсорс набор инструментов для чипов Huawei Ascend. Сейчас это главные китайские AI-ускорители, на которые переходят все их стартапы. Большая проблема с переходом на новое железо заключается в софте: вся индустрия 10+ лет писала все под CUDA от Nvidia, и теперь Китаю предстоит восстановить то же самое для своих чипов.
Собственно, этим DeepSeek и занимается. В частности, они выпустили в опенсорс Ascend-версии своих фирменных библиотек, на которых держатся ее собственные модели: DeepGEMM (умножение матриц), DeepEP (связь между чипами для MoE-моделей), FlashMLA (attention) и еще несколько. API у них такая же, как у Nvidia-версий, поэтому код с Nvidia переезжает почти без переписывания.
Весь этот стек работает на TileLang. Поддержка Ascend у них появилась год назад, и если раньше на нем приходилось вручную прописывать такие вещи, как расписание и синхронизацию обработки данных, то теперь все это берет на себя компилятор. DeepSeek утверждает, что язык компактнее CUDA, а все TileLang-ядра, на которых она обучает свои модели, уже работают на Ascend.
Понятно, что это замена не всего стека CUDA, а только написания ядер, но направление понятное: Китай методично закрывает зависимость от Nvidia на всех уровнях.
Кратко (AI)
DeepSeek совместно с Huawei выпустили набор инструментов с открытым исходным кодом для адаптации AI-моделей под чипы Huawei Ascend. Решение включает библиотеки DeepGEMM, DeepEP и FlashMLA, которые позволяют переносить код с Nvidia CUDA на китайские ускорители с минимальными изменениями. Использование языка TileLang автоматизирует управление синхронизацией данных, что упрощает разработку для локального железа.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖