В некоторых сборках llama.cpp формат q5_1 при включённом Flash Attention переносит вычисление внимания на CPU; автор сообщает об ускорении промпта после перехода на q8_0.
Один флаг llama.cpp может резко замедлить обработку промпта – без ошибки и предупреждения.
В обсуждении #28455 описан случай: при включённом Flash Attention выбор
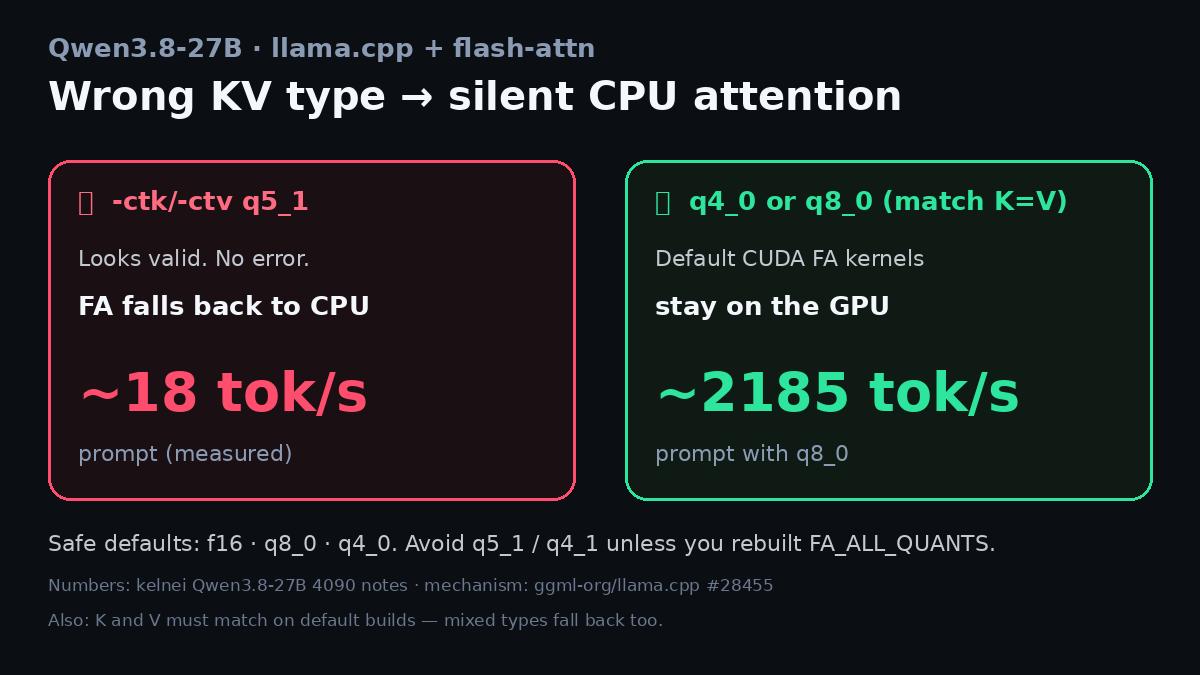
`q5_1` для KV-кэша переносил вычисление внимания с GPU на CPU. Модель продолжала работать, но скорость падала.
Причина –
отсутствие CUDA-ядер для выбранного формата кэша в стандартной сборке.
В замерах автора на RTX 4080 обработка промпта ускорилась
с 38 до 1348 токенов/с после замены
q5_1 на
q8_0. Это скорость чтения входного запроса, а не генерации ответа.
Для затронутых сборок обходной вариант:
-fa on -ctk q8_0 -ctv q8_0
Ещё один поддерживаемый вариант – одинаковый
q4_0 для K и V. Если нужен
q5_1, автор предлагает пересборку с:
-DGGML_CUDA_FA_ALL_QUANTS=ON
Если GPU почти простаивает, а CPU загружен – проверьте формат KV-кэша и параметры сборки. Участник команды llama.cpp подтвердил, что проблема известна.
https://github.com/ggml-org/llama.cpp/issues/28455 Кратко (AI)
В обсуждении llama.cpp сообщают, что при включённом Flash Attention формат KV-кэша q5_1 в некоторых сборках без нужных CUDA-ядер может переносить вычисление внимания на CPU. Автор замеров на RTX 4080 получил рост скорости обработки промпта с 38 до 1348 токенов/с после перехода на q8_0; также предложены q4_0 для K и V или пересборка с указанной опцией.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖