ttsСбросить фильтр ×

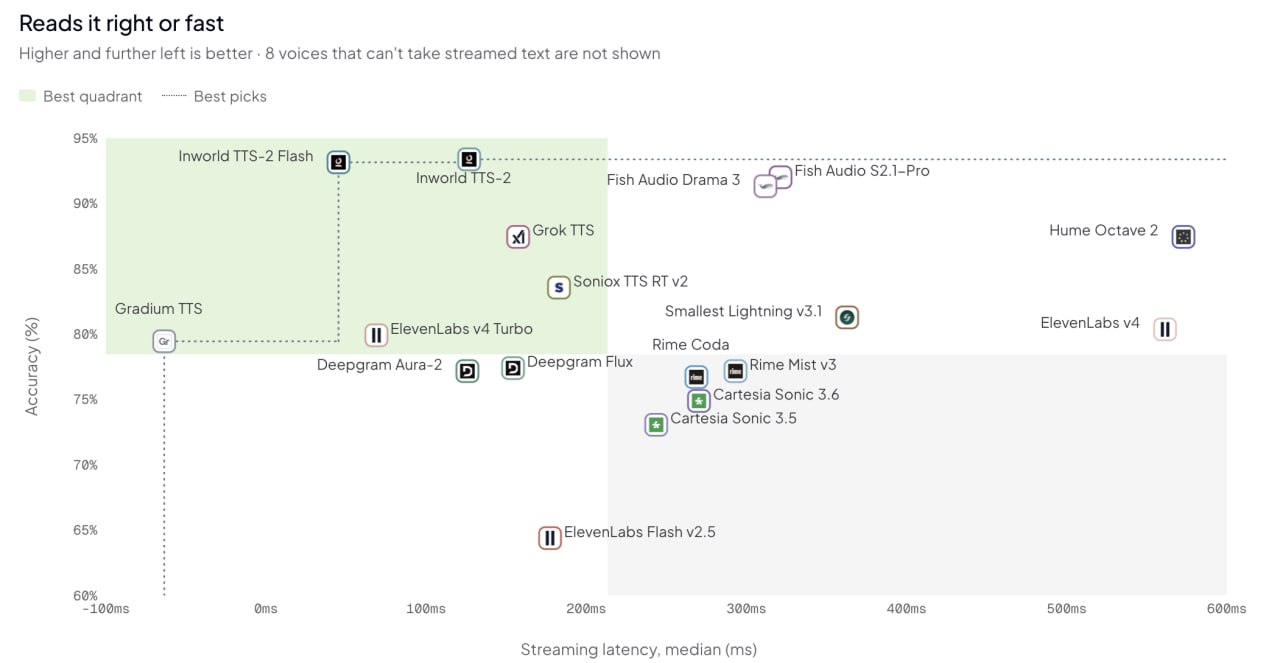
Бенчмарк Cekura сравнил 26 моделей TTS для голосовых агентов

A@ai_productAI-инженер
1 нед
Бенчмарк Cekura сравнил 26 моделей TTS для голосовых агентов

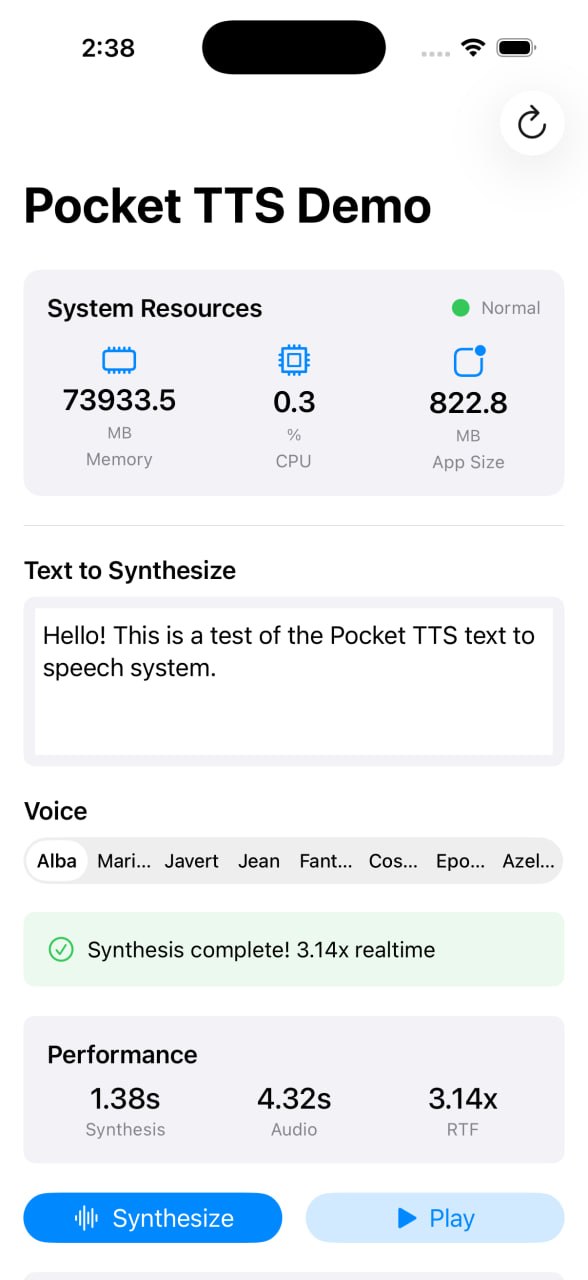
Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

Н@GreenNeuralRobotsAI-инженер
2 нед
Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

Black Forest Labs выпустила FLUX 3 Image — единую модель генерации и редактирования изображений

Black Forest Labs представила FLUX 3 Image — модель, объединяющую генерацию и редактирование изображений в одном эндпоинте, без необходимости переключать режимы. Главные новшества: разметка объектов с помощью bounding boxesi для точечного локального редактирования, нативный рендер до 16 МП (против ~4 МП у FLUX.2) и встроенный веб-поиск для сверки визуальных деталей перед генерацией.

Модель уже доступна через API BFL, а также на Replicate, OpenRouter и Krea, коммерческие веса открыты для развёртывания на своей инфраструктуре, а открытые веса обещают «в ближайшие недели».

16 MPмаксимальное разрешение нативного рендера FLUX 3
10 референсовмаксимум изображений-референсов за запрос
$0.607цена генерации одного 4K-изображения

Полный разбор →

Обзор новых моделей и инструментов для TTS и ASR

Н@GreenNeuralRobotsAI-инженер
3 нед

Fish Audio представила превью-модель Drama 3 для озвучки

Н@GreenNeuralRobotsAI-инженер
3 нед
Fish Audio Drama 3 Новая превью-модель от Fish Audio для речи и озвучки. Вместо жестких аудиотегов интонация, темп и характер персонажа описываются обычным текстом. • Перегенерация одного слова или фразы в готовой дорожке • Смена голоса прямо посреди предложения • Диалоги нескольких героев за один проход • Работает на русском Технически • Голос по id модели или zero-shot клонирование по референсам • Диалоги через теги <|speaker:0|>, <|speaker:1|> • Форматы: WAV/MP3/Opus, до 48 kHz Мульти-спикер-диалоги есть и в S2-семействе, не только в Drama 3 #tts #russian MAX

Suno запускает генерацию речи с фоновой музыкой

М@cgeventAI-инженер
3 нед

VoiceStudio — опенсорсная локальная замена ElevenLabs

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 нед назад

На GitHub появился инструмент VoiceStudio — бесплатная и полностью открытая альтернатива платному ElevenLabsi для работы с голосом. Он умеет клонировать голоса по короткой записи, создавать голоса с нуля, озвучивать текст, делать дубляж видео с таймингом и транскрибировать аудио, поддерживая 646 языков.

Главное отличие от коммерческих сервисов — всё работает локально на компьютере пользователя (macOS, Windows, Linux), а удалённые сервисы и аналитика подключаются только по желанию и с согласия. Инструмент уже набрал 38 тыс. звёзд на GitHub, что говорит о быстром росте популярности среди разработчиков и создателей контента.

646поддерживаемых языков
16движков для озвучки
38 тыс.звёзд на GitHub

Полный разбор →

VoiceChat-TTS: модель синтеза речи с низкой задержкой для интерактивных агентов

g@grokaem_sebyмедиа / агрегатор
4 нед

Google выпустила Gemini 3.8 Flash TTS и Flash-Lite TTS — модели синтеза речи с клонированием голоса

Google представила две новые модели преобразования текста в речь: Gemini 3.8 Flash TTS для творческой озвучки персонажей и Gemini 3.8 Flash-Lite TTS — более быструю и дешёвую версию для массового контента и голосовых агентов. Обе модели доступны с 23-24 сентября 2026 года через Gemini APIi, Google AI Studio и Gemini Notebook.

Главная новая функция — генерация голоса с нуля по текстовому описанию (характер, акцент, тембр) и клонирование голоса по 30-секундному образцу записи при наличии подтверждённого согласия владельца. Модели поддерживают более 100 языков и диалектов, включая русский, и содержат библиотеку из более чем 2000 готовых голосов с региональными вариантами (мексиканский испанский, квебекский французский, шотландский английский).

2000+готовых голосов в библиотеке
100+поддерживаемых языков и диалектов
30 секунднужный сэмпл для клонирования голоса

Полный разбор →

Релиз семейства моделей StepAudio 3

Н@GreenNeuralRobotsAI-инженер
1 мес
StepAudio 3 Новые модели от Степана StepAudio 3 Realtime Полнодуплексная аудио-языковая модель. Говорит и слушает одновременно, размышляет вслух не замолкая китайский и английский StepAudio 3 Music Генерация песен: планирует структуру (куплеты, припев, бридж, аранжировку), создает 48-kHz стерео до 5м 30с язык задается описанием песни Помимо этого в семейство вошли говорилка с дизайном голоса Gen, TTS и ASR китайский, английский, японский, корейский, французский, испанский Voice Studio - пока только разговорная, музыка анонсирована #musicediting #dialog #asr #tts #voicedesign

Motion-Omni: генерация речи и движений в одной модели

Н@GreenNeuralRobotsAI-инженер
1 мес
Motion-Omni Одна модель генерирует и речь и движения тела по диалогу. Вместо того чтобы запускать TTS и анимацию по отдельности и потом синхронизировать все делается из одних и тех же латентных состояний - 5.4x быстрее каскадных решений, не надо ждать пока каждый компонент отработает по очереди - Синхронизация зашита в архитектуру, а не доклеивается постфактум - Подходит для диалоговых аватаров, виртуальных персонажей, anything, где персонаж говорит и движется одновременно На видео сравнение с MambaTalk Гитхаб #tts #animation VK | MAX

Релиз pocket-tts-ru: легкий синтезатор речи с клонированием голоса

Н@GreenNeuralRobotsAI-инженер
1 мес
Релиз pocket-tts-ru: легкий синтезатор речи с клонированием голоса
Ещё ↓