voicecloningСбросить фильтр ×

Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

Н@GreenNeuralRobotsAI-инженер
2 нед
Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

VoiceStudio — опенсорсная локальная замена ElevenLabs

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 нед назад

На GitHub появился инструмент VoiceStudio — бесплатная и полностью открытая альтернатива платному ElevenLabsi для работы с голосом. Он умеет клонировать голоса по короткой записи, создавать голоса с нуля, озвучивать текст, делать дубляж видео с таймингом и транскрибировать аудио, поддерживая 646 языков.

Главное отличие от коммерческих сервисов — всё работает локально на компьютере пользователя (macOS, Windows, Linux), а удалённые сервисы и аналитика подключаются только по желанию и с согласия. Инструмент уже набрал 38 тыс. звёзд на GitHub, что говорит о быстром росте популярности среди разработчиков и создателей контента.

646поддерживаемых языков
16движков для озвучки
38 тыс.звёзд на GitHub
Полный разбор →

ICE-012 Audio: многоязычная модель клонирования голоса

Н@GreenNeuralRobotsAI-инженер
1 мес
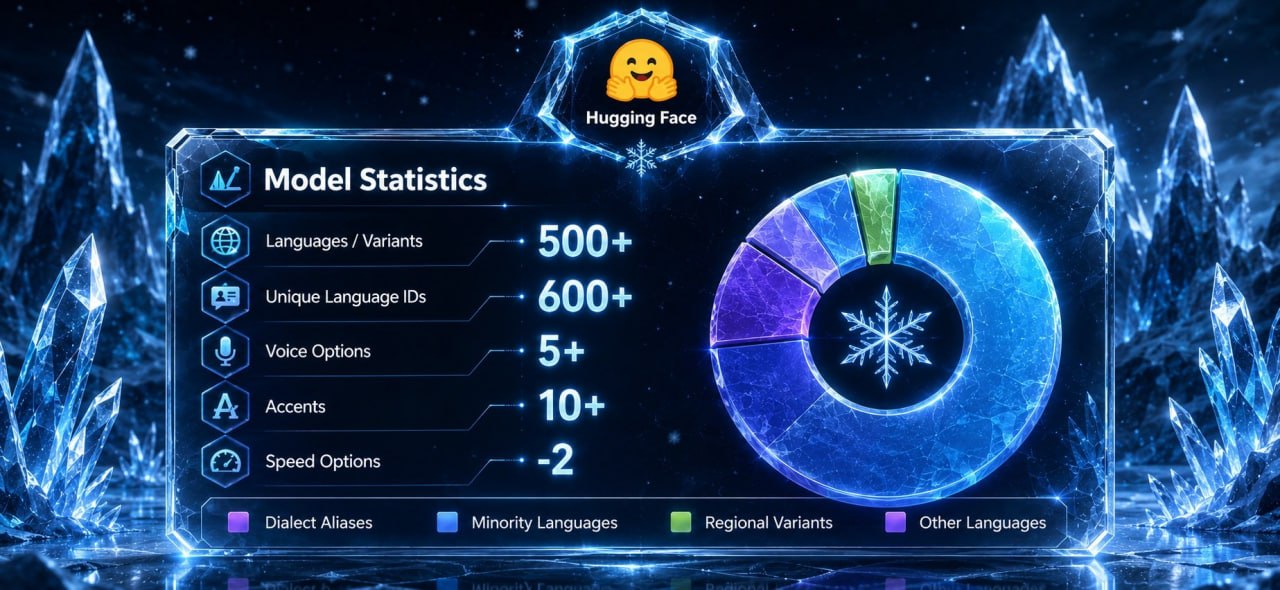
ICE-012 Audio (DarkPs) Многоязычная говорилка с клонированием голоса. 590 языков и диалектов, есть русский. - Клонирование голоса по 2 секундам - Управление голосом: пол, возраст, высота, акцент, стиль (шепот), скорость - Стриминг-генерация без ожидания полного файла - Активный акустический адаптер: обрабатывает кодек-эмбеддинги до и после основного блока Подходит для озвучки на редких языках, где коммерческие TTS отсутствуют #tts #russian #voicecloning VK | MAX
ICE-012 Audio: многоязычная модель клонирования голоса

Релиз Audio8 TTS Preview 0.1B

Н@GreenNeuralRobotsAI-инженер
1 мес
Audio8 TTS Preview 0.1B ONNX INT8 Компактная многоязычная говорилка с клонированием голоса по одному примеру. Работает на CPU без видеокарты. • RAM около 0.6 ГБ при загрузке основных сессий • звук на выходе 44,1 кгц, моно • скорость около 19 мс на токен медленной части и 8 мс на кадр быстрой 11 языков из коробки: китайский, кантонский, английский, французский, немецкий, итальянский, японский, корейский, польский, испанский, нидерландский Гитхаб HF #tts #voicecloning #compact VK | MAX
Релиз Audio8 TTS Preview 0.1B

Релиз Breeze TTS 2: модель для клонирования голоса и генерации речи в реальном времени

Н@GreenNeuralRobotsAI-инженер
2 мес
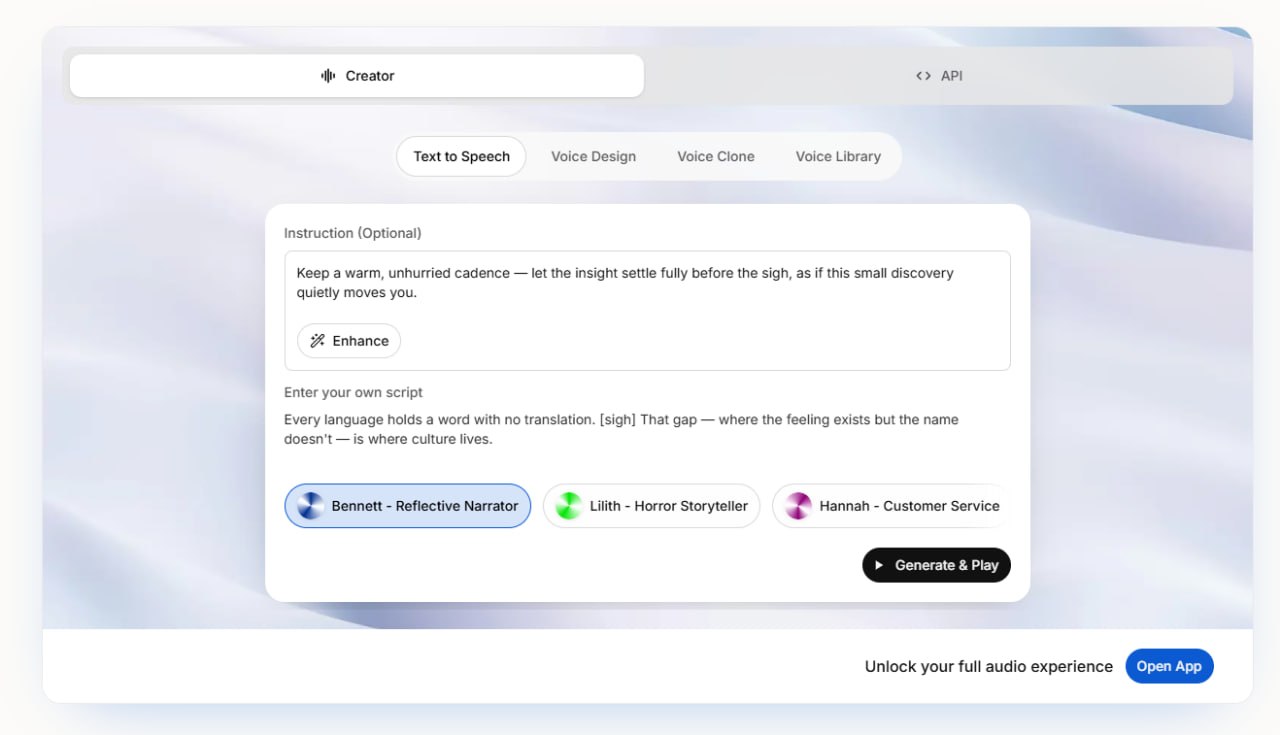
Breeze TTS 2 Рилтайм говорилка - Клонирование голоса: пара секунд речи + точная расшифровка → сохранение тембра, ритма, эмоций - Дизайн голоса без референса по промпту - Voice Direction: "говори медленно, серьезно" - голос остается, подача меняется - Вокальные события в тексте: (laugh), (cough), (sigh) - Стриминг с задержкой менее 40 мс до первого аудио, генерация в 3 раза быстрее реального времени - 3B, ~7.7 GB VRAM, min 12 GB GPU - английский и китайский Гитхаб HF Попробовать Демо Спасибо @m_franz #TTS #VOICECLONING #VOICEDESIGN VK | MAX
Релиз Breeze TTS 2: модель для клонирования голоса и генерации речи в реальном времени

Выход FireRedTTS3: новая модель для клонирования и редактирования голоса

Н@GreenNeuralRobotsAI-инженер
2 мес

Pika выпустила семейство аудиомоделей, включая генератор песен Pika Music

Компания Pika представила линейку аудиомоделей — Pika Music, Pika Soundtrack, Pika SFX и Pika Speech. Флагман линейки, Pika Music, — полноценный генератор песен по типу Suno и MiniMax Music: на вход можно подать текстовый промпт, готовый текст песни, референс голоса, музыкальный референс или всё это одновременно, на выходе — законченный трек длиной до 6 минут.

Запуск связан с усилением конкуренции на рынке генерации музыки: по замечанию источника, «Минимакс покусал Пику», после чего компания выпустила собственное аудио-семейство. Главный козырь Pika Music — цена: она заявлена как до 10 раз дешевле «сопоставимых» музыкальных моделей, что может заметно изменить экономику AI-генерации музыки для контент-мейкеров.

$0.015цена за минуту музыки в Pika Music
6.21 секундысреднее время генерации 90-секундного трека
до 10 раззаявленная дешевизна против конкурентов

Полный разбор →

Интеграция Scenema Audio в ComfyUI

Н@GreenNeuralRobotsAI-инженер
2 мес
ComfyUI-ScenemaAudio Авторы говорилки Scenema Audio прикрутили ее в ComfyUI • клонирование голоса без обучения • генерация речи с эмоциями и интонациями по описанию • поддержка подсказок в квадратных скобках для эффектов • минимум 8 ГБ VRAM • скорость до 2x реального времени • при первом запуске качает ~30 ГБ весов Standalone Docker/API HF ComfyUI #TTS #voicecloning #voicedesign #comfyui

ByteDance выпустила Seed Audio 1.0 — модель для генерации целых звуковых сцен

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 3 мес назад

ByteDance Seed представила Seed Audio 1.0 — аудиомодель, которая по одному промпту генерирует целую звуковую сцену: речь, атмосферу и звуковые эффекты одновременно. Доступ к модели открыт через платформу BytePlusi.

Модель ориентирована на озвучку, подкасты и дубляж: она позволяет жёстко задавать тайминг репликi с точностью до 100 мс и создавать голоса как по текстовому описанию, так и по аудио- или визуальному референсу.

100 мсточность тайминга реплик
2 минутымаксимум аудио за один проход
20+ языковподдерживаемых моделью

Полный разбор →

xAI представили платформу для создания голосовых агентов

Н@GreenNeuralRobotsAI-инженер
3 мес
xAI Voice Agent Builder xAI представили платформу, где можно быстро собрать голосовых агентов под разные сценарии • быстрая сборка голосовых агентов из модулей • интеграция с внешними API и базами. Поддекржка Gmail, Google Calendar, Outlook, Notion и т д • тонкая настройка голоса и интонаций • 25+ языков, включая русский • 80+ голосов на выбор • Клонирование голоса • На аккаунт бесплатно (!) дают номер телефона, с которого агент может звонить #voicemode #agent #online #voicecloning #russian #voiceagent #alm

Это всё на сейчас.