asrСбросить фильтр ×

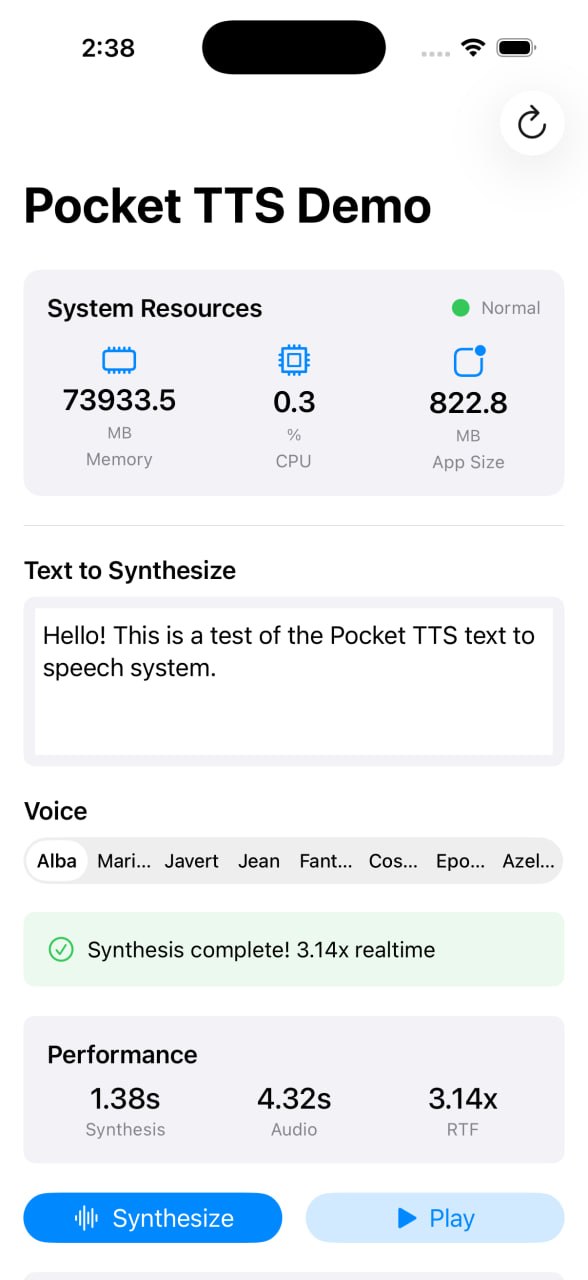
Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

Н@GreenNeuralRobotsAI-инженер
2 нед
Обзор инструментов для синтеза и распознавания речи: RUVoice, Pocket-TTS и новые бенчмарки

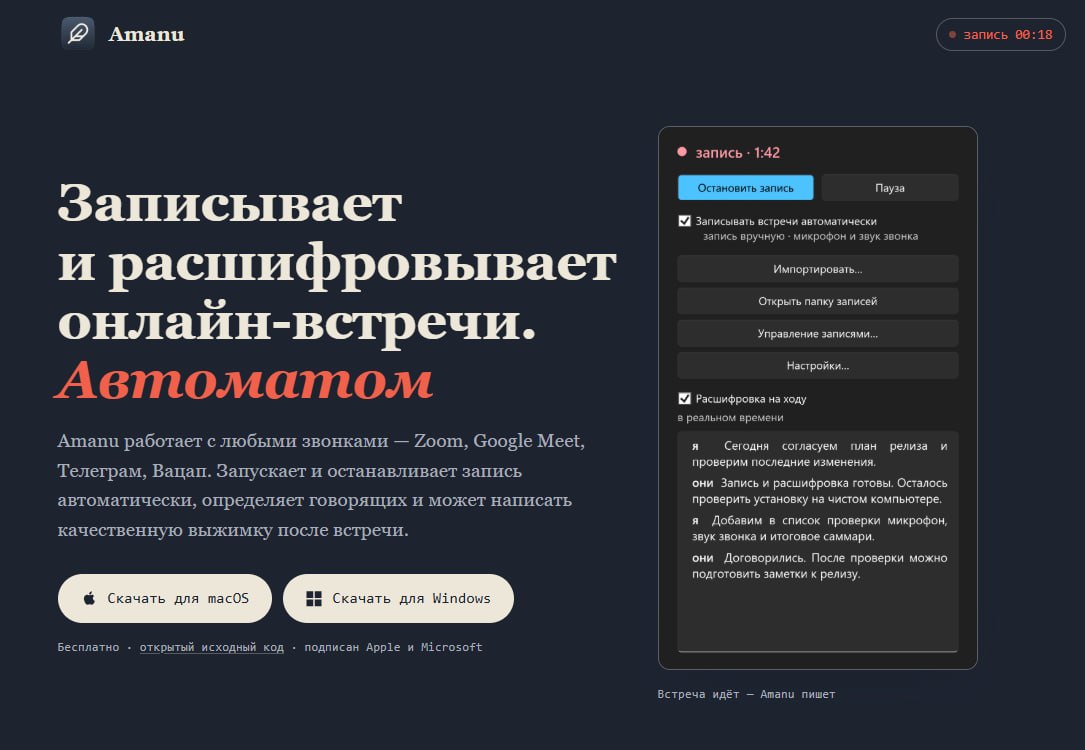
Amanu: бесплатный инструмент для локальной записи и транскрибации звонков

Н@GreenNeuralRobotsAI-инженер
2 нед
Amanu: бесплатный инструмент для локальной записи и транскрибации звонков

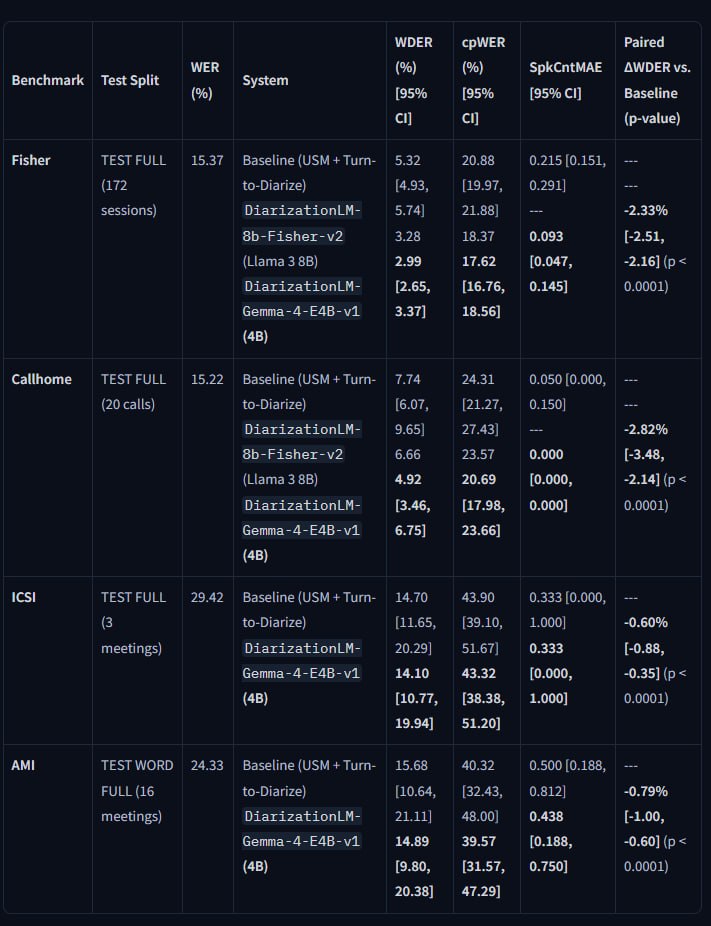
DiarizationLM-Gemma-4-E4B: модель пост-обработки диаризации от Google

Н@GreenNeuralRobotsAI-инженер
3 нед
DiarizationLM-Gemma-4-E4B: модель пост-обработки диаризации от Google

Обзор новых моделей и инструментов для TTS и ASR

Н@GreenNeuralRobotsAI-инженер
3 нед

Audio8 ASR Infinite: нативная стриминговая модель распознавания речи

Н@GreenNeuralRobotsAI-инженер
3 нед
Audio8 ASR Infinite Нативная стриминговая модель распознавания речи. Декодирует 12.5 раз в секунду, память и задержка постоянны даже при 24/7 работе • Неограниченная длина аудио без дрейфа через адаптированный vLLM • Выбор аудио-часов: 80/120/160 мс, задержка 240–560 мс • Китайский и английский Гитхаб HF Демо HuggingChat #ASR MAX

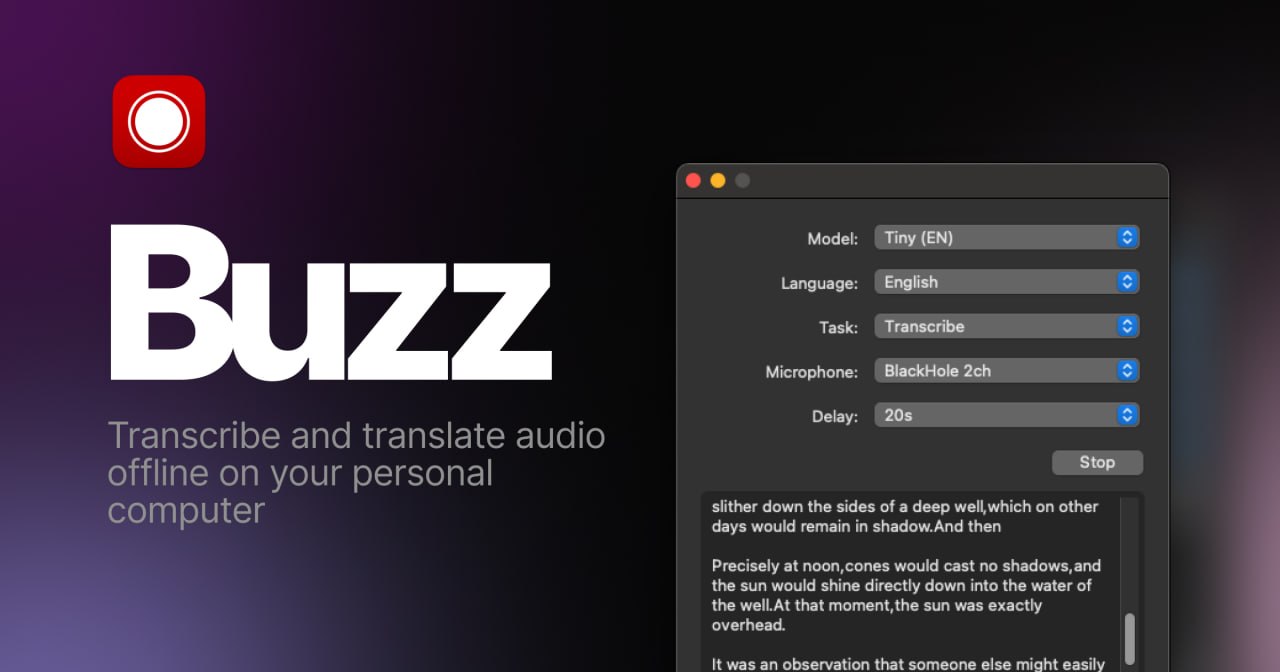
Локальная расшифровка аудио и видео через Whisper

Н@GreenNeuralRobotsAI-инженер
4 нед
Buzz Десктопная локальная расшифровка аудио и видео через Whisper • Обработка аудио и видео файлов • Запись с микрофона • Экспорт текста и субтитров SRT/VTT • Определение разных говорящих #asr #desktop MAX
Локальная расшифровка аудио и видео через Whisper

NetEase Youdao представила модели Confucius4 для потоковой обработки речи

Н@GreenNeuralRobotsAI-инженер
1 мес

Релиз семейства моделей StepAudio 3

Н@GreenNeuralRobotsAI-инженер
1 мес
StepAudio 3 Новые модели от Степана StepAudio 3 Realtime Полнодуплексная аудио-языковая модель. Говорит и слушает одновременно, размышляет вслух не замолкая китайский и английский StepAudio 3 Music Генерация песен: планирует структуру (куплеты, припев, бридж, аранжировку), создает 48-kHz стерео до 5м 30с язык задается описанием песни Помимо этого в семейство вошли говорилка с дизайном голоса Gen, TTS и ASR китайский, английский, японский, корейский, французский, испанский Voice Studio - пока только разговорная, музыка анонсирована #musicediting #dialog #asr #tts #voicedesign

CocktailASR-1 от Xiaomi: распознавание речи в шумной среде

Н@GreenNeuralRobotsAI-инженер
1 мес
CocktailASR-1 (Xiaomi) Распознавание речи, #sota на мультиспикер, заявлены английский и китайский В демо распознавание одного целевого говорящего в шумной обстановке. Сначала извлекает голос конкретного человека по короткому референсу потом расшифровывает его. Остальные голоса и шум игнорируются - Двухстадийная обработка: извлечение голоса цели по референсу + ASR на чистом сигнале - Работает в шуме с несколькими говорящими — фон и посторонние голоса не попадают в распознавание - Короткий референс голоса (до 3 секунд) достаточно чтобы выделить цель Гитхаб HF Демо Спасибо @m_franz #asr VK | MAX

Метод сжатия аудио-энкодера X-AuT для речевых LLM

Н@GreenNeuralRobotsAI-инженер
1 мес
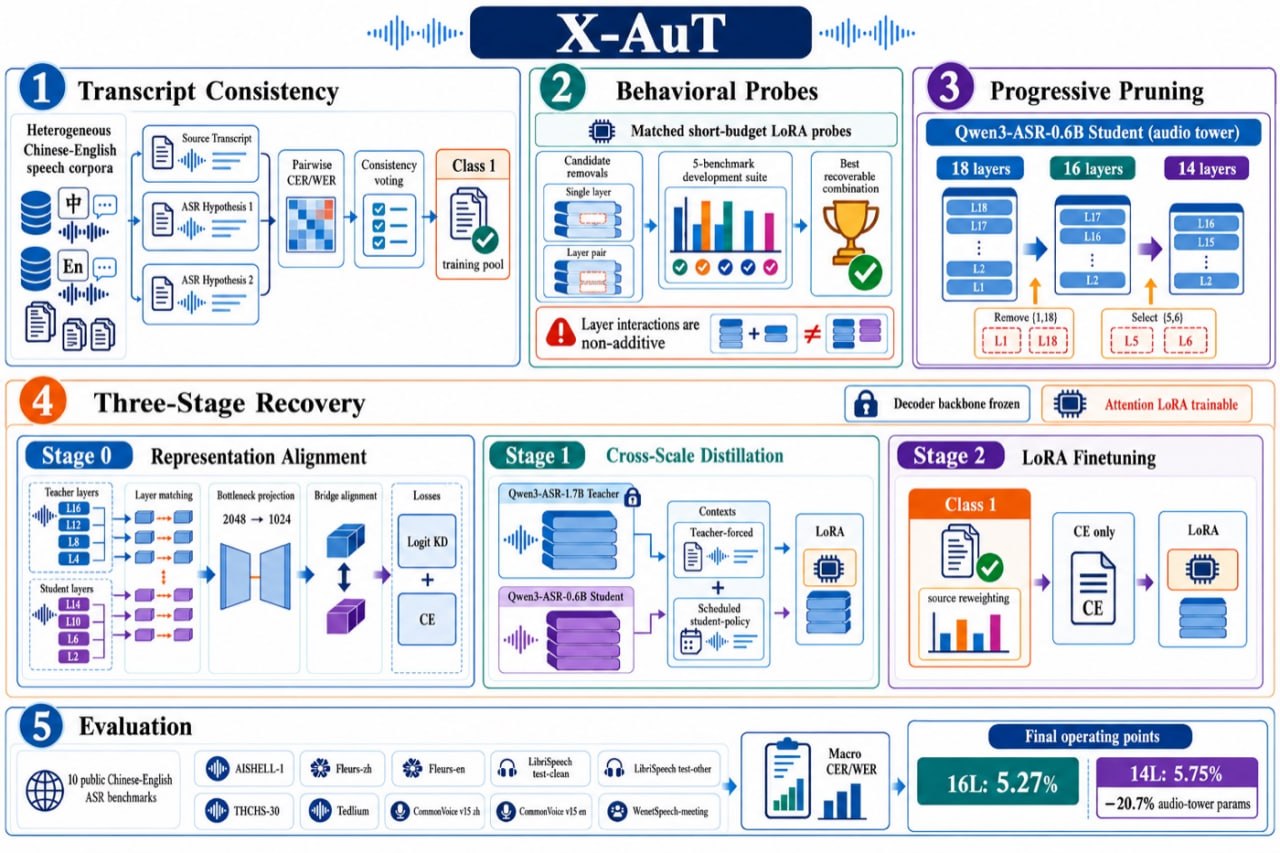
X-AuT Метод сжатия аудио-энкодера для речевых LLM на примере Qwen3-ASR-0.6B. Убирает 4 из 18 слоtв энкодера, восстанавливает качество через дистилляцию от большой модели (1.7B) — в итоге —21% параметров, —21% латентности на автомобильном PPU, ошибка почти не растёт (+2.5%). С автомобильной спецификой. Гитхаб HF #encoder #optimization #asr VK | MAX
Метод сжатия аудио-энкодера X-AuT для речевых LLM

Microsoft представила потоковую модель VibeVoice для распознавания речи

Н@GreenNeuralRobotsAI-инженер
1 мес
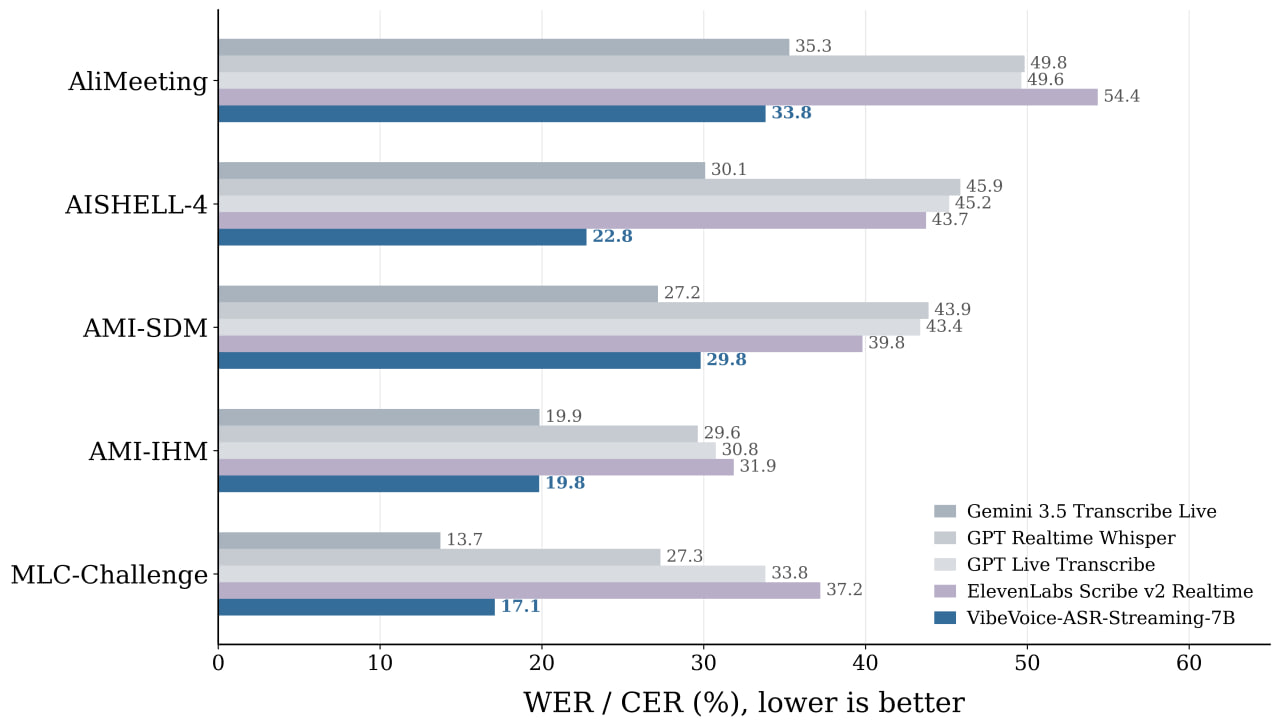
VibeVoice-Streaming ASR Потоковая модель от Microsoft транскрибирует речь по мере поступления аудио. Плюс сразу помечает, кто из спикеров что сказал. Из полезного - поддержка кастомных hotwords, то есть можно заранее задать слова и имена, которые модель должна распознавать точно (имена собственные, термины, названия компаний). Работает с 10 языками включая русский Гитхаб Попробовать #stt #asr #russian #streaming VK | MAX
Microsoft представила потоковую модель VibeVoice для распознавания речи

IBM представила открытые модели Granite 4.2 и Granite Speech 5.0

1 мес
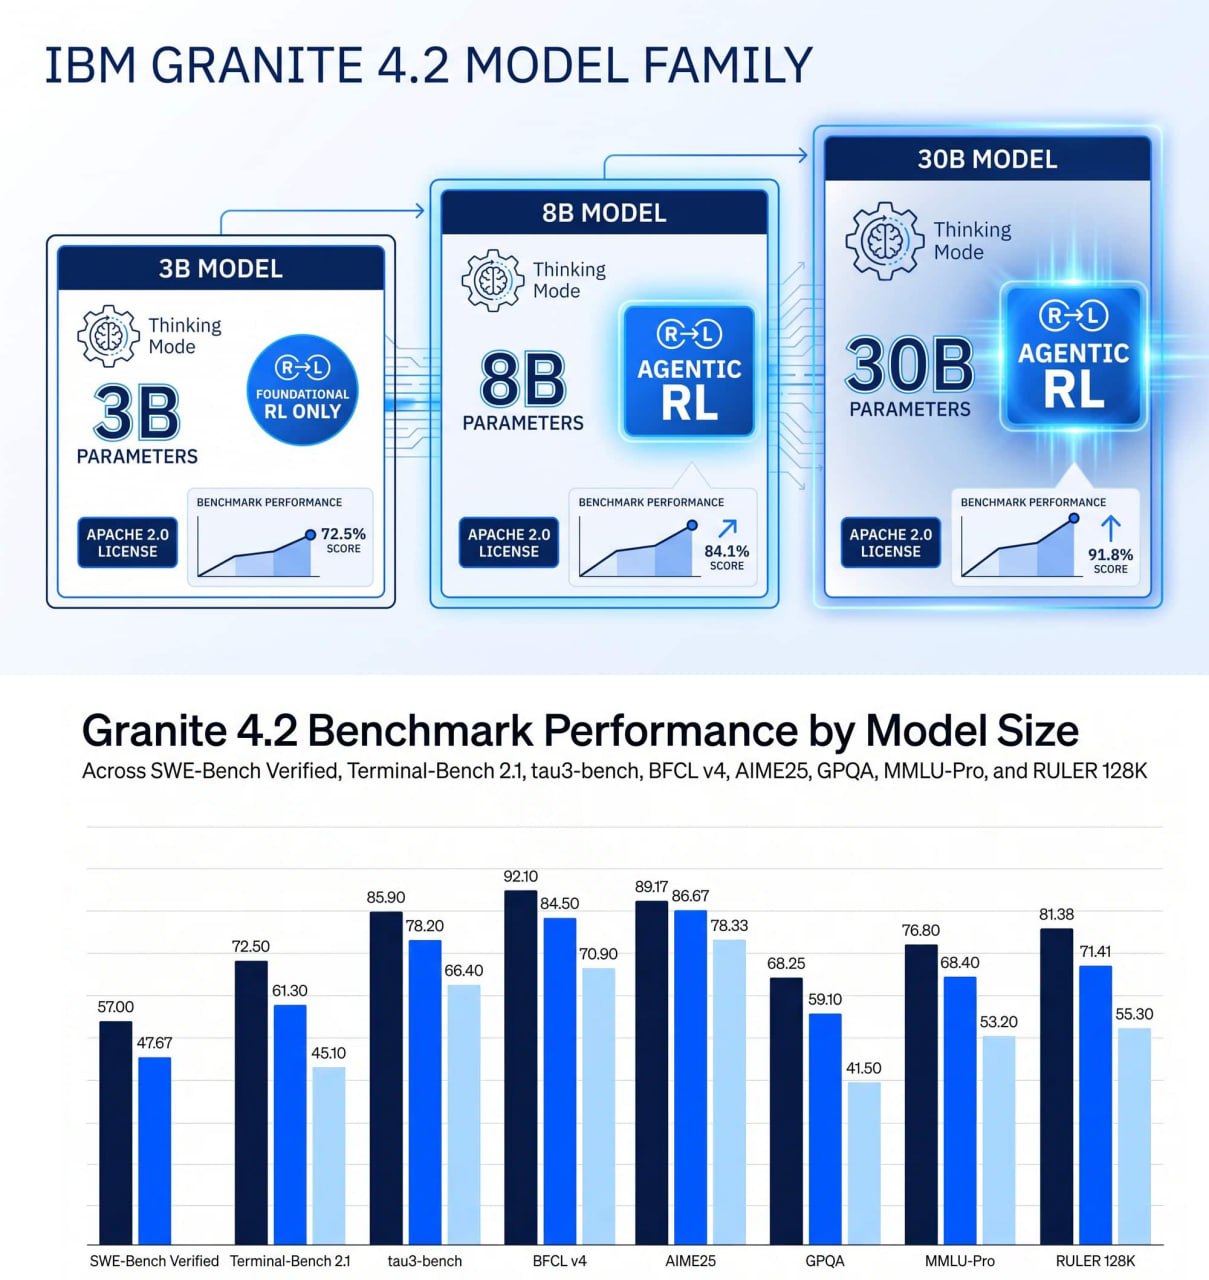
IBM представила открытые модели Granite 4.2 и Granite Speech 5.0

Релиз VibeVoice-ASR-BitNet для работы на CPU

Н@GreenNeuralRobotsAI-инженер
2 мес
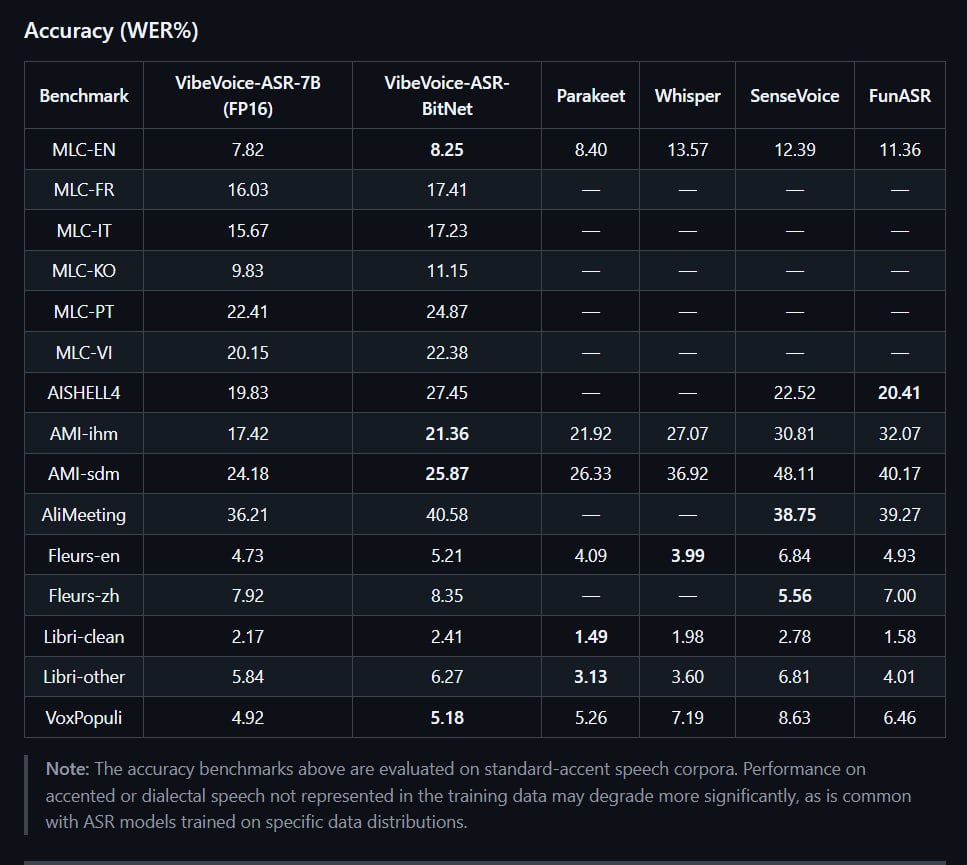
VibeVoice-ASR-BitNet Сжатая версия VibeVoice-ASR для рилтайма на CPU, не требует GPU качество ниже чем у VibeVoice-ASR-7B, зато легкий • работает на x86 (AVX2) и ARM (NEON) • поддерживает несколько языков • размер: 1.58 ГБ (сжато с 4.62 ГБ) • ускорение: в 1.6–2.3 раза быстрее Whisper.cpp Гитхаб HF Демо #asr #realtime #mobile
Релиз VibeVoice-ASR-BitNet для работы на CPU

Релиз модели Qwen-Audio-3.0-ASR-Flash

Н@GreenNeuralRobotsAI-инженер
2 мес
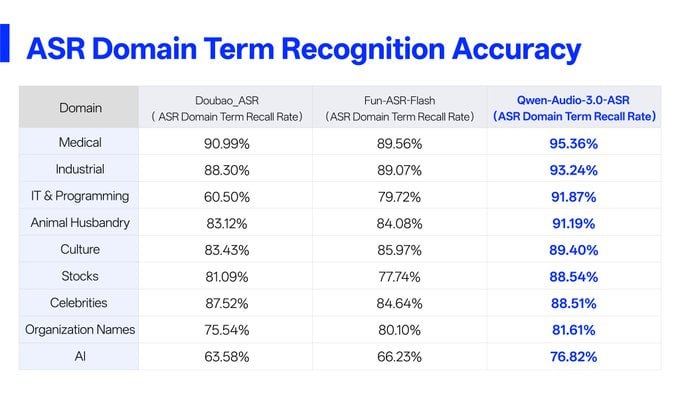
Qwen-Audio-3.0-ASR-Flash Новая коммерческая модель для распознавания речи с улучшенной контекстной осведомленностью и распознаванием терминов в разных доменах • Точное распознавание терминов в специфических областях • Поддержка пользовательских горячих слов Доступны версии: Qwen-Audio-3.0-ASR-Flash-Streaming - потоковое распознавание речи Qwen-Audio-3.0-ASR-Flash-Filetrans - распознавание записанной речи (HTTP API) Qwen-Audio-3.0-ASR-Flash - не потоковое распознавание #asr
Релиз модели Qwen-Audio-3.0-ASR-Flash

Релиз аудио-модели GigaChat3.1-Audio-10B-A1.8B

Н@GreenNeuralRobotsAI-инженер
3 мес
GigaChat3.1-Audio-10B-A1.8B Аудио LLM для работы с длинными записями (2 часа) * Распознавание речи (ASR) - переводит аудио в текст * Перевод - упомянуты русский и английский * Ответы на вопросы по аудио (QA) * Распознавание эмоций * Временная привязка (temporal grounding). находит в какой части аудио происходит то или иное событие. заявлено 48.3 mIoU на задачах для записей до 2 часов • 10B #MoE декодер, активно 1.8B параметров • энкодер GigaAM Демо #alm #qa #asr #stt #translation #russian

Transcribe.cpp: кроссплатформенная библиотека распознавания речи

Н@GreenNeuralRobotsAI-инженер
3 мес
Transcribe.cpp Быстрая и точная кроссплатформенная библиотека распознавания речи на C++. Поддерживает более 60 моделей. Есть ускорение на GPU (Vulkan, Metal, CUDA) Точность подтверждена по WER. Полная совместимость с whisper.cpp. Есть биндинги для Python, JS, Rust, Swift. Гитхаб #asr #transcribe

Сбер выложил в опенсорс речевые модели GigaAM Multilingual и GigaChat Audio

Сбер открыл доступ к двум новым речевым моделям — мультиязычной системе распознавания речи GigaAM Multilinguali и audio-native LLM GigaChat Audioi. Обе модели строятся на аудиоэнкодере, обученном на 2 млн часов речи на 70+ языках с фокусом на страны СНГ, и решают две слабые стороны открытых Speech AI систем: плохую поддержку языков СНГ и деградацию качества на длинных записях.

GigaChat Audio объединяет GigaAM Multilingual и GigaChat3.1-10B-A1.8B и умеет работать с аудио напрямую — без промежуточной расшифровки в текст: ведёт диалог, переводит, классифицирует звук, считывает эмоции по интонации и находит нужные моменты в многочасовых записях с таймкодами. Обе научные статьи по моделям приняты на конференцию Interspeech 2026.

48.3точность локализации событий (IoU) на записях 20–60 мин
60.0 против 43.7балл RuBQ-Audio у GigaChat Audio vs Qwen3-Omni
240 млнпараметров компактной GigaAM Multilingual

Полный разбор →

MOSS-Transcribe-preview-2B: модель для распознавания английской речи

Н@GreenNeuralRobotsAI-инженер
3 мес
MOSS-Transcribe-preview-2B Модель для преобразования английской речи в текст. Использует Qwen3-1.7B-base и Qwen3-Omni-MoE аудиоэнкодер. • распознаёт английскую речь • обучена на публичных #ASR корпусах • дообучена с помощью reinforcement learning • выдаёт транскрипцию аудио Хуже работает с неанглийской речью, акцентами, шумом, перекрывающимися голосами Студия #asr #stt

Релиз Qwen3-ASR: новые возможности распознавания речи

Н@GreenNeuralRobotsAI-инженер
3 мес

Anti-Vocale: локальная транскрипция аудио на Android

Н@GreenNeuralRobotsAI-инженер
3 мес
Anti-Vocale Локальная транскрипция голосовых на Android, без облака • транскрибирует из мессенджеров через меню обмена • несколько моделей ASR: Whisper, Gemma, Parakeet, Qwen3-ASR, Nemotron 3.5 • прогрессивный вывод текста по сегментам • статистика скорости для каждой модели на устройстве • журнал транскрипций с поиском • VAD-удаление тихих сегментов Whisper Turbo large ужат до ~1 ГБ. Есть настройки потоков, индикатор достоверности, плавающее окно. #android #stt #vad

Это всё на сейчас.