DiarizationLM-Gemma-4-E4B: модель пост-обработки диаризации от Google
Н@GreenNeuralRobotsAI-инженер
3 недGoogle представила DiarizationLM-Gemma-4-E4B — компактную модель для исправления ошибок диаризации и меток спикеров в аудио-транскриптах.
Эта модель позволяет значительно повысить точность автоматической расшифровки многоголосых записей.
- Исправляет типичные ошибки распознавания речи, такие как путаница между спикерами.
- Эффективно обрабатывает короткие реплики и длинные монологи без потери контекста.
- Компактный размер (4B) позволяет запускать модель локально на потребительском железе.
DiarizationLM-Gemma-4-E4B
Модель пост-обработки диаризации говорящих от Google. Тонкий дотюн 4B Gemma, который исправляет метки спикеров и снижает ошибки диаризации.
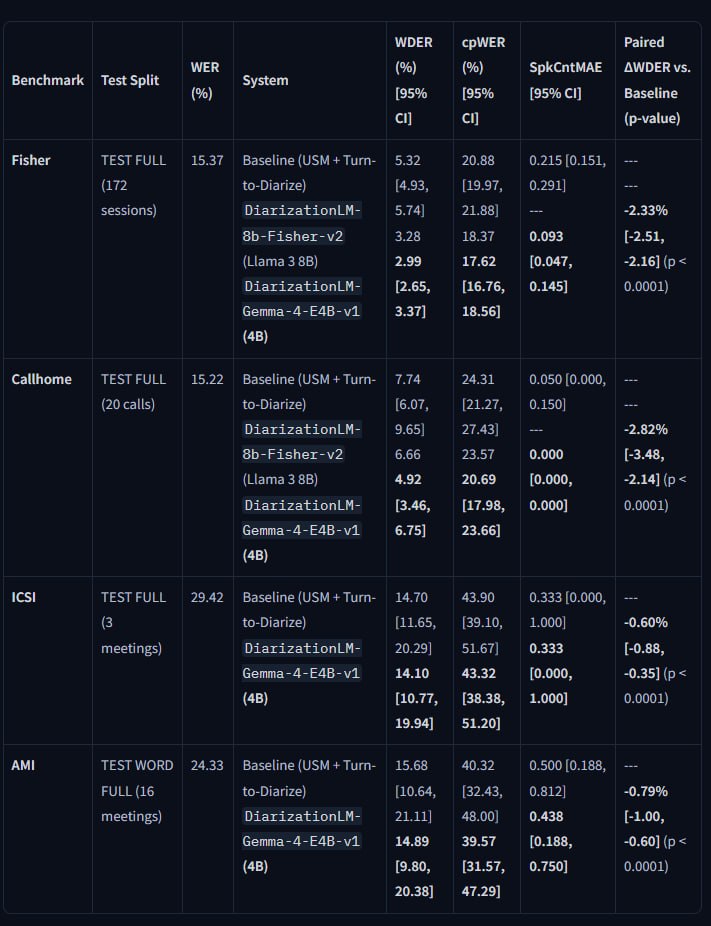
Учит модель чинить короткие вставки (1-5 слов), сохраняя акустические якоря в длинных репликах. Статистически значимые улучшения WDER и cpWER на четырех бенчмарках.
• Исправляет метки говорящих в расшифровке
• Правит границы реплик и «backchannels» (короткие вставки)
• Держит личность спикера в длинных монологах без дрейфа
• Работает из коробки: подаёшь гипотезу с тегами, получаешь исправленную
• 4B параметров (против 8B у старшей версии), Gemma 4 E4B
• #GGUF Q4_K_M ~5.3 ГБ, статус — 2-4 битных квантизации
• #SOTA на Fisher, Callhome, ICSI, AMI (p<0.0001)
Гитхаб
HF
Демо
#diarization #asr
Кратко (AI)
Google выпустила DiarizationLM-Gemma-4-E4B, специализированную модель на базе Gemma 4B для улучшения качества диаризации речи. Модель исправляет ошибки в метках спикеров, корректирует границы реплик и предотвращает дрейф личности в длинных монологах, демонстрируя улучшенные показатели WDER и cpWER.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖