sttСбросить фильтр ×

Black Forest Labs выпустила FLUX 3 Image — единую модель генерации и редактирования изображений

Black Forest Labs представила FLUX 3 Image — модель, объединяющую генерацию и редактирование изображений в одном эндпоинте, без необходимости переключать режимы. Главные новшества: разметка объектов с помощью bounding boxesi для точечного локального редактирования, нативный рендер до 16 МП (против ~4 МП у FLUX.2) и встроенный веб-поиск для сверки визуальных деталей перед генерацией.

Модель уже доступна через API BFL, а также на Replicate, OpenRouter и Krea, коммерческие веса открыты для развёртывания на своей инфраструктуре, а открытые веса обещают «в ближайшие недели».

16 MPмаксимальное разрешение нативного рендера FLUX 3
10 референсовмаксимум изображений-референсов за запрос
$0.607цена генерации одного 4K-изображения

Полный разбор →

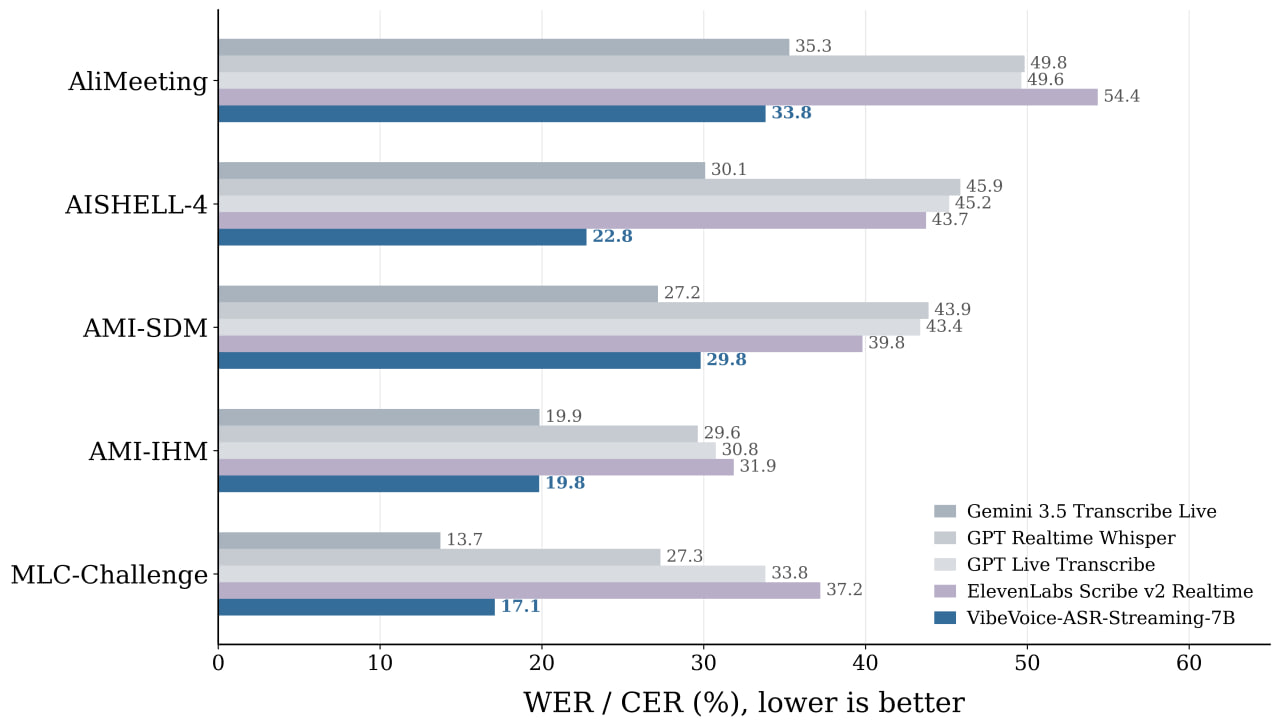
Microsoft представила потоковую модель VibeVoice для распознавания речи

Н@GreenNeuralRobotsAI-инженер
1 мес
VibeVoice-Streaming ASR Потоковая модель от Microsoft транскрибирует речь по мере поступления аудио. Плюс сразу помечает, кто из спикеров что сказал. Из полезного - поддержка кастомных hotwords, то есть можно заранее задать слова и имена, которые модель должна распознавать точно (имена собственные, термины, названия компаний). Работает с 10 языками включая русский Гитхаб Попробовать #stt #asr #russian #streaming VK | MAX
Microsoft представила потоковую модель VibeVoice для распознавания речи

Speko: единый API и роутер для голосовых AI-моделей

A@ai_productAI-инженер
2 мес
Speko: единый API и роутер для голосовых AI-моделей

Релиз модели MOSS-Transcribe-Diarize-0.9B

Н@GreenNeuralRobotsAI-инженер
3 мес
MOSS-Transcribe-Diarize-0.9B Компактная модель (0.9B) для транскрибации и диаризации в одном проходе (обычно для этого нужны 2 разные модели) • структурированный вывод с таймкодами и спикерами • обработка длинных записей • поддержка hotwords и акустических событий Гитхаб HF Демо #transcribe #stt #diarize

Hugging Face и Cerebras представили опенсорсного голосового агента

Н@GreenNeuralRobotsAI-инженер
3 мес
real-time voice AI Hugging Face и Cerebras собрали пример опенсорсного голосового диалогового агента в рилтайме • Gemma 4 VLM на Cerebras — быстрый инференс • Parakeet (Nvidia) — распознавание речи • Qwen3TTS (Alibaba) — синтез голоса • задержка минимальна, отклик почти мгновенный Работает в роботах Reachy Mini (свыше 9000 устройств) Гитхаб Демо #realtime #dialog #voicemode #vlm #multimodal #interactive #tts #stt #duplex

MOSS-Transcribe-preview-2B: модель для распознавания английской речи

Н@GreenNeuralRobotsAI-инженер
3 мес
MOSS-Transcribe-preview-2B Модель для преобразования английской речи в текст. Использует Qwen3-1.7B-base и Qwen3-Omni-MoE аудиоэнкодер. • распознаёт английскую речь • обучена на публичных #ASR корпусах • дообучена с помощью reinforcement learning • выдаёт транскрипцию аудио Хуже работает с неанглийской речью, акцентами, шумом, перекрывающимися голосами Студия #asr #stt

Релиз Qwen3-ASR: новые возможности распознавания речи

Н@GreenNeuralRobotsAI-инженер
3 мес

Anti-Vocale: локальная транскрипция аудио на Android

Н@GreenNeuralRobotsAI-инженер
3 мес
Anti-Vocale Локальная транскрипция голосовых на Android, без облака • транскрибирует из мессенджеров через меню обмена • несколько моделей ASR: Whisper, Gemma, Parakeet, Qwen3-ASR, Nemotron 3.5 • прогрессивный вывод текста по сегментам • статистика скорости для каждой модели на устройстве • журнал транскрипций с поиском • VAD-удаление тихих сегментов Whisper Turbo large ужат до ~1 ГБ. Есть настройки потоков, индикатор достоверности, плавающее окно. #android #stt #vad

audio.cpp: высокопроизводительный C++ движок для аудиоинференса

Н@GreenNeuralRobotsAI-инженер
3 мес
audio.cpp C++ движок для аудиоинференса на ggml. заявлен прирост 1.8–5x по сравнению с Python‑реализациями, плюс есть оптимизация под CUDA. - синтез речи. - распознавание речи. - VAD (Voice Activity Detection) - детекция голосовой активности. - конвертация голоса (изменение тембра, пола и т. д.). - генерация музыки/аудиофрагментов Windows / Linux / macOS #tts #stt #vad #t2m #text2music #voice2voice

Это всё на сейчас.