Метод сжатия аудио-энкодера X-AuT для речевых LLM
Н@GreenNeuralRobotsAI-инженер
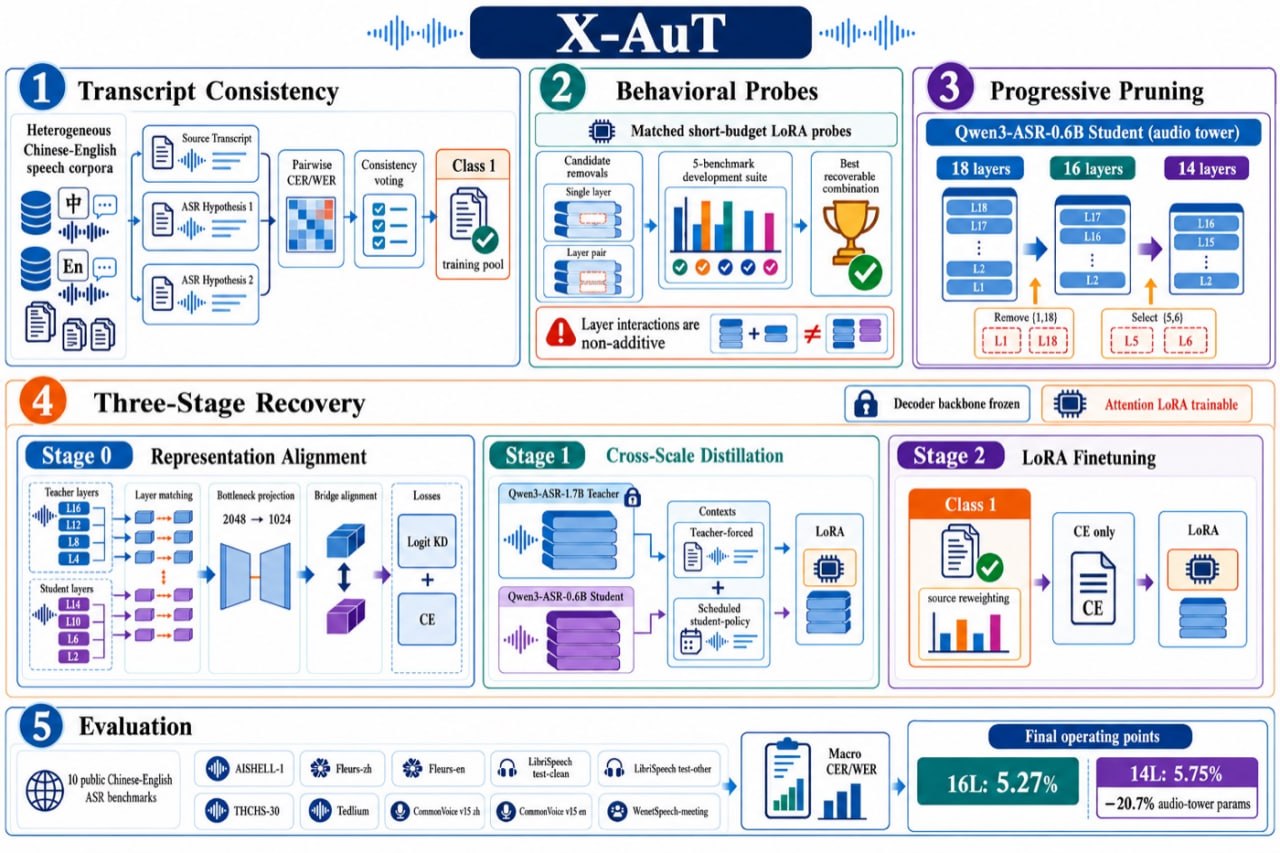
1 месПредставлен метод X-AuT для сжатия аудио-энкодеров в речевых LLM на примере Qwen3-ASR-0.6B, позволяющий снизить латентность на 21%.
Метод позволяет запускать сложные речевые модели на менее мощном «железе» без существенной потери качества.
- Снижение нагрузки на вычислительные ресурсы (PPU) на 21%.
- Ускорение работы речевых интерфейсов в автомобильных системах.
- Возможность использования более компактных моделей в реальном времени.
X-AuT
Метод сжатия аудио-энкодера для речевых LLM на примере Qwen3-ASR-0.6B. Убирает 4 из 18 слоtв энкодера, восстанавливает качество через дистилляцию от большой модели (1.7B) — в итоге —21% параметров, —21% латентности на автомобильном PPU, ошибка почти не растёт (+2.5%). С автомобильной спецификой.
Гитхаб
HF
#encoder #optimization #asr
VK | MAX
Кратко (AI)
Метод X-AuT позволяет оптимизировать аудио-энкодеры для речевых LLM путем удаления части слоев и последующей дистилляции знаний от более крупной модели. На примере Qwen3-ASR-0.6B показано снижение количества параметров и латентности на 21% при минимальном росте ошибки распознавания.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖