Друзья, спасибо большое всем, кто откликнулся про приватный инференс!
Я писал тот пост, чтобы поделиться тем, что нашёл, а вы мне показали, что мои знания категорически отстали и авангард уже давно убежал вперёд.
Вот что вы мне рассказали:
Во-первых, кроме
ZDR, который является юридической договорённостью, читай обещанием, есть ещё вариант с технической гарантией, что данные, которые мы отправляем, никуда не утекут.
Называется это
TEE — Trusted Execution Environment. Эта штука даёт криптографическую гарантию, что с сервера нам отвечает ровно та программа, которую нам обещали, без всяких дополнительных закладок и сохранения данных. Работает благодаря аппаратной поддержке на уровне процессоров
Intel,
AMD и
NVIDIA.
Исследователи регулярно
находят в ней уязвимости, и я уверен, что крупную рыбу АНБ взломает в любом случае, но от массовой слежки это наверняка убережёт.
Получается лучшее от двух миров: никаких капитальных затрат и при этом разумная гарантия безопасности данных, а не просто обещания. Таких провайдеров не очень много, и
GLM-5.3 поддерживают ещё меньше, но есть
Phala,
Tinfoil и
Privatemode, по цене они всего на 20–80% дороже
OpenRouter ZDR.
На этот вариант меня навели создатели
Wisp, это как Claude Cowork, но для юристов, финансистов и всех, кто не хочет отправлять данные в публичные нейросети.
Во-вторых, мы, кажется, недооценили варианты с
квантизацией больших моделей и
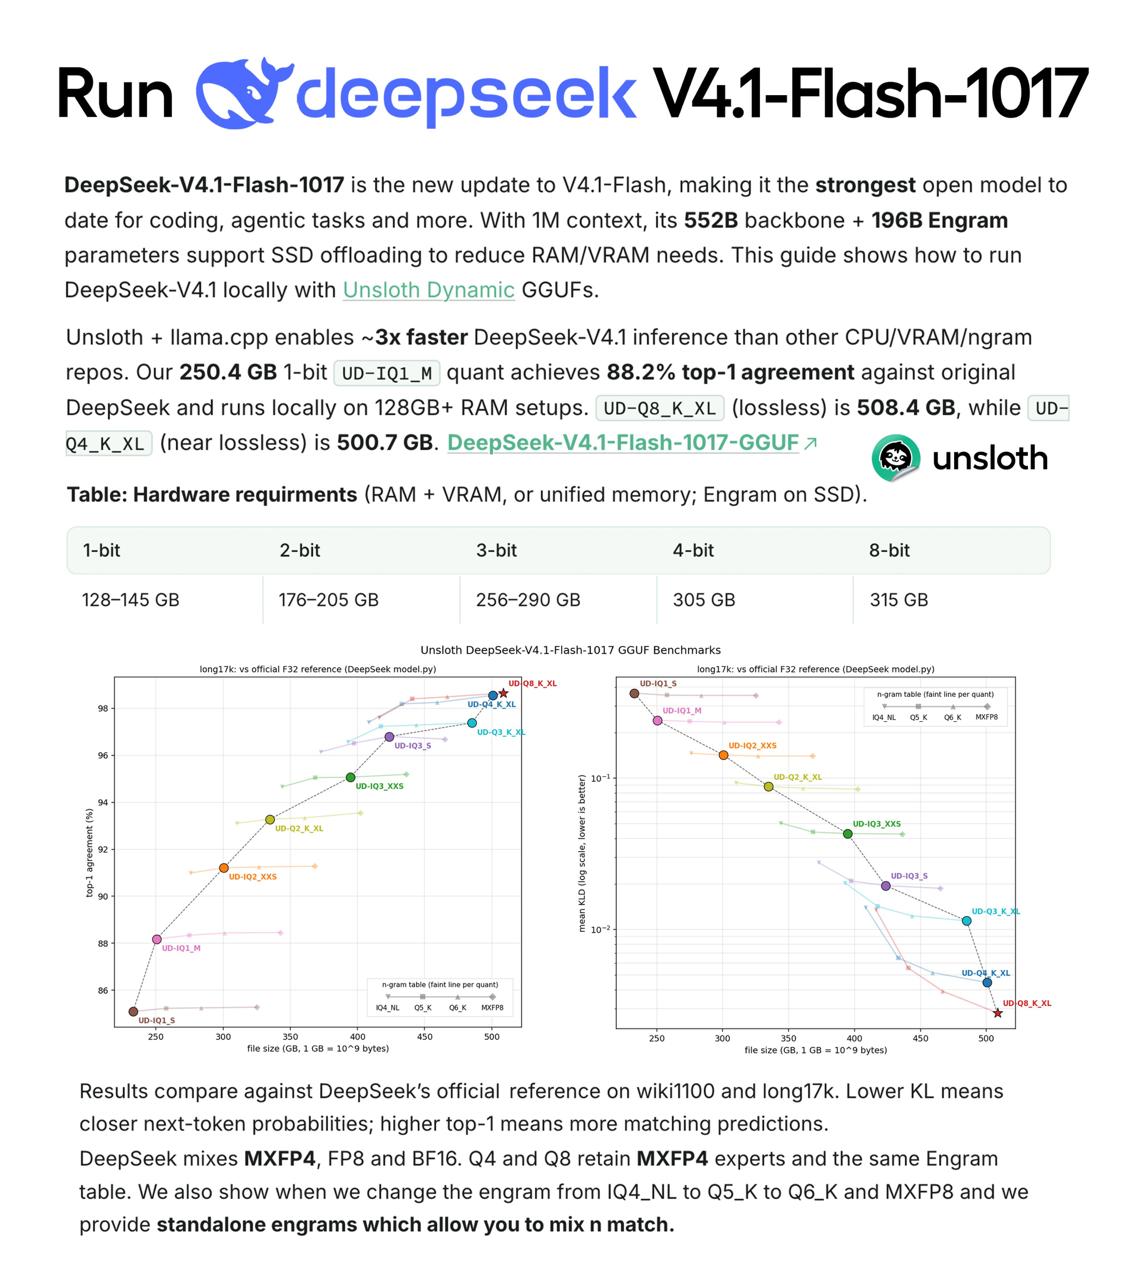
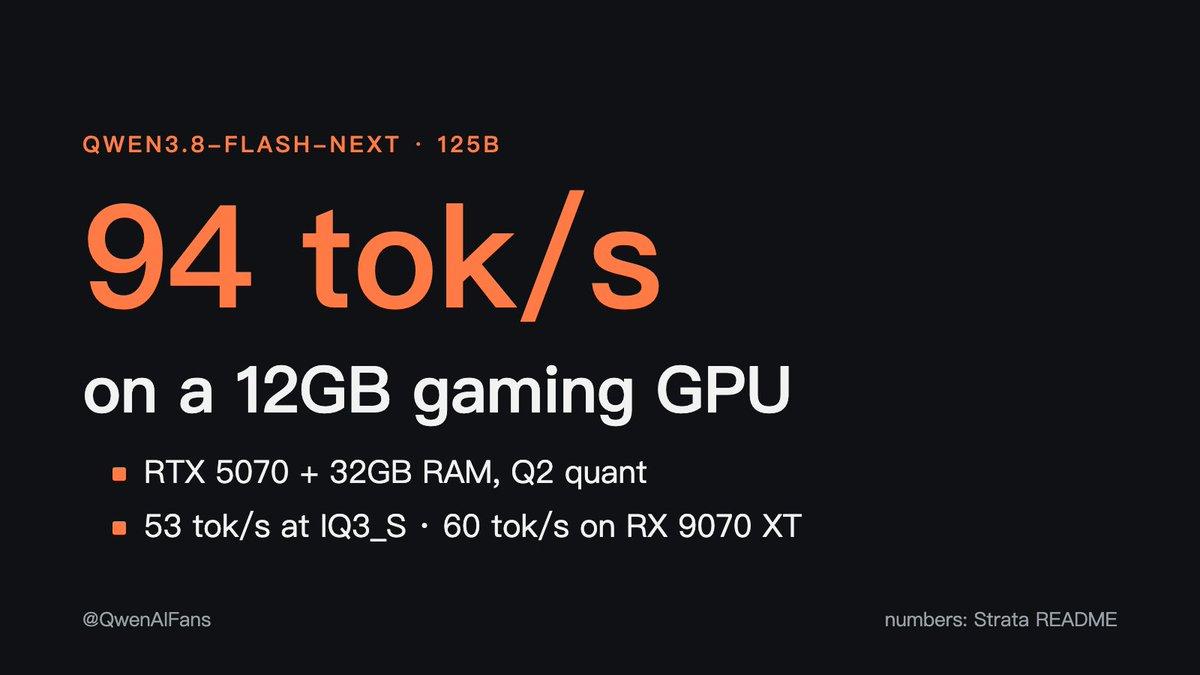
дообучением маленьких моделей на наших данных. Так, порой можно получить сравнимые результаты на радикально более слабом (и дешёвом) железе.
Для своего проекта мы в результате предложили клиенту трёхэтапный план:
Сначала проверяем с помощью TEE/ZDR, что это вообще работает на самых мощных моделях, выясняем границу возможного и прогаем всю обвязку.
Арендуем тачку в облаке, разворачиваем там более простые модели и ищем оптимум по соотношению цены и качества.
Покупаем своё железо.
Ещё раз спасибо большое! Мой папа любил повторять, что лучше чувствовать себя бараном среди мудрецов, чем наоборот. Вот именно так я чувствую себя сегодня и благодарен богу, что вы есть и откликнулись!