Потестил Gemini 4 Argon: новый "Opus" от Google?
Пару дней назад у Google вышла новая модель - Gemini 4 Argon. Так как я в США и сижу на тарифе Ultra, мне она прилетела сразу и с хорошими лимитами. Эти несколько дней я плотно гонял ее по рабочим и бытовым задачам: писал код, работал с документами, делал ресерчи, обсуждал видео-игры.
Еще до релиза мне попадалась новость про внутренние тесты Google - мол, сами сотрудники говорили, что по ощущениям модель очень похожа на Claude Opus. После своих тестов могу это подтвердить. Вот только похожа она на Opus не только в своих плюсах, но и в минусах.
Argon так же, как и Opus, получила способность решать комплексные, нетипичные задачи, но вместе с этим стала очень медленной. Единственный жирный плюс на фоне антропиков - лимиты здесь не улетают со скоростью света.
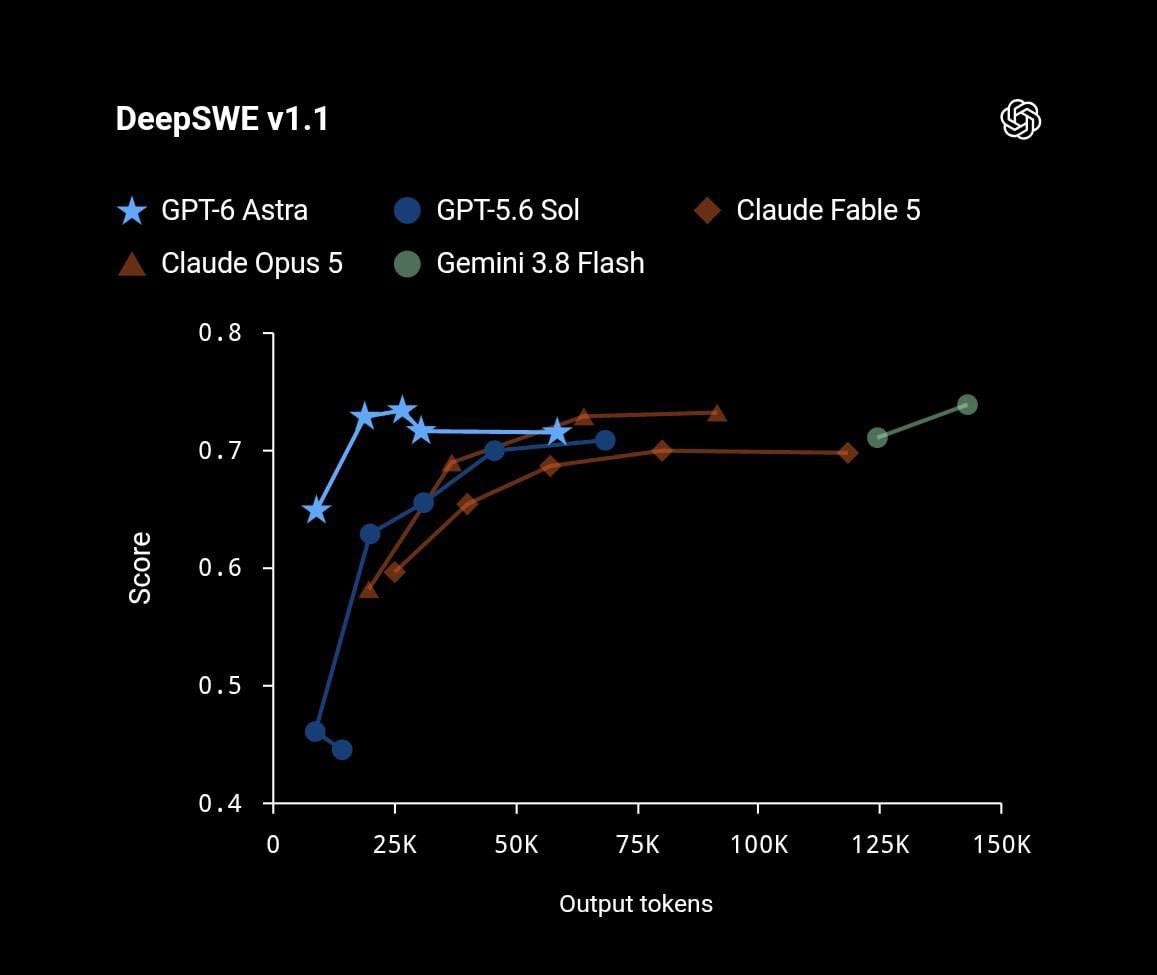
По моим наблюдениям, модель сливает какое-то невероятное количество токенов на ризонинг. Она слишком долго думает даже над простыми вещами, по десять раз все дабл-чекает и заходит с разных сторон. Объективно: для большинства задач такая тяжелая артиллерия просто не нужна. При этом я специально переключал уровни reasoning effort (думал, может, дело в том, что стоит medium или high), но нет - на всех трех режимах она думает одинаково долго. От такой траты токенов объективно ничего, кроме чувства вины за сожженный компьют я не получил.
Пример с кодом: от абсурда до восторга
Сейчас пилю лендинг. Цветовое оформление вынесено в отдельный файл стилей. Мне не понравился один оттенок, и я просто попросил модель поменять его на другой.
Argon решала эту задачу
23 минуты.
Вместо того чтобы просто заменить цветовой код, она все 23 минуты размышляла о природе этого цвета, почему он там вообще оказался, какой оттенок лучше подобрать, и параллельно прочесала цвета вообще во всех файлах проекта. И только после этого сделала то, о чем я просил. Модель как будто учили на текстах Войны и Мира Толстого 😅️️
Для контраста дал ей сложную задачу: собрать форму регистрации с базой данных, прикрутить почтовые рассылки и настроить отбивки о новых регистрациях в Telegram. Плюс попросил предварительно поресерчить, какие вообще есть решения под это дело. Вместе с подробным ресерчем и написанием кода все заняло 17 минут.
А следом закинул баг, который до этого у меня так и не смог починить Opus. Argon ковыряла его 45 минут - и пофиксила. И вот для такой задачи это время уже кажется абсолютно оправданным.
Короче, паттерн очевидный: модель дико усложняет простые вещи, но отлично тащит там, где реально надо подумать.
Что с визуалом и UX
Пробовал использовать ее как спарринг-партнера по дизайну. У меня стандартный пайплайн: я текстом накидываю идеи и прошу предложить несколько вариантов того, как может выглядеть блок (сначала просто концептуально, без кода), а потом понравившиеся варианты уже собираю в коде.
И тут что модели от Anthropic, что OpenAI, что новый Argon - все одинаково фиговые. То, что они предлагают с нуля, на мой вкус выглядит довольно примитивно. На бумаге описание звучит неплохо, но когда доходит до визуализации, вылезает куча проблем: текст не читается, контролы кривые, иерархия плывет. В этом плане дизайнеры пока могут спать спокойно.
Но связка начинает работать, когда включаешь собственную насмотренность. Если закинуть в модель даже неудачный визуальный концепт (хоть сгенеренный ей же итерацией ранее) и прямо ткнуть носом: "здесь не читается шрифт, а тут кнопка странного размера" - вот тогда она выдает красивый, рабочий результат. Но сама, без твоей экспертизы и явных указаний, она на эти косяки внимания не обратит.
Где модель реально тащит
В ресерче и задачах формата "сходи туда, достань то, проанализируй и собери в структуру". Если нужно забрать какие-то внешние материалы, вытянуть из них суть и на основе этого написать код или документ - справляется отлично. Ответы стали заметно четче, модель лучше работает с источниками (особенно если прямо в промпте попросить на них опираться). Поймал себя на том, что в связке с Argon сейчас открываю обычный Google Search чаще, чем Perplexity. Модель ощущается более агентной и самостоятельной.
И снова к вопросу о том, нужны ли нам тяжелые модели
Не так давно я уже писал в канале, что для повседневной рутины флагманские модели нам не нужны, а легкие сетки в связке с человеком работают куда эффективнее. И вот тесты очередного топового релиза заставляют меня снова вернуться к этой мысли.
Глядя на Argon, я еще больше убеждаюсь: в компаниях нужно целиться не в слепую автоматизацию функций, а в точечное усиление людей, у которых уже есть высокая экспертиза. Потому что на задачах, где я четко понимал, чего хочу, с Argon у меня уходило в 3-5 раз больше времени, чем с обычным Gemini Flash. Легкая модель через несколько быстрых итераций с участием человека дает результат быстрее и лучше, чем попытка сразу делегировать задачу тяжелой сетке.
Поэтому на практике весь этот опыт сводится к фильтру из двух простых вопросов перед выбором модели:
1.
Понимаю ли я конечный результат в деталях? Если у меня в голове уже есть четкое видение результата - проще, качественнее и в разы быстрее сделать это через легкий Flash. Если же есть только точка А и размытая точка Б без понятных ограничений и требований - тогда иду в Argon.
2.
Шарю ли я сам в этой теме? Если это знакомая задача, которую я делаю регулярно - снова берем быструю модель. А вот если нужно залезть в новый рынок, незнакомый тип задач или пофиксить сложный баг в коде, где не хватает собственной экспертизы - тут имеет смысл отдать задачу Аргону.
Кто уже успел пощупать обнову - как вам скорость и результаты?
🚀
Влад Корнышев про AI и создание AI-продуктов