optimizaciiaСбросить фильтр ×

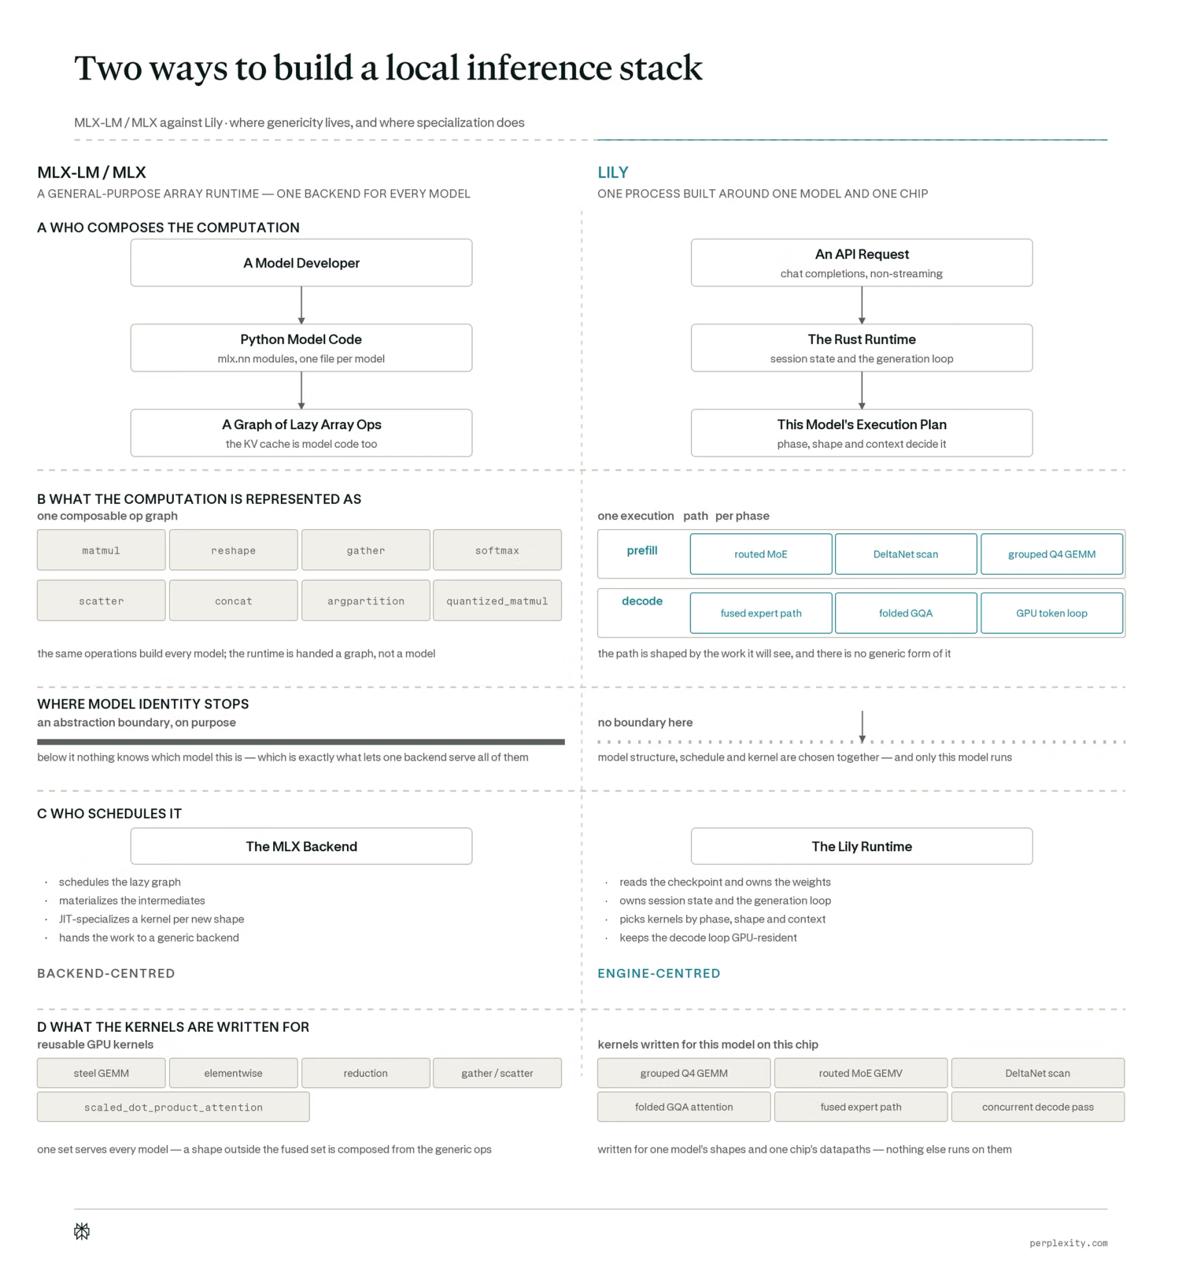
Perplexity представила движок Lily для запуска LLM на Apple Silicon

1 мес
Perplexity представила движок Lily для запуска LLM на Apple Silicon

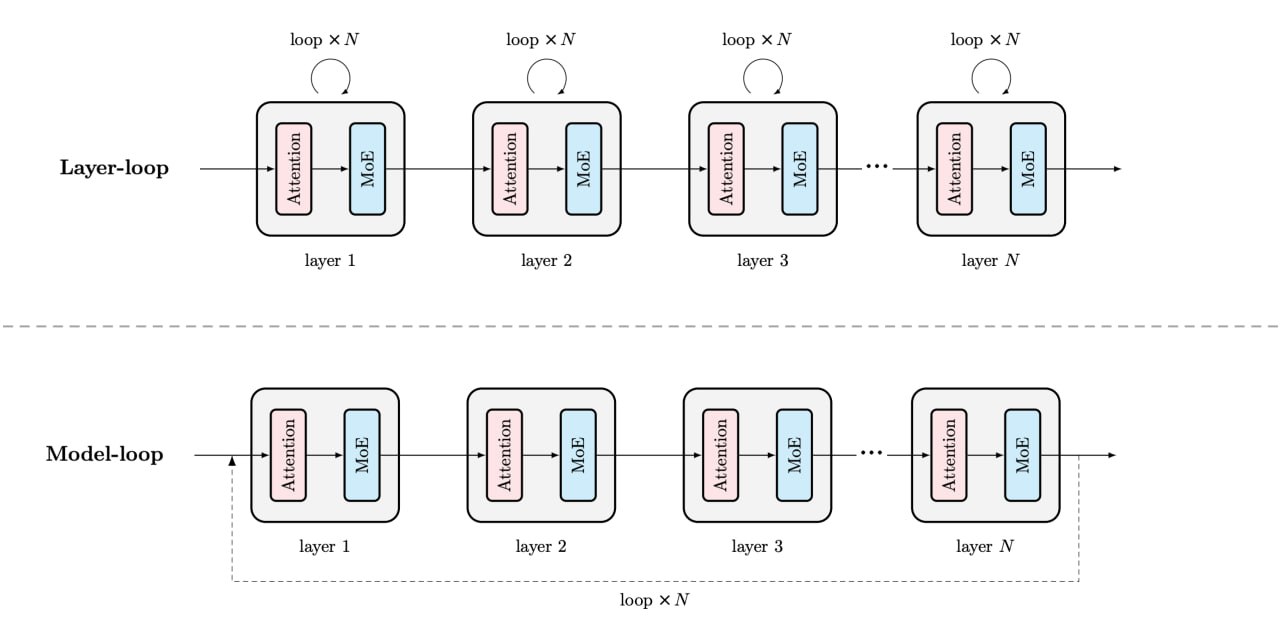
Обзор архитектуры Loopie: эффективный шеринг параметров в LLM

Д@stuffyNLPAI-инженер
1 мес
Обзор архитектуры Loopie: эффективный шеринг параметров в LLM

Что такое Token Eviction в LLM

T@kryak_startupAI-инженер
1 мес
🤬🤬🤬 Token eviction AI is a memory-management method for large language models. It deletes unimportant past data from the Key-Value (KV) cache to save GPU memory and speed up long text processing. https://github.com/openvinotoolkit/openvino.genai/blob/master/site/docs/concepts/optimization-techniques/kvcache-eviction-algorithm.md https://www.emergentmind.com/topics/token-eviction-mechanism

Обзор инструментов и обновлений для Minimax H3

Н@GreenNeuralRobotsAI-инженер
1 мес

Прогноз роста ВВП и стратегия бизнеса в условиях стагнации

П@pogovorim_za_dengi_nadiaмедиа / агрегатор
1 мес

Google запустила агентный видеоанализ в Gemini — экономия токенов до 88%

Google представила Agentic Video Understandingi — новый режим анализа видео в Gemini, в котором модель сама решает, как изучать ролик: выбирает нужные фрагменты, переключается между кадрами, аудио и транскриптом, меняет частоту обработки. Раньше Gemini смотрела видео статично — примерно 1 кадр в секунду плюс аудио, читая заранее размеченные таймстемпы, независимо от того, важен ли момент.

По данным Google, новый подход снижает расход токенов до 88%, стоимость анализа — до 66%, а точность на длинных видео растёт до 7%. Эффект особенно заметен на многочасовых записях — лекциях, вебинарах, записях с камер, где раньше модель тратила огромные ресурсы на кадры, не влияющие на ответ.
88%снижение расхода токенов
66%снижение стоимости анализа
7%рост точности на длинных видео

Полный разбор →

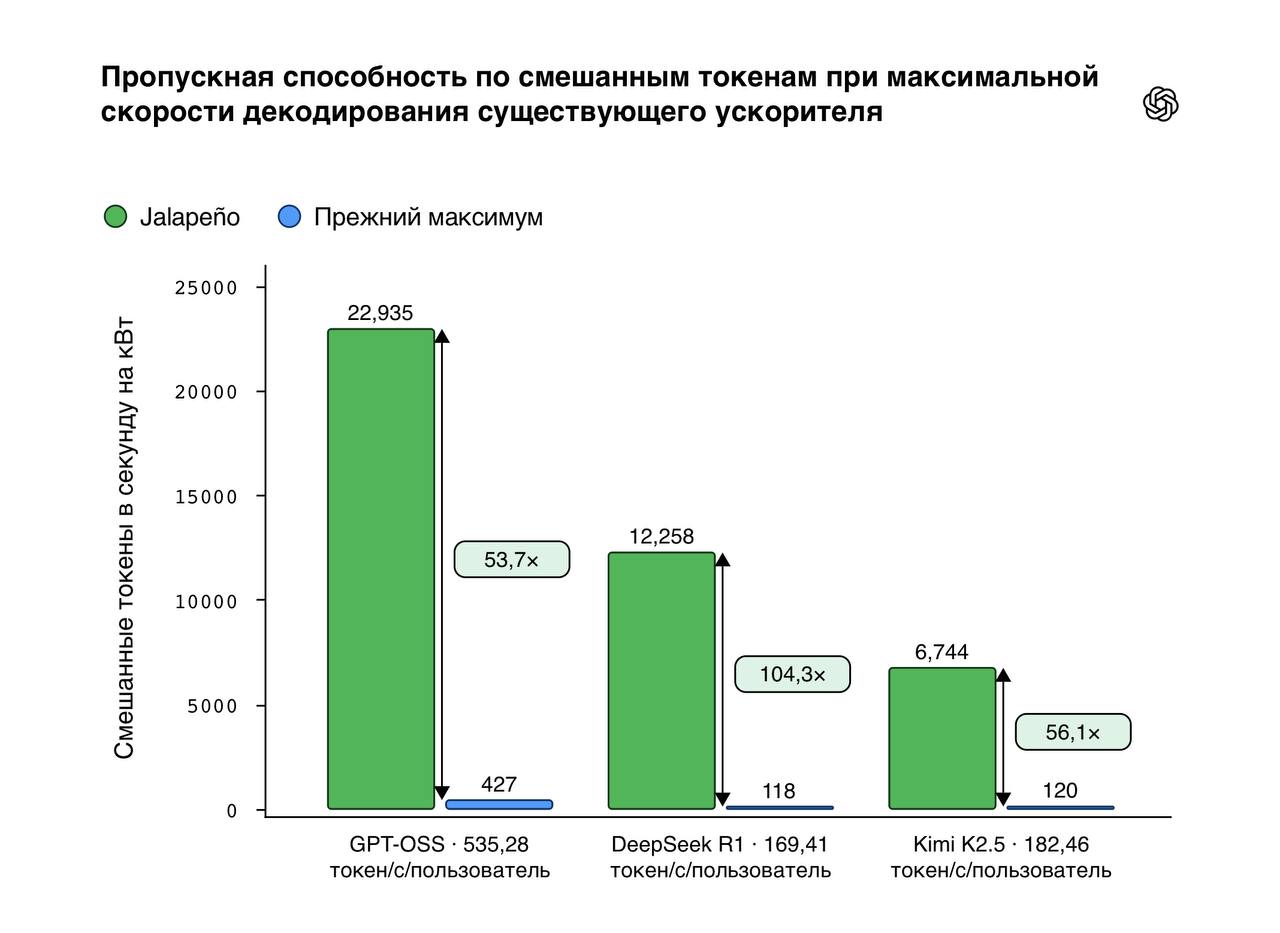
OpenAI о снижении стоимости и масштабировании ИИ

P@prorobotovchannelавтор про «tech»
1 мес
Стек технологий, делающий ИИ дешевле и мощнее 🤖 💬OpenAI директор по финансам Сара Фриар рассказала, как прогресс в области чипов, вычислений, моделей и продуктов помогает создавать более полезный искусственный интеллект в большем объёме и с меньшими затратами. 💬Она объяснила, что улучшения на каждом уровне стека — от аппаратного обеспечения до программного обеспечения — накапливаются, что позволяет компании масштабировать решения с искусственным интеллектом, одновременно снижая их стоимость для пользователей. 💬Подробнее об этом можно узнать в статье OpenAI. ————————— 🤖Подписывайтесь на лучший канал PRO Роботов 📲Мы в MAX
OpenAI о снижении стоимости и масштабировании ИИ

Fastpotify: легкий open-source клиент для Spotify на Rust

Р@remediaгеймдев
1 мес
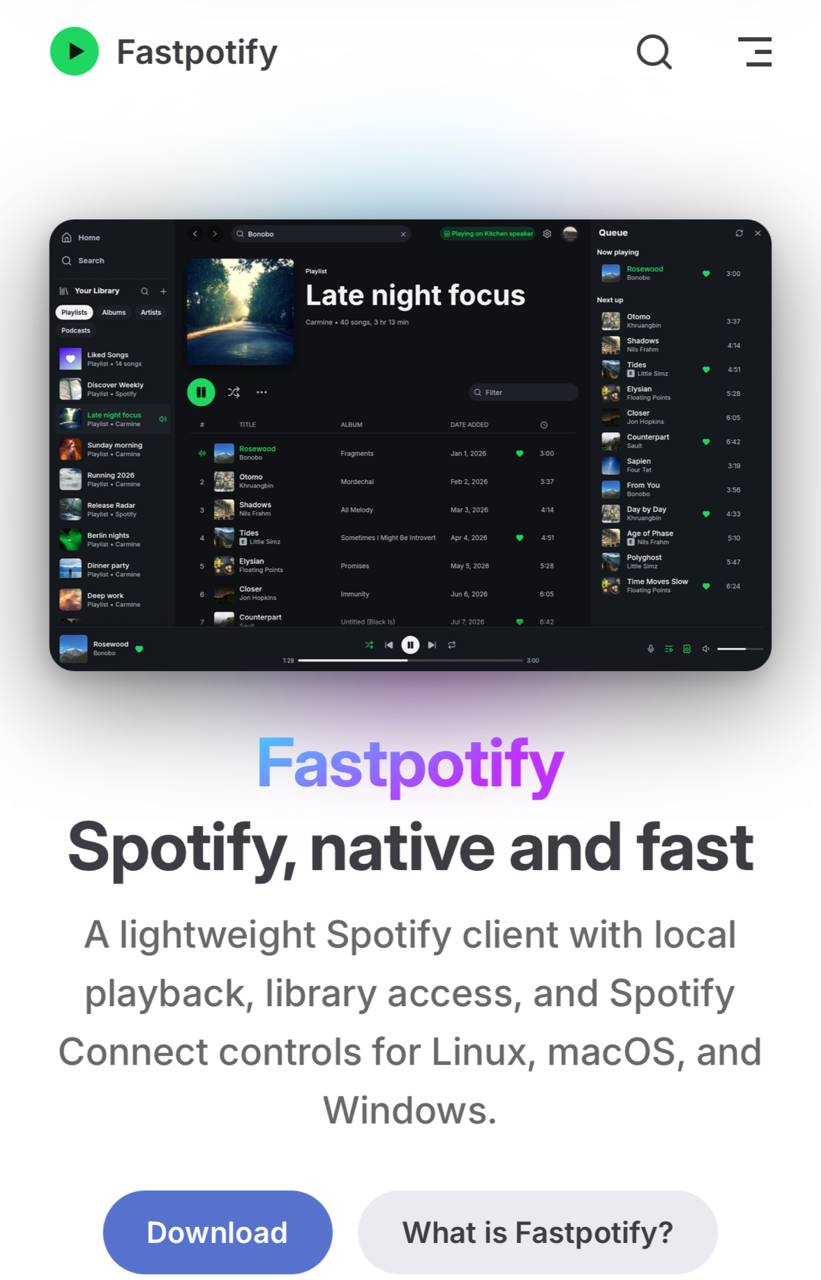
Лёгкий Spotify-клиент, который не жрёт гигабайты памяти — Fastpotify🔈 Это нативное приложение на Rust без встроенного браузера: запускается меньше чем за секунду и обычно занимает 100–250 МБ ОЗУ. При этом сохраняет библиотеку Spotify, поиск, плейлисты и управление музыкой. Можно слушать музыку прямо на компьютере или управлять воспроизведением на телефоне, колонке или телевизоре через Spotify Connect. Есть версии для Windows, macOS и Linux, а проект полностью open source. Забираем — здесь.
Fastpotify: легкий open-source клиент для Spotify на Rust

Google предложила SKILL.state — способ экономить до 98% токенов в долгоживущих AI-агентах

Исследователи Google разработали архитектуру SKILL.statei, которая заменяет накопление всей истории диалога агента на компактное структурированное «execution statei». Вместо ReAct-подхода, где промпт растёт линейно с числом шагов, а суммарный расход токенов — квадратично, модель на каждом шаге получает только инструкции навыка, текущее состояние и последнее наблюдение.

В тестах на синтетической задаче складского управления из 100 шагов экономия токенов достигла 93,8% (по данным Data Secrets) при сохранении и даже росте точности решения задач — важно, что подход применим к любой, в том числе закрытой, модели.

ВыводМеханика: на каждом шаге модель выдаёт JSON-блок с двумя полями — конкретная команда для исполнения в среде и state_patch (изменения относительно прошлого состояния); агент выполняет команду, получает ответ от среды и обновляет state по state_patch

98%экономия токенов на 200 шагах
16.2×разница в токенах на 100-шаговой задаче
54.2%точность SKILL.state на InterCode CTF

Полный разбор →

Монада Канторовича в многоуровневой эволюционной оптимизации

T@kryak_startupAI-инженер
1 мес

Утечка экспериментальной библиотеки NVIDIA DLSS 5

В сеть попала ранняя версия технологии NVIDIA DLSS 5, извлеченная из дистрибутива игры NBA 2K27. Энтузиасты с помощью утилиты RenoDXi начали массово тестировать библиотеку в популярных проектах, включая Control, Cyberpunk 2077, RDR2 и The Last of Us Part II.

На текущем этапе технология демонстрирует нестабильные результаты: от значительного падения производительности до агрессивных искажений лиц персонажей. Несмотря на это, эксперты отмечают потенциал нейронного рендеринга в связке с будущими оптимизациями игровых движков.
158 МБразмер утекшего файла библиотеки
50%падение производительности в 4K

Полный разбор →

Техники рендеринга кожи в The Callisto Protocol

G@GameDEVгеймдев
1 мес
Callisto Protocol used to work on PlayStation 4 and Xbox One. No DLSS5, no flickering, very stable rendering. They even shared on how to achieve that (so anyone can reproduce these results for human skin shaders). #Rendering@GameDEV
Техники рендеринга кожи в The Callisto Protocol

Оптимизация производительности SwiftUI в приложении Qipli

С@svyatamestoAI-инженер
1 мес
Оптимизация производительности SwiftUI в приложении Qipli

Проблема локальных и глобальных максимумов в оптимизации

T@kryak_startupAI-инженер
1 мес
Сейчас работаю над проблемой локальных и глобальных максимумов. Или тупиковая ветвь поиска Олимпа через метод отжига и/или градиентного спуска. Через градиентный спуск мы только Эверест найдем на земле.

Анализ графики воды в игре Kung Fu Panda (2008)

I@igmtvгеймдев
1 мес

Cloudflare оптимизировала DNS-кэш, сэкономив 100 ТБ оперативной памяти

I@itcnewsruавтор про «tech»
1 мес
Cloudflare сэкономила 100 ТБ ОЗУ благодаря оптимизации кода Инженеры Cloudflare уменьшили размер одной кэшированной DNS-записи 1.1.1.1 с 953 до 420 байт. В результате добавление новых записей ускорилось на 43%, а задержка поиска снизилась на 19%. Заодно разработчики заменили динамические Vec и String на структуры фиксированного размера и убрали неиспользуемые поля. Пропускная способность выросла с 625 000 до 893 000 записей в секунду. В итоге Cloudflare освободила около 100 ТБ DDR5 — объём, сопоставимый с памятью примерно 130 серверов компании. Освободившуюся память используют для увеличения DNS-кэшей.
Cloudflare оптимизировала DNS-кэш, сэкономив 100 ТБ оперативной памяти

Выпуск LoRA-адаптеров для ускорения MiniMax-H3

Н@GreenNeuralRobotsAI-инженер
2 мес
MiniMax-H3-Acc-LoRAs LoRA ускорения для MiniMax-H3 от Alibaba PAI Параллельная дистилляция декодирования (PDD). Видео и аудио за 8 шагов вместо обычных 20 - Две версии: FL2VA (от первого кадра) и Ref2VA (по референсам) HF ComfyUI Спасибо @m_franz #optimization #minimaxH3 #lora VK | MAX

Анализ производительности моделей при исправлении багов

T@extremecodeAI-инженер
2 мес
Сидел тут выборочно осматривал на чем конкретно определенные модели факапились. Решил поисправлять за ними тупые баги, что б узнать как конечная имплементация пашет. Ну просто поразительный перформанс листа, особенно когда тебе ниче не нужно рендерить 😄

Перенос KV-кэша между разными LLM: независимая проверка идеи NVIDIA (Cache-2-Cache)

NVIDIA опубликовала статью о переносе KV-кэшiа между разными моделями: маленькая модель делает префилл (читает промпт), большая отвечает, используя её кэш через линейный маппинг — без повторного прогона промпта дорогой моделью. Идея развивает более раннюю концепцию Cache-2-Cache, где обучаемый fuser-модуль передавал в KV-кэш target-модели знания из source-модели; NVIDIA предложила упрощение — обучаемый (в большинстве случаев линейный) проектор, подбирающий наиболее полезные слои source-модели для target-модели.

У статьи NVIDIA не было ни кода, ни анонса — только цифры на 8x H100. Автор одного из телеграм-каналов решил проверить подход на практике: собрал реализацию внутри vLLM на паре Qwen3 0.6B и 1.7B на двух видеокартах 3090 и подтвердил, что метод действительно работает и даёт прирост скорости, хотя и меньший, чем заявляли авторы оригинальной статьи на топовом оборудовании.

ВыводНезависимая реализация: собственный KV-коннектор для vLLM, перенос кэша через /dev/shm, ridge-маппер с решением в замкнутой форме, обучение — 15 минут на датасете FineWeb

x2.22ускорение TTFT в независимом тесте
17-25xзаявленное NVIDIA ускорение на 14B/32B с NVLink
94%сохранённое качество по HellaSwag

Полный разбор →

Ещё ↓