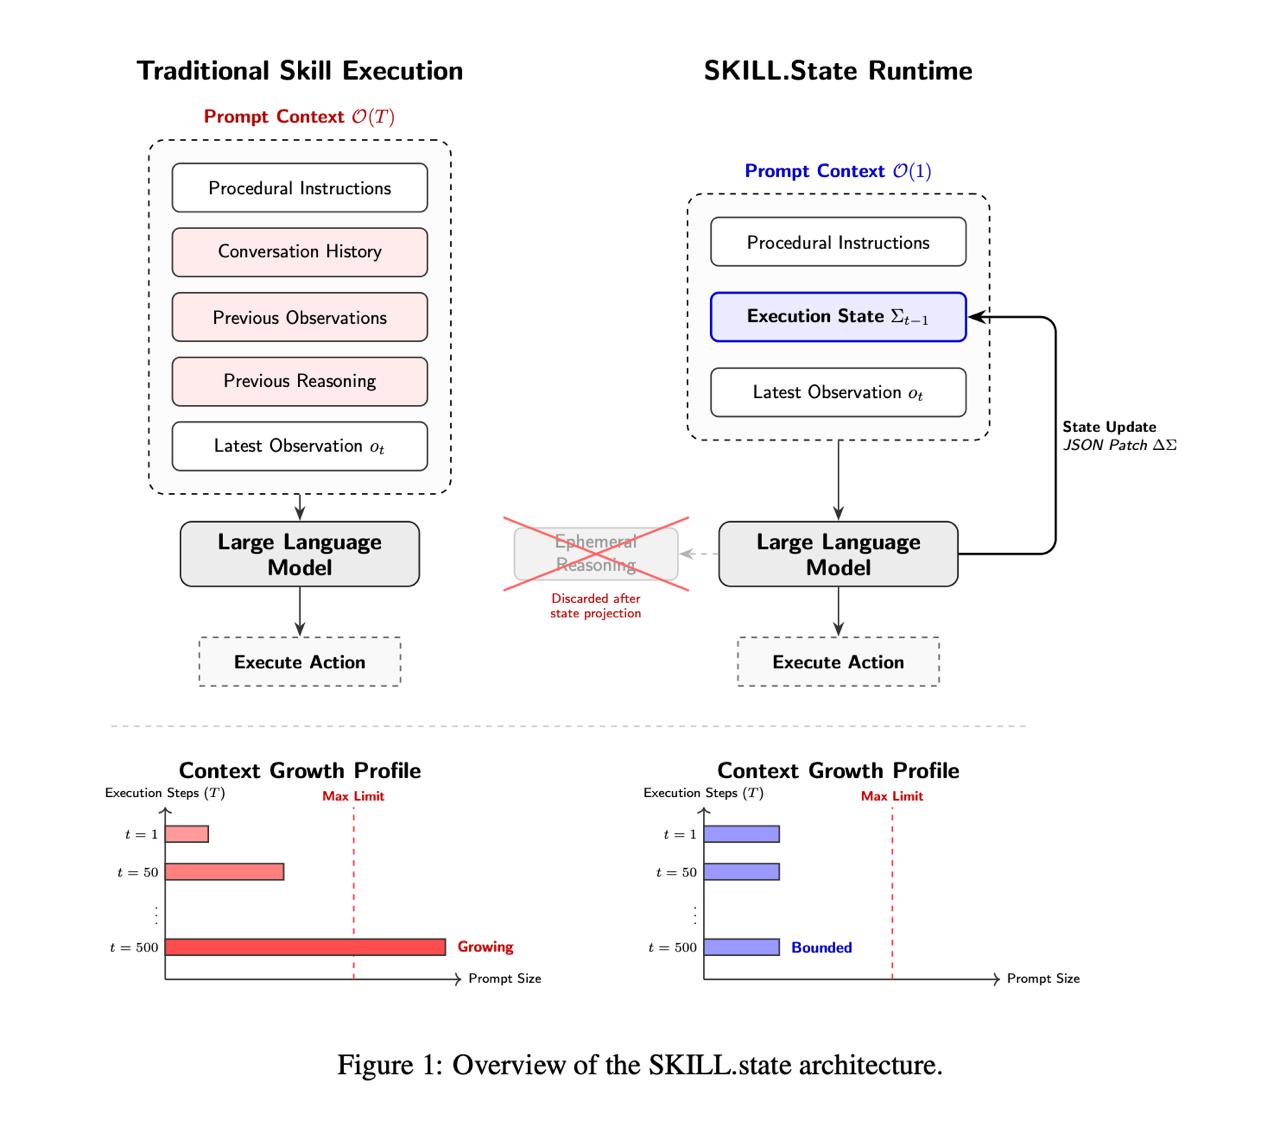
– На каждом шаге модель, помимо рассуждений, выдает JSON-блок с двумя полями: (1) конкретная команда, которую агент должен исполнить в среде; (2) state_patch – информация о том, что изменилось отсительно прошлого состояния. – Агент исполняет команду и получает ответ от среды, а в текущий state вносятся изменения в соответствие со state_patch. – На следующий шаг передается: измененный state, системный промпт и последний ответ от среды. Никаких предыдущих сообщений, рассуждений модели с прошлых шагов и прочего.Таким образом, размер промпта на каждом шаге становится константным, а суммарные затраты токенов растут линейно. На синтетическом бенчмарке управления складом на 100 шагах SKILL.state экономит 93.8% токенов, на 200 шагах – 98%. Чем длиннее контекст, тем разрыв драматичнее. На реальных бенчмарках экономия чуть меньше, но при этом SKILL.state кое-где еще и выигрывает в точности. Например, на InterCode CTF выбивает 54.2% против 40-45% у бейзлайнов. Связано это с тем, что представление задачи через state получается более чистым и свободным от засоряющих фактов и неверных гипотез из прошлого контекста. Это решение можно применить к любой, даже закрытой, модели, просто поменяв рантайм. В Appendix A приводится необходимый шаблон промпта, так что можно брать и пользоваться.
Google представили архитектуру SKILL.state для экономии токенов в работе агентов
D@data_secretsAI-инженер
1 месИсследователи Google предложили архитектуру SKILL.state, которая заменяет накопление истории диалога структурированным состоянием, экономя до 98% токенов.
Новый метод позволяет значительно удешевить и ускорить работу ИИ-агентов в сложных задачах.
- Снижение затрат на токены до 98% при длинных сессиях.
- Повышение точности агентов за счет очистки контекста от лишней информации.
- Метод применим к любым моделям, включая закрытые, через изменение рантайма.
Исследователи из Google нашли способ экономить до 98% токенов на длинных сессиях с агентами
https://arxiv.org/abs/2608.26263
Авторы предлагают архитектуру SKILL.state: вместо накопления истории диалога – явное, изменяемое структурированное состояние выполнения.
Обычно агенты работают по принципу ReAct-стиля, то есть на каждом шаге модели заново скармливают весь накопленный диалог. Из-за этого промпт каждый раз растет линейно, а суммарное потребление токенов за весь запуск – квадратично. Плюс модель вынуждена каждый раз заново вычленять текущее состояние задачи из горы текста, что иногда провоцирует галлюцинации.
В статье предлагается вместо этого на каждом шаге отправлять модели явное изменяемое структурированное состояние выполнения (в статье это называется execution state). Как это работает:
Кратко (AI)
Исследователи Google разработали архитектуру SKILL.state, которая вместо передачи всей истории диалога использует обновляемое структурированное состояние выполнения. Это позволяет поддерживать размер промпта константным, значительно снижая расход токенов и повышая точность работы агентов за счет исключения лишнего контекста.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖