Perplexity представила движок Lily для запуска LLM на Apple Silicon
M@machinelearning_interviewAI-инженер
1 месPerplexity разработала движок Lily для оптимизации запуска Qwen3.6-35B-A3B на Mac, показав значительный прирост скорости по сравнению с MLX-LM.
Это важный шаг к эффективному запуску мощных нейросетей прямо на пользовательских компьютерах без облачных вычислений.
- Позволяет запускать тяжелые модели локально с высокой скоростью.
- Снижает зависимость от облачных API и повышает приватность данных.
- Демонстрирует возможности оптимизации ПО под специфическое «железо» Apple.
🔥 Perplexity разогнала локальный запуск LLM на Apple Silicon
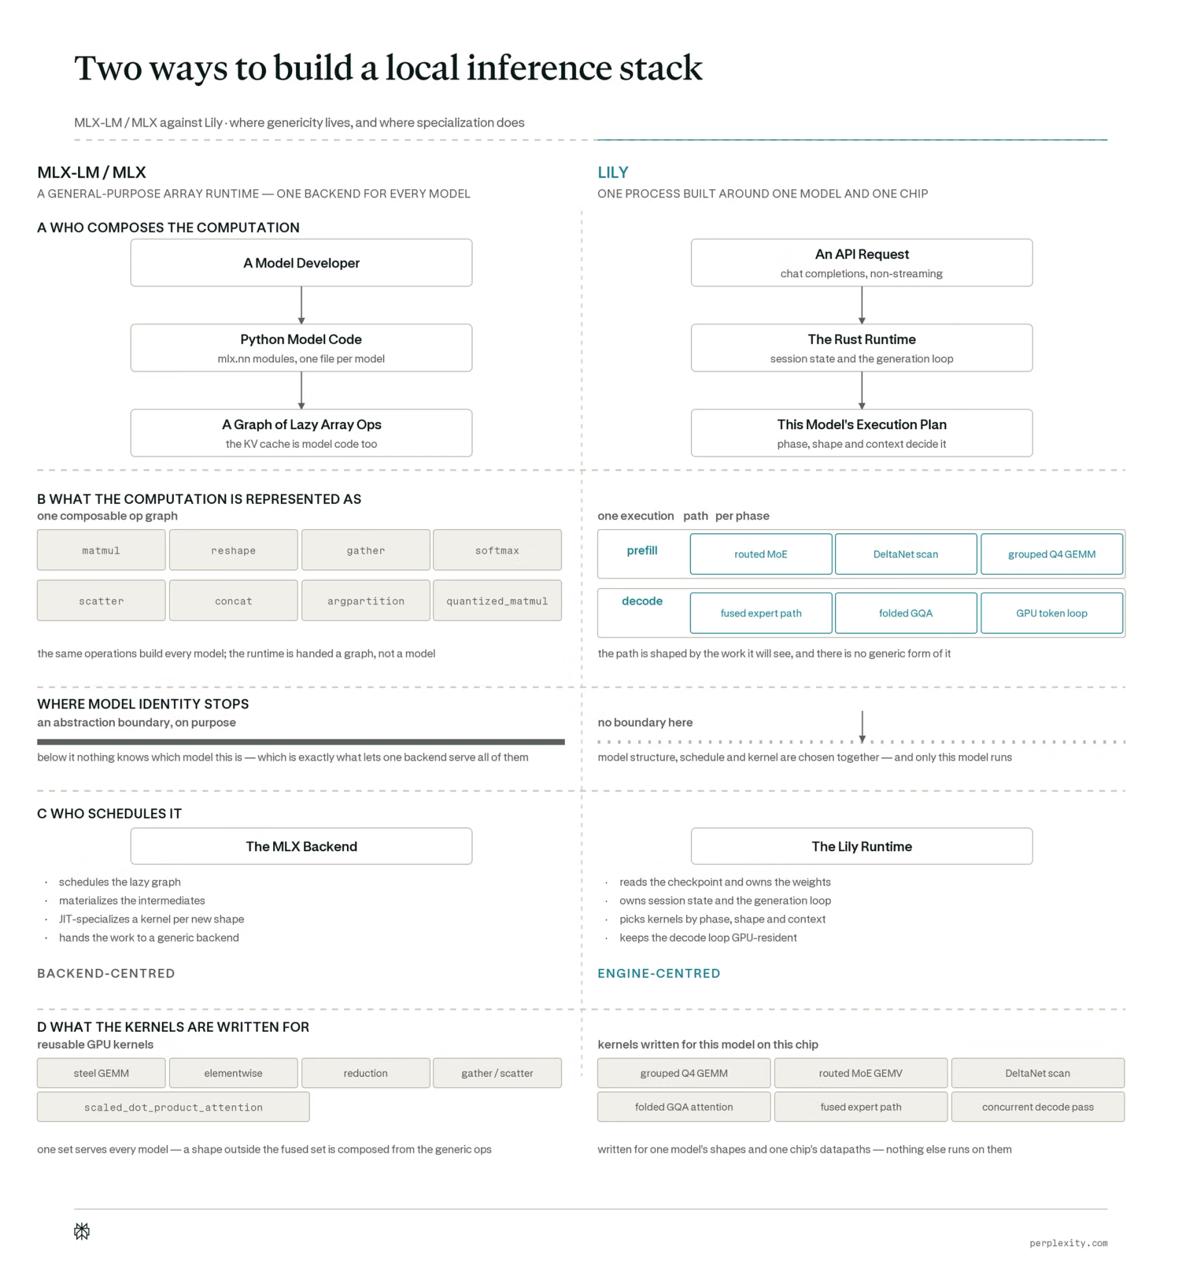
Компания сделала собственный движок Lily специально под Mac и Qwen3.6-35B-A3B без PyTorch и MLX в цепочке выполнения.
На MacBook Pro с M5 Max и 128 ГБ unified memory:
- prefill: 5749 ток/с
- генерация: 186,6 ток/с
- в среднем prefill быстрее MLX-LM в 1,23×
- decode — в 1,35×
Что внутри:
- runtime на Rust
- собственные Metal-кернелы
- MoE-routing остаётся на GPU
- оптимизация отдельно под prefill и decode
- KV-cache и Gated DeltaNet заточены под Apple GPU
- 35B-модель ужата до 19,4 ГБ в 4-bit
На длинном контексте отдельная оптимизация attention дала до +40% скорости на 128K токенов.
Сам Lily Perplexity обещает скоро открыть.
https://www.perplexity.ai/hub/blog/optimizing-on-device-inference-for-apple-silicon
Кратко (AI)
Компания Perplexity представила собственный движок Lily, оптимизированный для запуска больших языковых моделей на чипах Apple Silicon. Решение позволяет значительно ускорить работу модели Qwen3.6-35B-A3B на MacBook Pro, обходя стандартные инструменты вроде MLX-LM за счет использования Rust и кастомных Metal-кернелов.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖