optimizaciiaСбросить фильтр ×

Anthropic добавил в Claude Code скиллы build-eval и hillclimb для автоматической оптимизации продуктов

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 4 нед назад

Anthropic выпустил для Claude API/Claude Code два новых скилла — build-eval и hillclimbi, которые превращают создание приложений и бизнес-процессов в автоматическую оптимизацию по метрикам, а не в написание кода вручную. Достаточно задать цель (например, «100% клиентов, готовых оплатить, доходят до конца процесса»), и Claude сам анализирует логи, тикеты поддержки и трейсы, генерирует гипотезы, вносит изменения и проверяет, улучшилась ли метрика — по одному изменению за раунд.

Подход не убирает человека из процесса, а меняет его роль: вместо придумывания и реализации гипотез владелец продукта теперь формулирует чёткие, не поддающиеся подмене метрики успеха. По мнению одного из авторов, это необходимое условие для «software factories», самоуправляемых продуктов и AI-native организаций.

34%снижение стоимости вызова после кэша
2.6 разарост скорости при low thinking effort
$17стоимость полного теста на 616 кейсах

Полный разбор →

Скрытые потери бизнеса и их влияние на прибыль

Ф@Founder_Startupмедиа / агрегатор
4 нед
Скрытые потери бизнеса и их влияние на прибыль

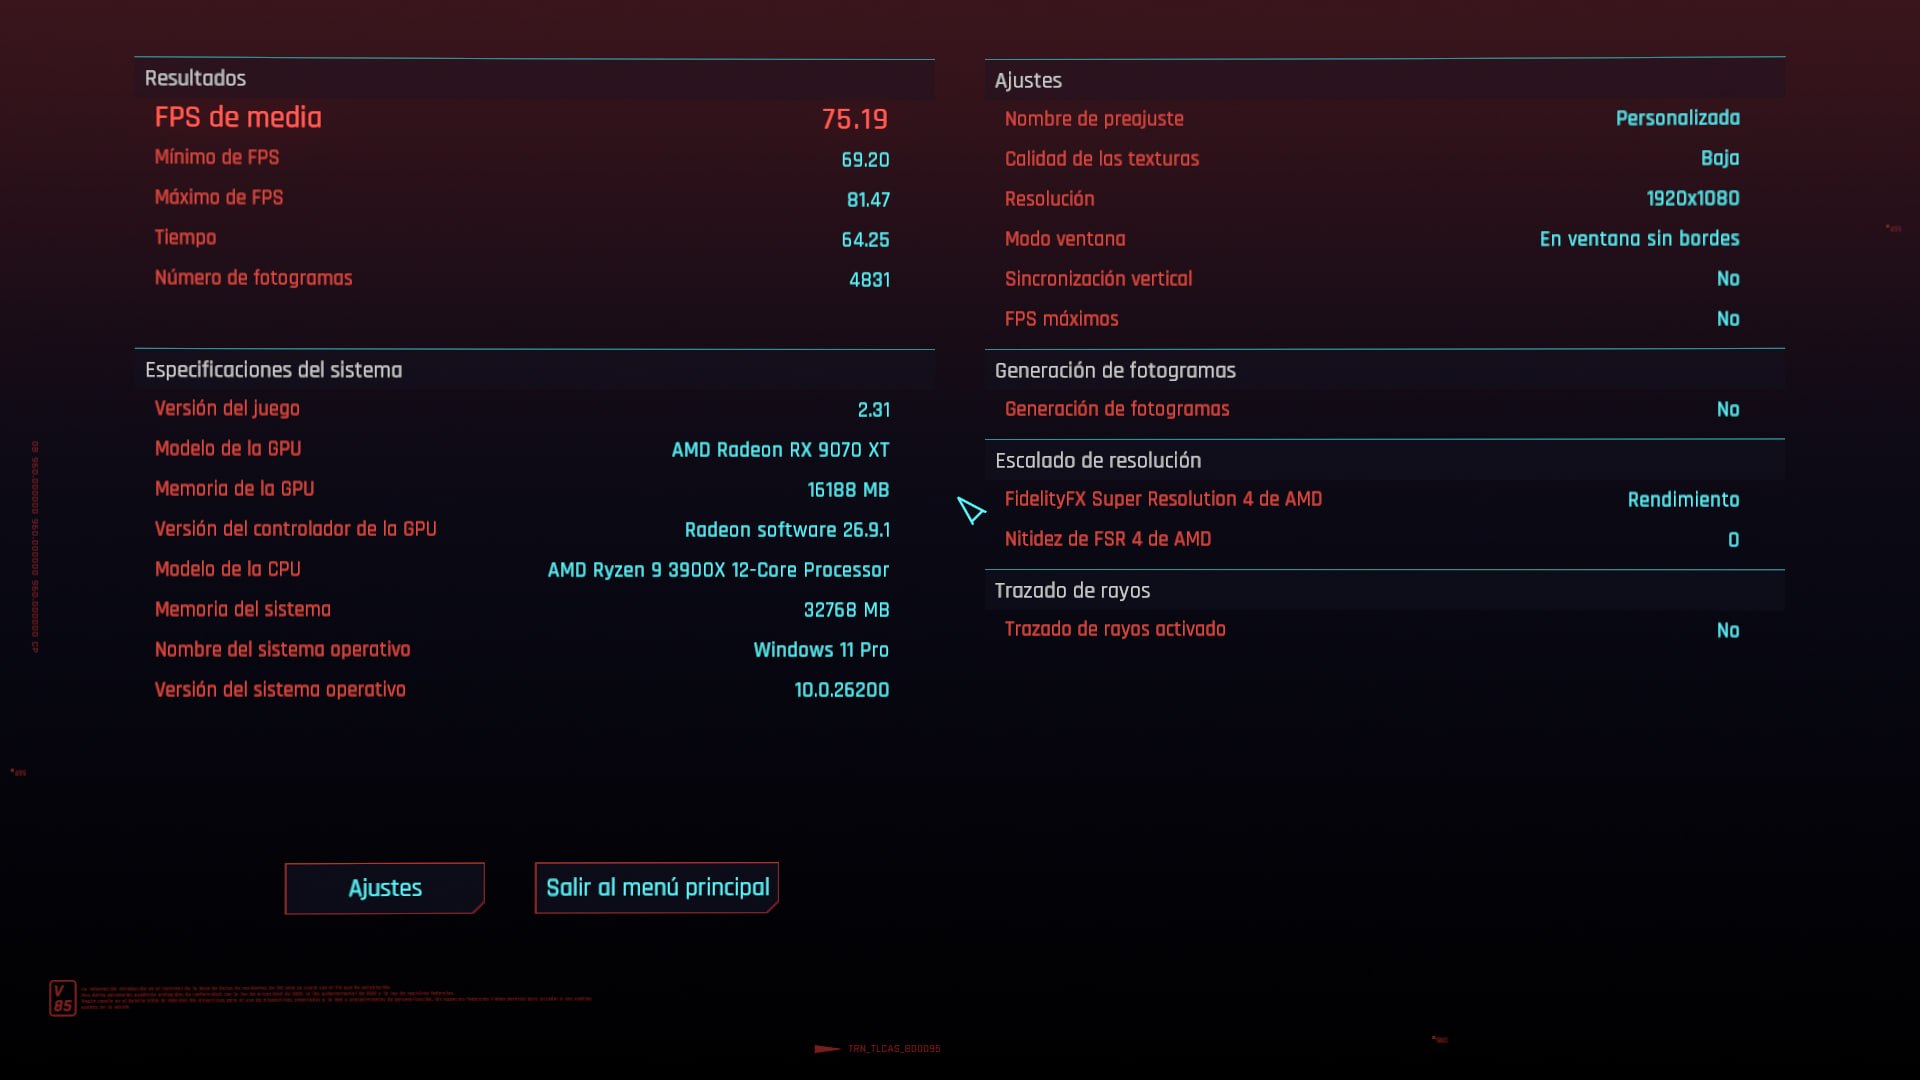
Моддер увеличил производительность Neural Rendering на картах Radeon

P@prohitecавтор про «tech»
4 нед
Моддер увеличил производительность Neural Rendering на картах Radeon

Как ассемблерный код ускорил Quake

Р@progamedevгеймдев
4 нед
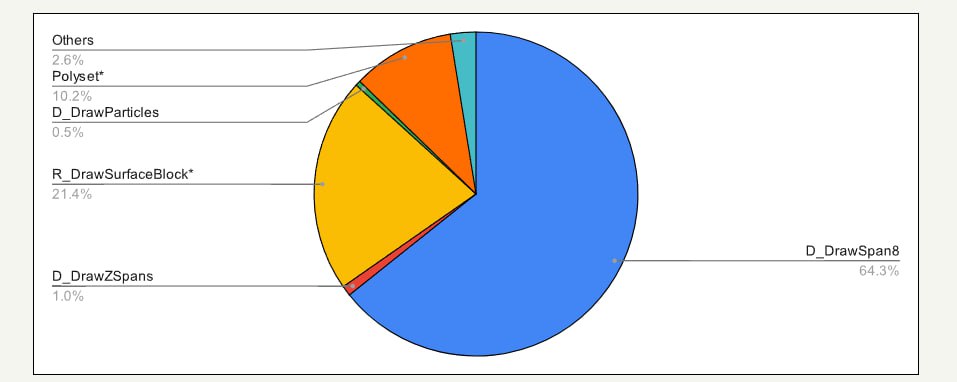
Как ассемблер Абраша удвоил фреймрейт Quake Фабьен Санглар разобрал исходники WinQuake и проверил знаменитое утверждение Кармака: без рукописного ассемблера софтверный рендерер теряет почти половину скорости. Оказалось — чистая правда. 🤯 https://fabiensanglard.net/quake_asm_optimizations/index.html
Как ассемблерный код ускорил Quake

Fireworks выпустила Ember-1 — версию Kimi K3, которая «думает» на 40% дешевле

Платформа для запуска AI-моделей Fireworks представила Ember-1 — дообученную версию модели Kimi K3i, которую научили тратить заметно меньше токенов на рассуждения без потери качества ответов. Модель убирает лишние повторы и избыточные цепочки размышлений, оставляя полезную самопроверку, за счёт чего расход токенов падает на 35-50% при сопоставимом или лучшем результате на бенчмарках.

Это важно для компаний, которые платят за токены в agentic и coding-задачах: снижение расхода токенов напрямую сокращает счета за API без смены модели и без потери качества решений.

40%снижение расхода токенов у Ember-1
92.2%результат Ember-1 на SWE-bench Verified
$126экономия на задаче на DeepSWE против K3 max

Полный разбор →

Сжатие игр с помощью Compact GUI

G@GameDEVгеймдев
1 мес
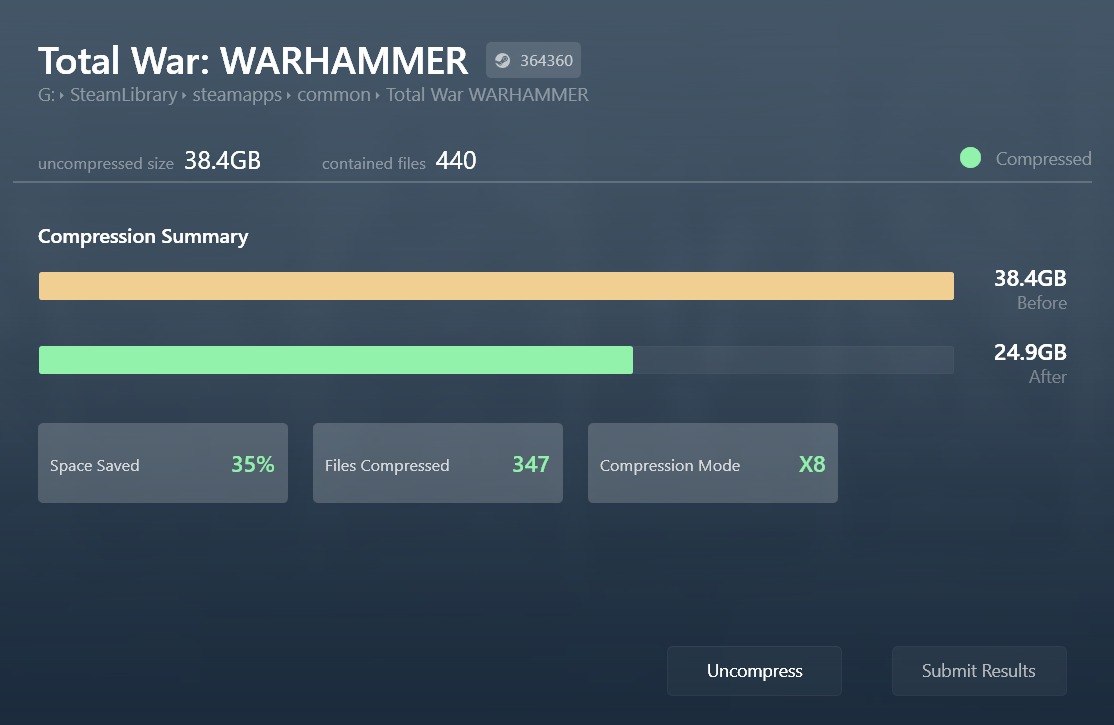
Kind reminder, that you can compress your games on both SSD and HDD via Compact GUI: https://github.com/IridiumIO/CompactGUI/releases/ It uses built-in system compression but do it in the safest way possible (avoiding certain file types, etc.). It can save from 5 to 50% of space, depending on the game. You need to have free RAM and a bit of CPU to make the packed game run well. #FOSS@GameDEV
Сжатие игр с помощью Compact GUI

Veda: оптимизация внимания для видео-диффузии от ByteDance

Н@GreenNeuralRobotsAI-инженер
1 мес

Discord готовит игровой режим для снижения нагрузки на ПК

Discord разрабатывает функцию Game Modei, которая должна снизить нагрузку клиента на процессор и видеокарту во время игры. Приложение будет автоматически определять запуск игры, урезать тяжёлые анимации интерфейса и отключать лишние визуальные эффекты, освобождая системные ресурсы для самой игры.

Функция найдена в экспериментальной сборке и пока проходит тестирование — точная дата релиза не называется. Это часть более широкой оптимизации десктопного клиента Discord.

17%снижение среднего использования CPU после обновления Electron

Полный разбор →

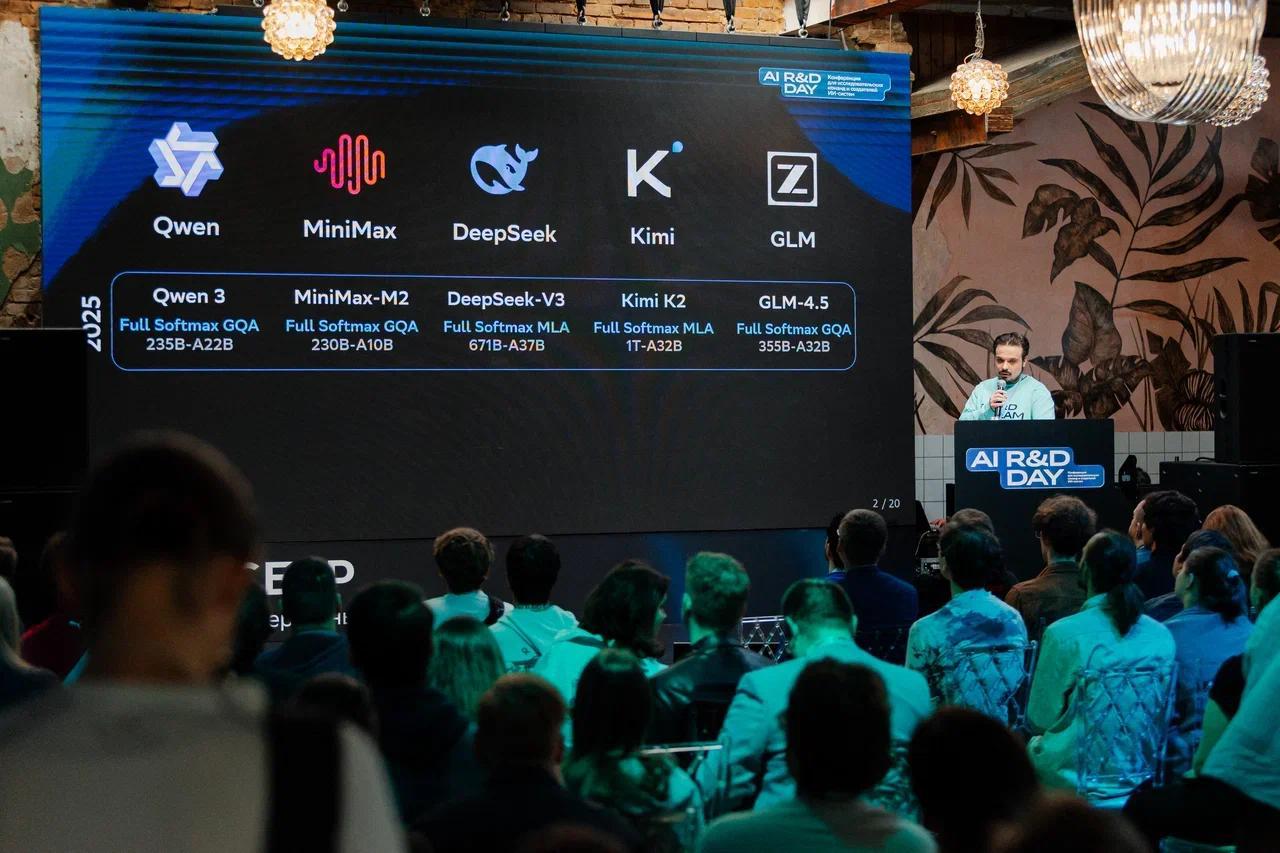
Как ускорить LLM на длинном контексте: методы и результаты экспериментов

С@oulenspiegel_channelAI-инженер
1 мес
Как ускорить LLM на длинном контексте: методы и результаты экспериментов

Cursor сократил расход токенов агента на 7% за счёт переработки харнесса

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Компания Anysphere переработала обвязку (харнессi) агента в Cursor и снизила расход токенов пользователей на 7% без потери качества ответов. Экономия достигнута за счёт более строгих и коротких промптов, выборочной подгрузки инструментов, улучшенного кэширования и сжатого формата чтения файлов.

Инженер Cursor поделился промптом, который позволяет разработчикам собственных агентных харнессов применить те же методы и сделать свою обвязку дешевле — компания также опубликовала статью с разбором механики оптимизации.

7%снижение расхода токенов
75%сокращение системного промпта
46,9%падение токенов в сессиях с MCP

Полный разбор →

NVIDIA патентует ИИ-ассистента для оптимизации игр

P@prohitecавтор про «tech»
1 мес
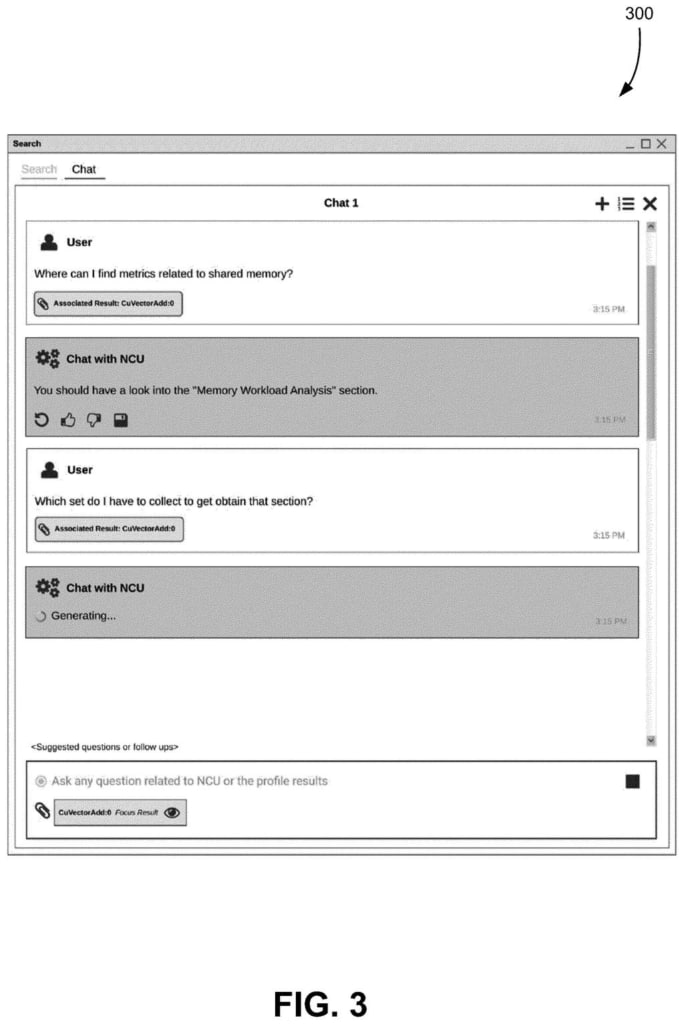
NVIDIA патентует ИИ-ассистента для поиска багов и оптимизации игр NVIDIA подала патентную заявку на нейросетевого помощника, который помогает оптимизировать игры под видеокарты компании. Разработчики смогут задавать вопросы о причинах медленной работы программы. В ответ ассистент изучит отчеты о производительности и создаст скрипты для поиска проблемных участков кода. Вносить изменения в код самостоятельно нейросеть не будет. Ее задача — находить узкие места и подсказывать, где именно ресурсы графического процессора расходуются впустую.
NVIDIA патентует ИИ-ассистента для оптимизации игр

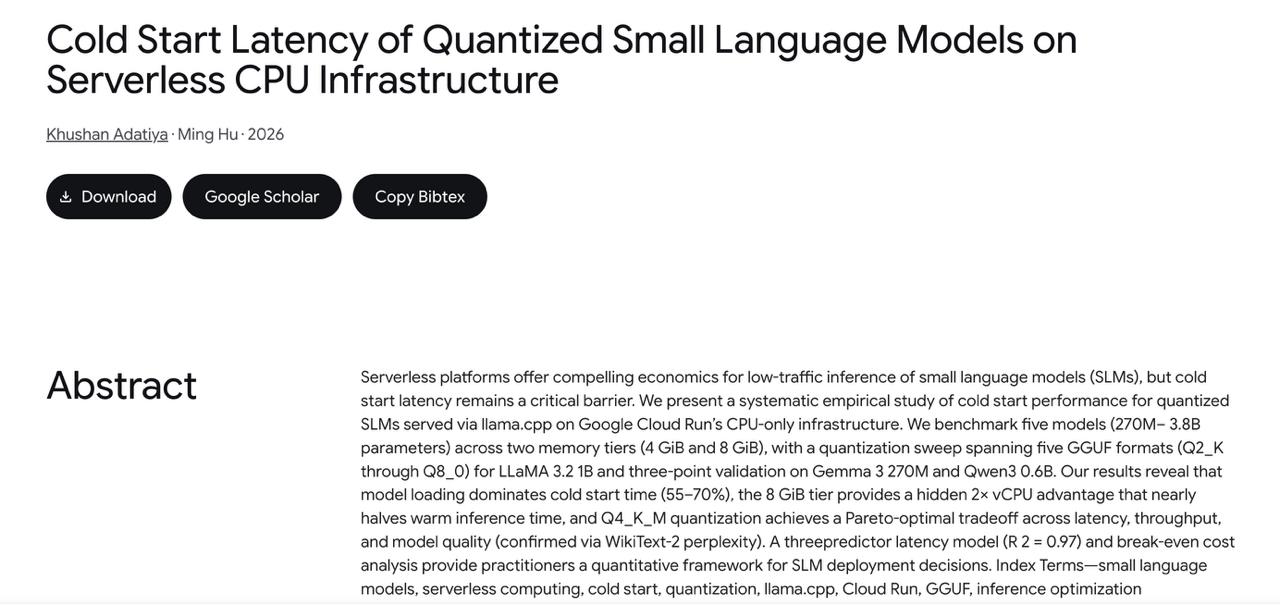
Проблемы холодного старта малых LLM в Cloud Run

1 мес
Проблемы холодного старта малых LLM в Cloud Run

Откуда берется сложность в разработке игр

Х@habr_comмедиа / агрегатор
1 мес
Откуда берётся сложность? 16 мс на кадр. 5,5 ГБ памяти. Ограничение на размер патча. Десять секунд до первого интерактивного кадра. Пока таких чисел нет, можно мечтать о кристально чистой архитектуре. Потом простой алгоритм перестаёт укладываться в бюджет, кеш экономит время ценой памяти, а оптимизация в одном месте начинает мешать требованиям в другом. Один компромисс накладывается на следующий и устройство проекта постепенно меняется вместе с ними. Поговорим, на примерах из разработки игр, о том, откуда в коде берётся сложность, которая когда-то была вполне конкретной платой за ограничения.
Откуда берется сложность в разработке игр

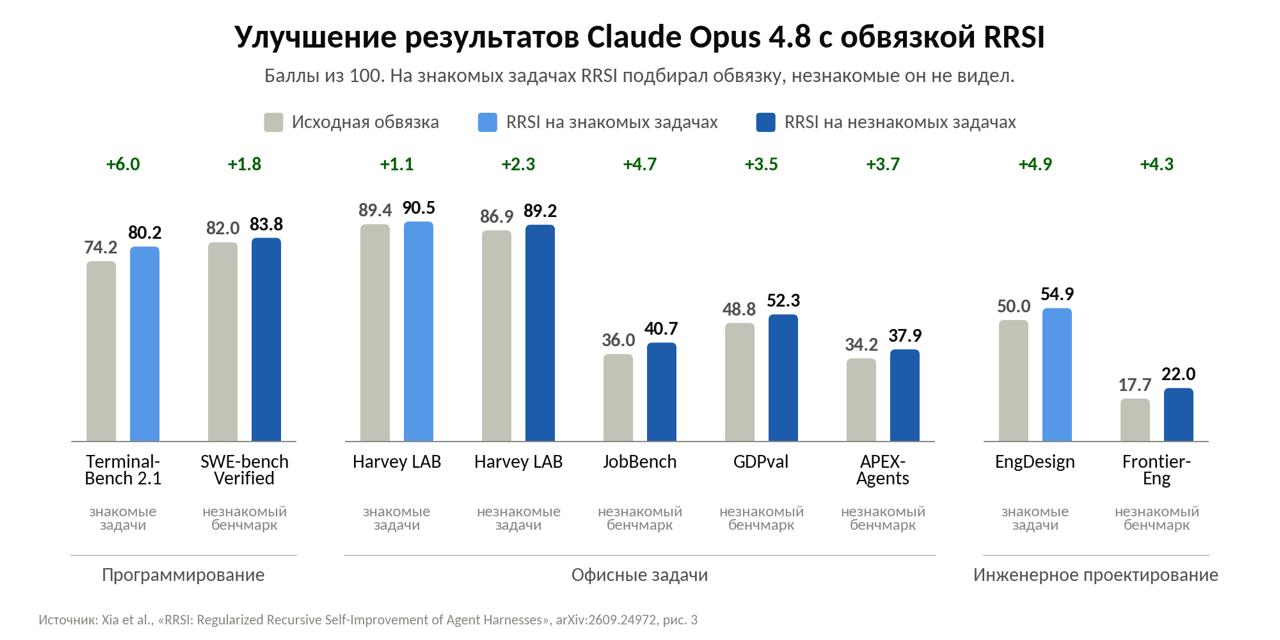
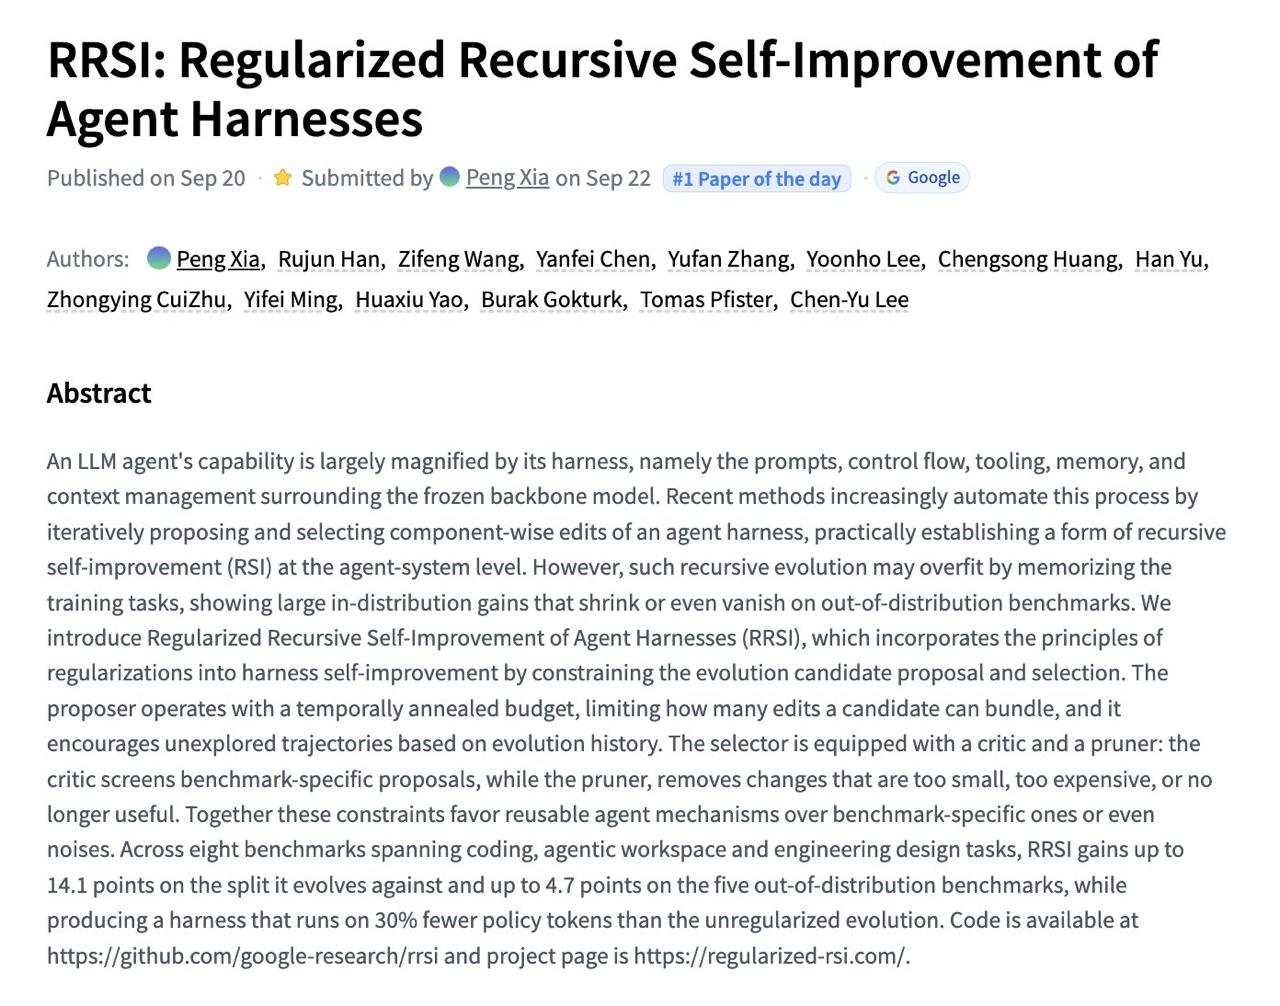
Google представила метод RRSI для автоматического улучшения ИИ-агентов

N@neurohiveAI-инженер
1 мес
Google представила метод RRSI для автоматического улучшения ИИ-агентов

vLLM добавил поддержку режима DJeV для DiffusionGemma

D@data_secretsAI-инженер
1 мес
- Мам, давай купим Jev по API - Нет, у нас есть Jev дома Jev дома: Мэтт Мастраччи, контрибьютор vLLM, взял DiffusionGemma 26B от Google и заставил ее работать по той же схеме, причем без дообучения модели. Вместо генерации текста задается шаблон ответа, а после одного шага denoising из логитов сразу достаются ответы и их вероятности. Поддерживаются yes/no, multiple-choice и scoring вопросы. Теперь этот режим добавили в vLLM. По первым тестам качество близко к оригинальному Jev, а в NVFP4 модель можно поднять на одной GPU с 24 ГБ памяти. https://github.com/taeold/djev-run

RRSI: метод автоматической оптимизации систем ИИ-агентов

1 мес
⚡️ Агенты научились улучшать собственную обвязку RRSI оптимизирует не веса модели, а всю систему вокруг неё: промпты, инструменты, память, управление контекстом и логику выполнения задач. Обычное самоулучшение быстро подгоняется под тесты. RRSI ограничивает число изменений, отсекает хаки под конкретный бенчмарк и удаляет дорогие или бесполезные компоненты. Результат на 8 бенчмарках: • до +14,1 пункта на обучающих задачах • до +4,7 пункта на новых задачах • на 30% меньше токенов Практический RSI без переобучения самой модели. https://huggingface.co/papers/2609.24972 https://github.com/google-research/rrsi
RRSI: метод автоматической оптимизации систем ИИ-агентов

Релиз Unreal Agent: open source решение для оптимизации AI-агентов

G@gopracticeAI-инженер
1 мес

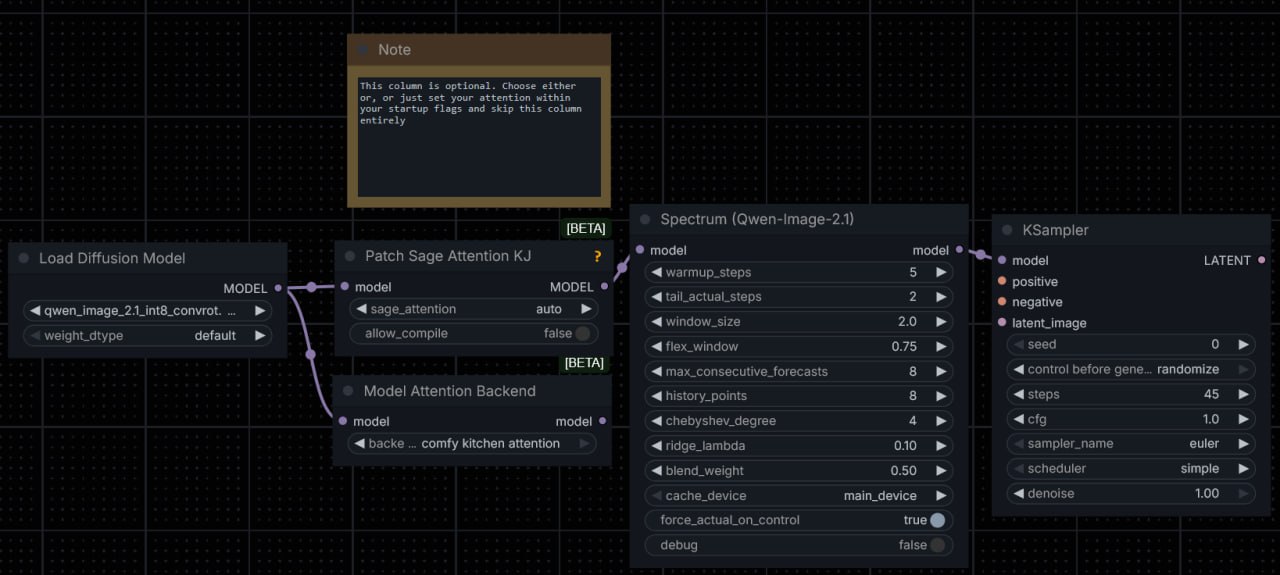
Релиз оптимизации Spectrum для Qwen Image 2.1

Н@GreenNeuralRobotsAI-инженер
1 мес
Qwen Image 2.1 Latent Upscale Латентный апсекейл #QI21 Ну я параметры сильно не крутил, что вышло то вышло workflow ——— Comfyui-Spectrum-Qwen2.1 Ускорение Spectrum для #QI21 (навйбкодено) #optimization #upscale MAX
Релиз оптимизации Spectrum для Qwen Image 2.1

Research Preference Model: как научить AI-агента выбирать эксперименты, не тратя часы GPU на пустые попытки

Исследователи представили статью «AI Research Preference Models» — метод, который позволяет AI-агенту заранее отбирать самые перспективные варианты эксперимента, не запуская каждый из них полностью. Проблема в том, что агент может сгенерировать множество идей за секунды, но проверка каждой требует часов обучения модели на GPU, поэтому нужен способ отсеивать бесперспективные варианты до полного запуска.

Авторы предлагают Research Preference Model (RPM)i — модель, которая попарно сравнивает предложенные решения и выбирает наиболее перспективное, опираясь не на «вкус» и интуицию (как в предыдущих подходах, которые не сработали), а на верифицируемый сигнал.

ВыводРассмотрены два варианта RPM: Inference-only RPM оценивает планы, код и результаты прошлых экспериментов только рассуждениями LLM, без запуска кода

0,729балл AIRA-dojo с Agentic RPM
0,684базовый балл AIRA-dojo без RPM
0,748теоретически достижимый максимум балла

Полный разбор →

AMD представила Tetrahedral Cages — технологию, снижающую расход видеопамяти при трассировке лучей в 47 раз

AMD показала исследовательскую технологию Tetrahedral Cagesi для трассировки лучей в сложных анимированных сценах — траве, листве, шерсти и толпах персонажей. Вместо пересчёта иерархических объёмов (BVHi) для каждого движущегося полигона алгоритм помещает геометрию в деформируемую «тетраэдрическую клетку»: анимируется только сама клетка, а исходная геометрия и её BVH-структура остаются статичными.

В демонстрации на видеокарте Radeon RX 9070 XT расход видеопамяти под структуры ускорения упал с 80 ГБ до 1,7 ГБ (в 47 раз), а время обновления кадра сократилось с 300 мс до 3,3 мс (рост скорости геометрии в 90 раз). Это может снять давнюю проблему острого дефицита VRAM при рендеринге плотной анимированной геометрии в играх.

ВыводТехнологию представил инженер AMD Хольгер Грюн (Holger Gruen)

47 разснижение расхода VRAM
80 ГБ → 1,7 ГБпамять под BVH-структуры
300 мс → 3,3 мсвремя обновления кадра

Полный разбор →

DeepSeek-V4.1-Flash: оптимизация LLM для агентных задач

D@datastorieslanguagesAI-инженер
1 мес
Ещё ↓