Проблемы холодного старта малых LLM в Cloud Run
M@machinelearning_interviewAI-инженер
1 месGoogle проанализировала задержки при запуске квантованных LLM на CPU в Cloud Run: до 70% времени уходит на загрузку весов.
Разработчики серверных приложений для ИИ теперь знают, где искать скрытые задержки при запуске моделей.
- Загрузка весов модели в память занимает больше времени, чем сама генерация ответа для малых LLM.
- Увеличение объема памяти в Cloud Run автоматически дает больше vCPU, что ускоряет инференс.
- Для оптимизации серверных ИИ-решений нужно учитывать не только скорость генерации, но и время холодного старта.
🎉 Маленькая LLM может тратить больше времени на загрузку, чем на ответ.
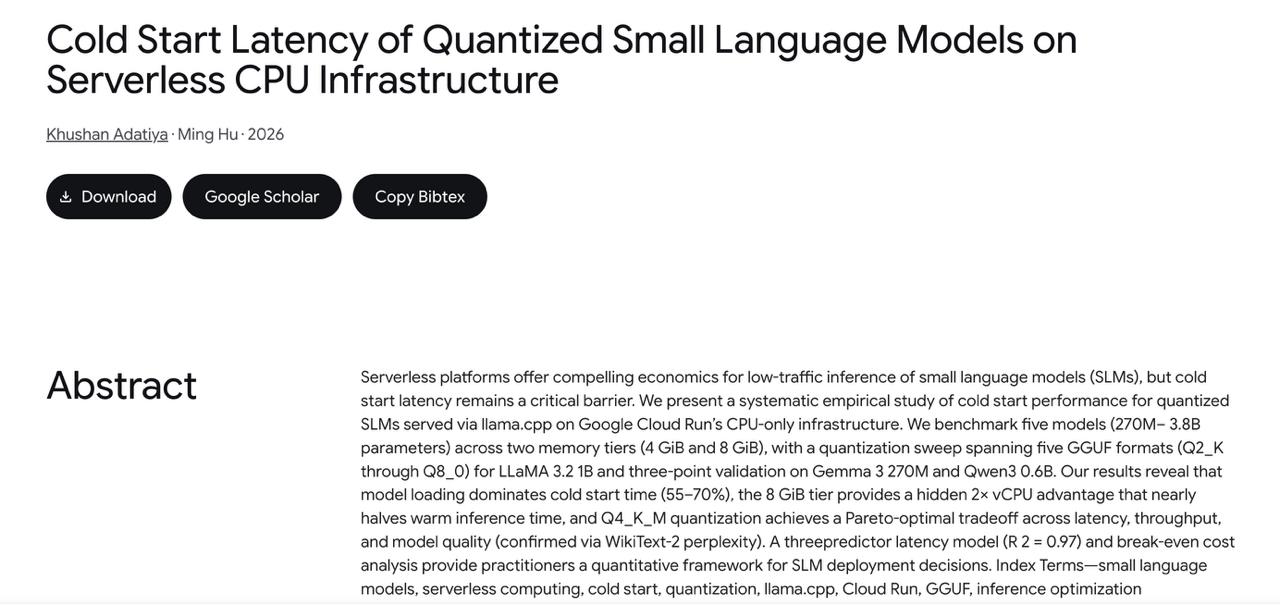
Google изучила запуск квантованных моделей от 270 млн до 3,8 млрд параметров на Cloud Run с CPU. При «холодном старте» 55–70% задержки приходилось на загрузку модели: прежде чем генерировать токены, нужно перенести её веса в память.
Нашёлся и менее очевидный эффект Cloud Run: переход с 4 на 8 ГиБ памяти в тестируемой конфигурации давал вдвое больше vCPU и почти вдвое сокращал время инференса после загрузки модели.
Практический вывод для редких запросов к небольшой LLM: оптимизировать стоит весь путь до ответа — загрузку весов, конфигурацию инстанса и только потом генерацию.
https://research.google/pubs/cold-start-latency-of-quantized-small-language-models-on-serverless-cpu-infrastructure/
Кратко (AI)
Исследование Google показало, что при запуске небольших квантованных LLM на серверной инфраструктуре Cloud Run основная часть задержки (до 70%) приходится на загрузку весов модели в память. Также выявлено, что увеличение объема оперативной памяти в конфигурации инстанса значительно ускоряет процесс инференса за счет предоставления дополнительных vCPU.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖