🤩 Ставим своим любителям голосовух
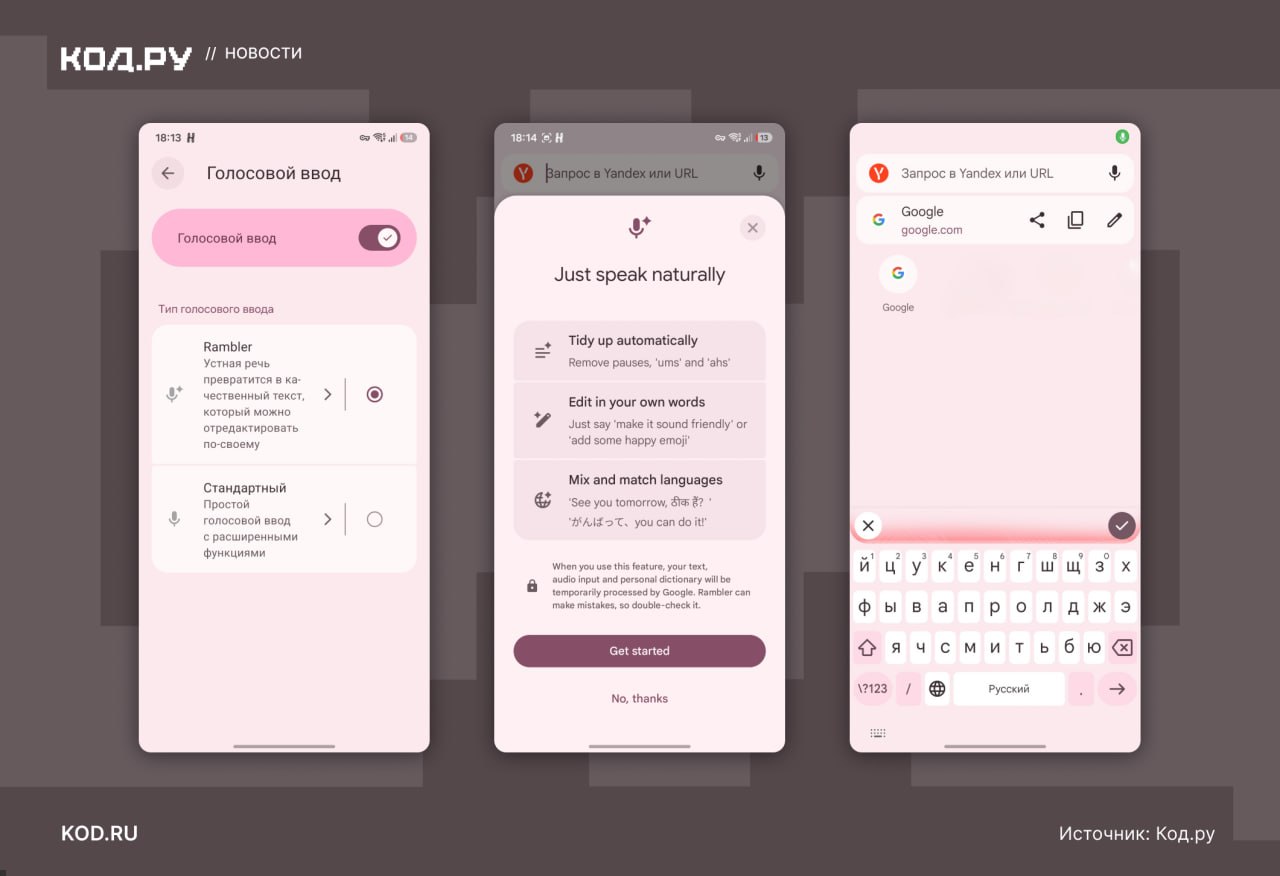
Энтузиаст выпустил PixelBoard — модифицированную Gboard с разблокированной ИИ-диктовкой Rambler.
Она убирает «эээ» и запинки, сама ставит знаки препинания и понимает, когда человек передумал посреди фразы.
Как и где ставить:
↖️ https://kod.ru/pixelboard-rambler-gboard-android
Калифорнийский стартап Odyssey, основанный выходцами из индустрии беспилотных автомобилей, представил Odyssey-3 — модель, которая по текстовому запросу или картинке создаёт интерактивное 3D-окружение и просчитывает движение и взаимодействие объектов в реальном времени. Внутри сгенерированного мира можно перемещаться от первого или третьего лица, управлять камерой и на ходу добавлять события, на которые сцена реагирует.
Odyssey позиционирует продукт не только как развлечение, но и как симулятор для обучения роботов, беспилотных автомобилей и других физических систем — поверх модели обучают отдельные декодеры действий и политики управления. Попробовать модель можно бесплатно на сайте компании, тогда как ранее похожую функциональность (модель Geniei от Google) приходилось оплачивать — по словам источников, порядка $240.
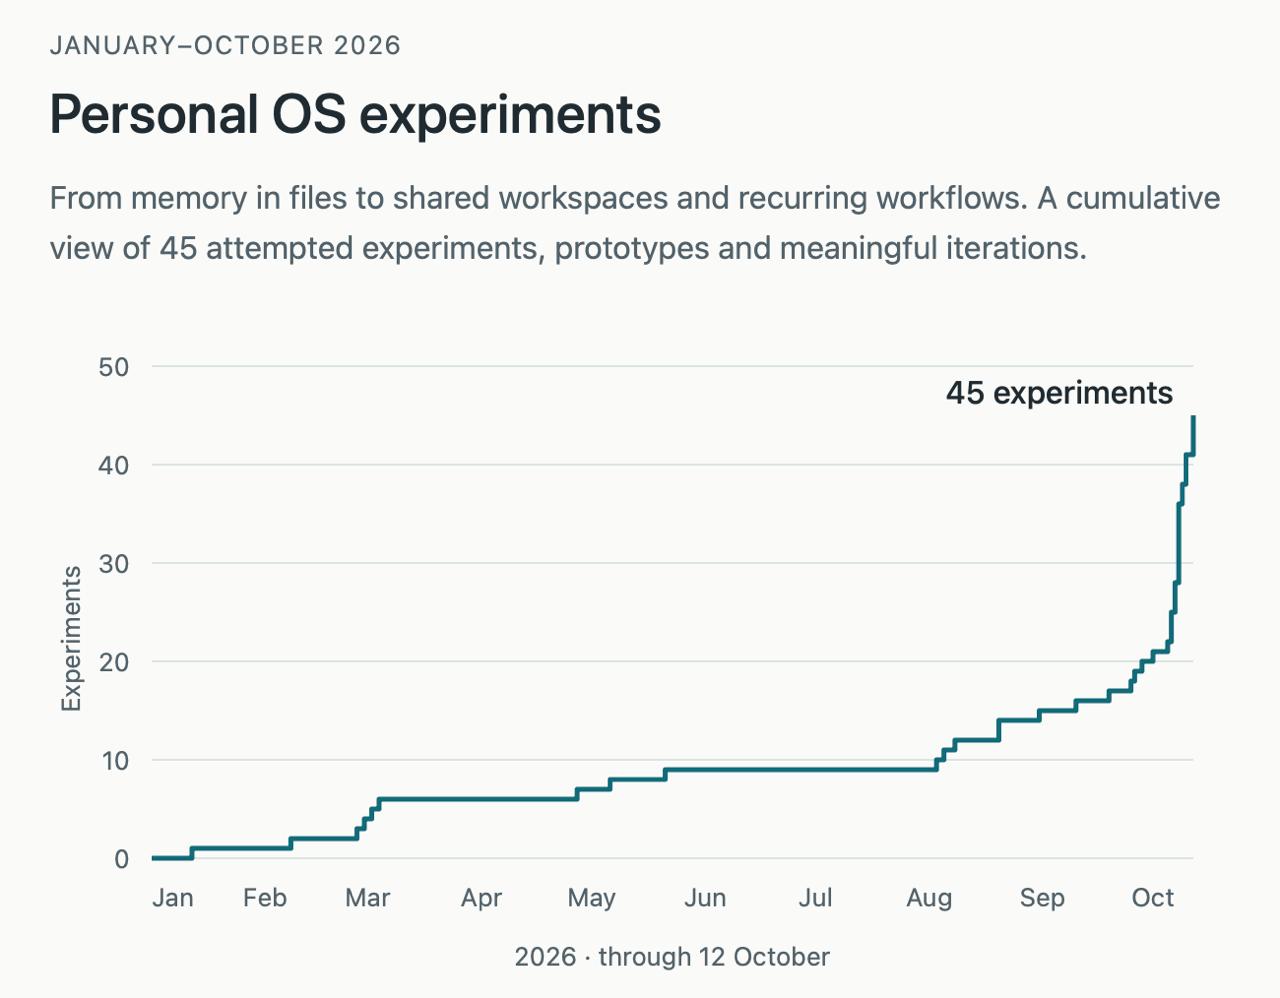
График моих экспериментов вокруг Personal OS с самого началаСписок экспериментов есть тут.
Началось все после декабря 2025 года, когда модели дозрели до того, чтобы кодексу можно было поручать достаточно долгие AI Coding задачи.
Никто не замечает никакого тренда?
Ваш, @llm_under_hood 🤗
Составляю сейчас план лекции, которую очень давно хотел сделать: про то как математика проложила нам путь к искусственному интеллекту, который мы знаем сейчас, какие рубежи мы начали преодолевать только что, и чего ожидать дальше. В процессе выясняется много интересного, поэтому запилю несколько опросов по теме :)
Два независимых автора протестировали способность Claude Opus генерировать полноценные motion-graphics видео без использования платных видеогенераторов — вся графика, музыка и звуковые эффекты создаются кодом, который модель пишет сама и затем рендерит на видеокарте.
В первом случае Максим Артюшенков потратил всего 5 минут своего участия, а Claude Opus 5.5i — около часа, чтобы собрать клип под музыку в стиле electronic hip-hop: модель описала сцены математикой, а GPU посчитал их пиксель за пикселем в такт словам и битам трека. Во втором случае Артемий Редков дал Claude один короткий промпт без предварительных данных, и модель самостоятельно изучила проект, написала сценарий, синтезировала музыку и около 30 звуковых эффектов и отрендерила видео с русской озвучкой и субтитрами.
5 минучастие человека в создании клипа
1 часвремя работы Claude Opus 5.5 над роликом
30 звуковых эффектовсинтезированы кодом без сэмплов
Два блогера независимо обратили внимание на один и тот же парадокс: люди, которые отключают рекламные трекерыi в приложениях, боятся «прослушки» Instagram и отказываются от cookie-файлов, без колебаний передают чувствительные данные языковым моделям вроде ChatGPT и Claude.
Авторы считают, что реальная угроза конфиденциальности сейчас не в таргетированной рекламе, а в том, что пользователи сами массово загружают в LLMi конфиденциальную информацию о себе и своих компаниях.
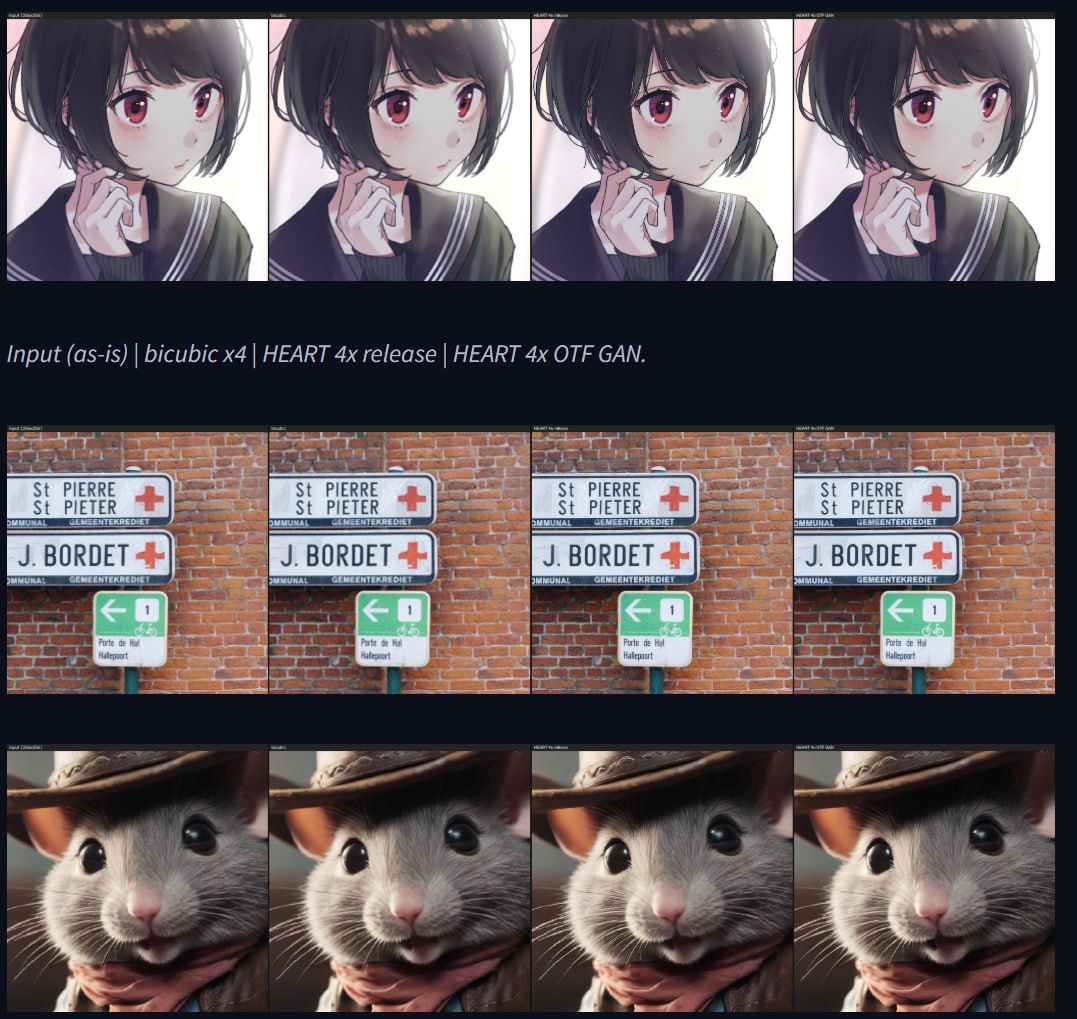
HEART
супер-резолюшн от Philip Hofmann (часть набора BODY)
Нейросеть для апскейла изображений. Простая в обучении и быстрая, спроектирована для реального использования, а не погони за бенчмарками. Натренирована на обычной RTX 3060 12 ГБ.
• Апскейл 2x и 4x
• OTF-модели восстанавливают реальные фото (шум, сжатие), а не только чистые даунскейлы
• Экспорт в динамический ONNX с первого раза, готово для TensorRT
• Работает в chaiNNer
• ~16.7M параметров, один файл
Проверил на свидетеле - ... ну да пикселей больше. а где супер-резолюшн?
huggingface.co/Phips/HEARTgithub.com/Phhofm/heart-trainДемо
#upscale
MAX
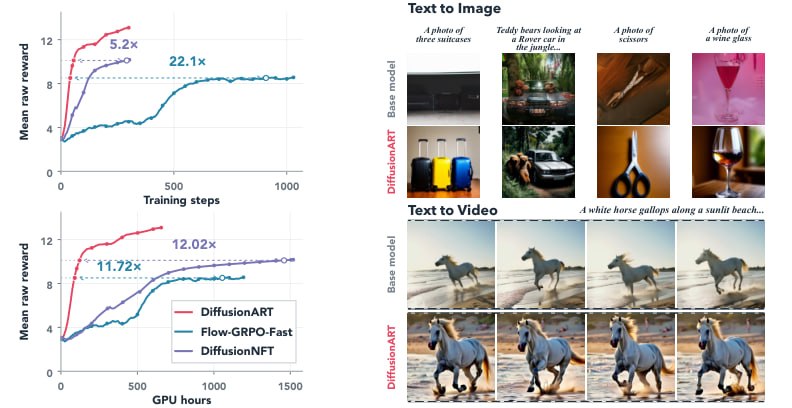
DiffusionART
Алгоритм дообучения диффузионных моделей от Kling AI. Обучает модели генерации видео и изображений сильно дешевле - в 12 раз меньше GPU-часов при более высоком вознаграждении.
• RL-дообучение видео- и image-моделей: качество, следование промпту, feedback
• Стабильное обучение без крахов, без настройки EMA-расписания
• Работает на #HunyuanVideo-13B, #Wan21-I2V-14B, #SD35-M
Соль — порядок операций: сначала агрегировать вознаграждения и endpoints, потом регрессия, переиспользуя замороженную цель. Убирает скрытую силу согласованности из классического NFT, из-за которой обучение нестабильно
ГитхабHF
#finetuning
MAX
Исполнитель роли Коэна из The Blood of Dawnwalker считает, что работающие с ИИ-озвучкой специалисты будут обходиться компаниям дороже самих актёров.
При этом он считает свой голос «наименее интересной частью работы».
https://dtf.ru/games/5349673