Twitch добавил опцию отказа от обучения ИИ на контенте стримеров
M@ai_machinelearning_big_dataAI-инженер
2 мес
Команда MERA обновила свой главный текстовый бенчмарк для русского языка. Причина — старые тесты перестали различать современные SOTA-моделиi, так как модели за последние годы заметно выросли в качестве. MERA Text 2.0i становится основной версией публичного бенчмарка, а предыдущая версия заморожена, хотя запуски по ней остаются поддерживаемыми.
Новая версия построена вокруг навыков, которые до сих пор сложно оценивать: юмор и персонажность, культурный контекст, работа со сложными инструкциями и логическое рассуждение. Оценка идёт по фиксированному протоколу и измеряет возможности самой модели, без дополнительных reasoning- и agentici-обвязок.
Anthropic опубликовала статью, из которой следует, что накопленные за последний год приёмы написания промптов для новых моделей скорее вредят, чем помогают. Жёсткие запреты и обязательные правила («никогда не делай так», «всегда делай эдак»), примеры использования инструментов и дублирование инструкций в нескольких местах — всё это было нужно, когда модели были глупее, а теперь только мешает.
Причина в том, что новые модели достаточно умны, чтобы понимать намерение по контексту, без обвешивания жёсткими рамками. Вывод для практиков: нужно ревизовать промпты в своих системах и проектах, убирая устаревшие правила, а не дописывать новые — иначе модель тратит силы на распутывание противоречивых инструкций вместо решения задачи.
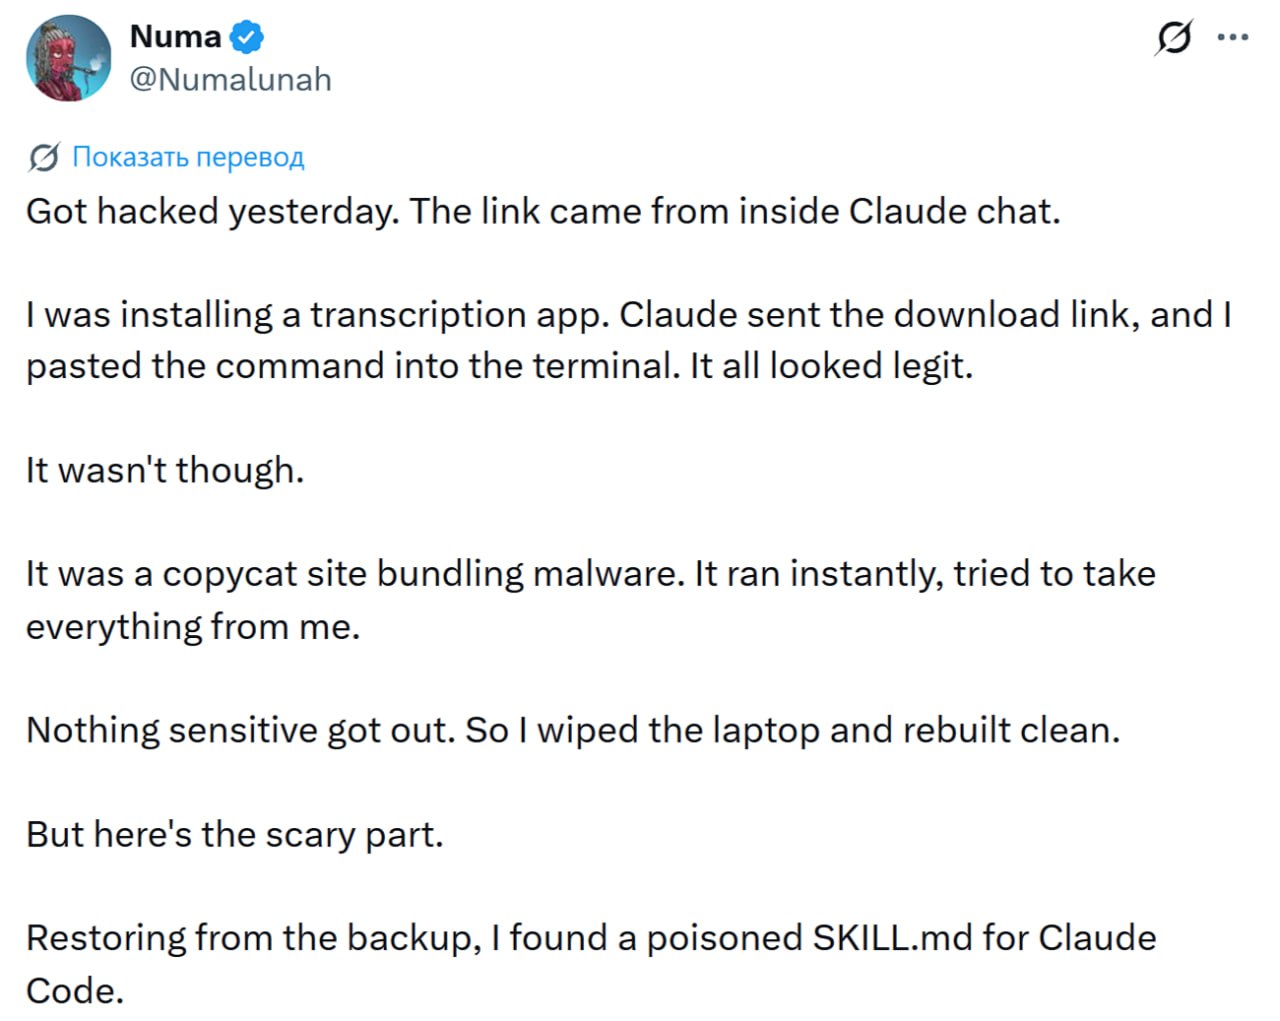
Программист Себастьян Гийемо попросил Claude написать скрипт, который изолирует ИИ-агентов и автоматически чистит за ними временные файлы в /tmpi — он заметил, что агенты оставляют много мусора. Для проверки безопасности скрипта Claude решил провести предварительный тест, но система безопасности Anthropic посчитала операцию потенциально опасной и переключила модель на более старую версию (Opus 4.8i) — по данным vc.ru, изначально использовался интерфейс Fable 5.
Переключённая модель верно рассчитала ограничения доступа, но допустила банальную ошибку в коде: назвала одинаковой переменной и безопасный путь, и папку, предназначенную для удаления. В результате скрипт начал стирать домашний каталог разработчика и успел удалить около 700 ГБ данных до того, как процесс остановили вручную.
Провайдер моделей fal.ai выпустил MiniMax H3 Max — пост-трейн версию открытой модели MiniMax H3, дообученную и оптимизированную под собственный inference-стек fal. Модель генерирует 5-секундное видео в 720p/768p за 2-3 секунды, что быстрее реального времени, и заняла первое место в рейтинге Artificial Analysis среди image-to-video моделей с аудио, обойдя Seedance 2.0, оригинальный H3 и Gemini Omni Flash (старую версию).
fal утверждает, что ускорение (по разным замерам от 35x до 50x относительно официального эндпоинта H3) достигнуто не за счёт кэширования, агрессивной квантизации или sparse attention, а благодаря совместной оптимизации самой модели и inference-движка — при этом сохраняются нативное аудио и нативное разрешение. Компания уже подтвердила, что откроет веса H3 Max, а на вопрос про Ref2V-версию ответила «yes, working on it», что может стать заметным событием для open-source видеогенерации.