Вышел бенчмарк MERA Text 2.0 для оценки LLM
M@mashkka_dsAI-инженер
1 месОбновление бенчмарка MERA для русского языка: 12 новых приватных тестов для оценки SOTA-моделей по логике, культуре и агентным навыкам.
Это новый стандарт для проверки того, насколько хорошо нейросети понимают русский язык и культурные нюансы.
- Позволяет точнее сравнивать современные модели, которые переросли старые тесты.
- Фокусируется на сложных навыках: логике, метафорах и следовании инструкциям.
- Исключает влияние внешних инструментов, оценивая «чистые» способности модели.
📐 MERA Text 2.0 — обновили наш главный бенчмарк для русского языка
За последние несколько лет модели стали заметно сильнее, и часть привычных текстовых бенчмарков уже перестаёт хорошо различать SOTA-модели. Поэтому мы обновили текстовую версию бенчмарка MERA вокруг навыков, которые всё ещё остаются сложными и содержательными для оценки.
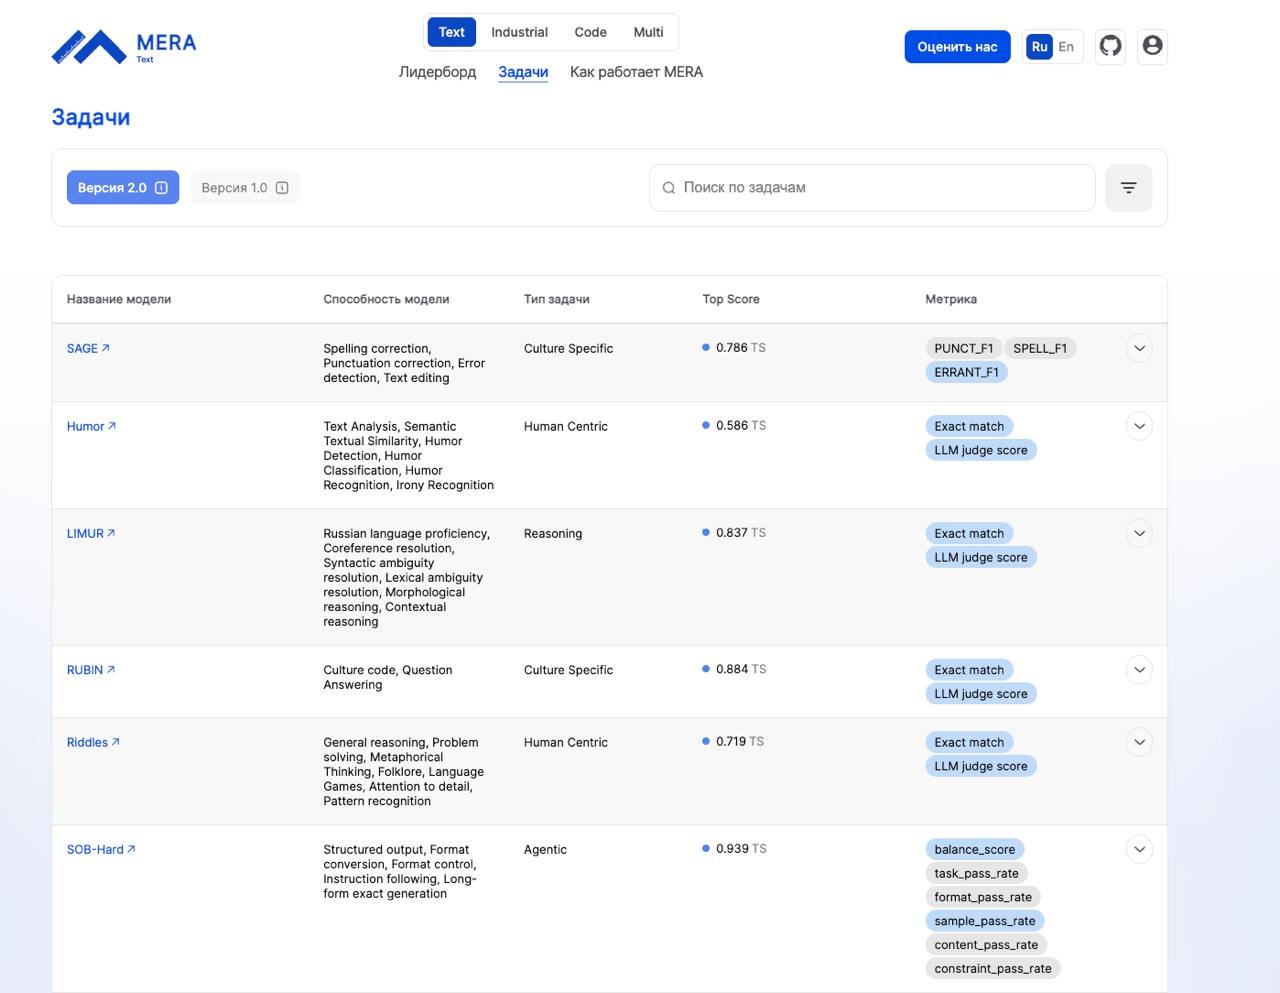
В MERA Text 2.0 собрали 12 новых приватных тестов по четырем группам:
— 🧑 Human-Centric — юмор, метафоры, персонажность;
— 🇷🇺 Culture-Specific — русский язык и культурный контекст;
— 🛠 Agentic — сложные инструкции, структурированные ответы и использование инструментов;
— 🧠 Reasoning — неоднозначность, логика и языковое рассуждение.
Все тесты приватные, а полный прогон занимает существенно меньше времени. Оценка идет по фиксированному протоколу и измеряет прежде всего возможности самой модели — без дополнительных reasoning- и agentic-обвязок.
Предыдущую версию бенчмарка мы заморозили, но оставили запуски поддерживаемыми. MERA Text 2.0 становится основной версией публичного бенчмарка.
Ждем ваши сабмиты на MERA Text 2.0.🔥
🌐 Сайт проекта
👩💻 Код запуска
🖥 Датасеты
📝 Хабр
#mera #ai #ml
Кратко (AI)
Команда MERA представила обновленную версию бенчмарка MERA Text 2.0 для оценки языковых моделей. В него вошли 12 новых приватных тестов, сфокусированных на логике, культурном контексте, агентных навыках и человекоцентричных задачах.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖