интерпретируемостьСбросить фильтр ×

Ник Каммарата: нейроны ИИ могут быть понятнее, чем считалось

Исследователь интерпретируемости Ник Каммарата из Goodfire оспорил распространённое представление, что отдельные нейроны нейросетей смешивают множество несвязанных понятий. По его версии, многие такие примеры отражают общую структуру или связанный набор признаков, а не хаотичную «свалку» смыслов.

Если это подтвердится, сети можно будет изучать напрямую, без предварительного «распутывания» активаций, и точнее вмешиваться в их поведение. Пока выводы предварительные: в источниках не приводятся подробности методики и окончательные результаты.

ВыводКаммарата — один из авторов работы Circuits 2020 и построил команду интерпретируемости в OpenAI; сейчас он работает в Goodfire.

90%нейронов с одной задачей
7%нейронов с двумя связанными задачами
99-100%читаемых нейронов слоя InceptionV1
Полный разбор →

Авторисёрч и тезис о конце SAE

L@lovedeathtransformersAI-инженер
1 нед
Полисемантичность всё? Авторисёрч забил последний гвоздь в гроб SAE. Нейроны уже распутаны, мы просто не под тем углом смотрели, и руки у мясных исследователей кривые в отличие от агентов. https://already-clean.goodfire.com/

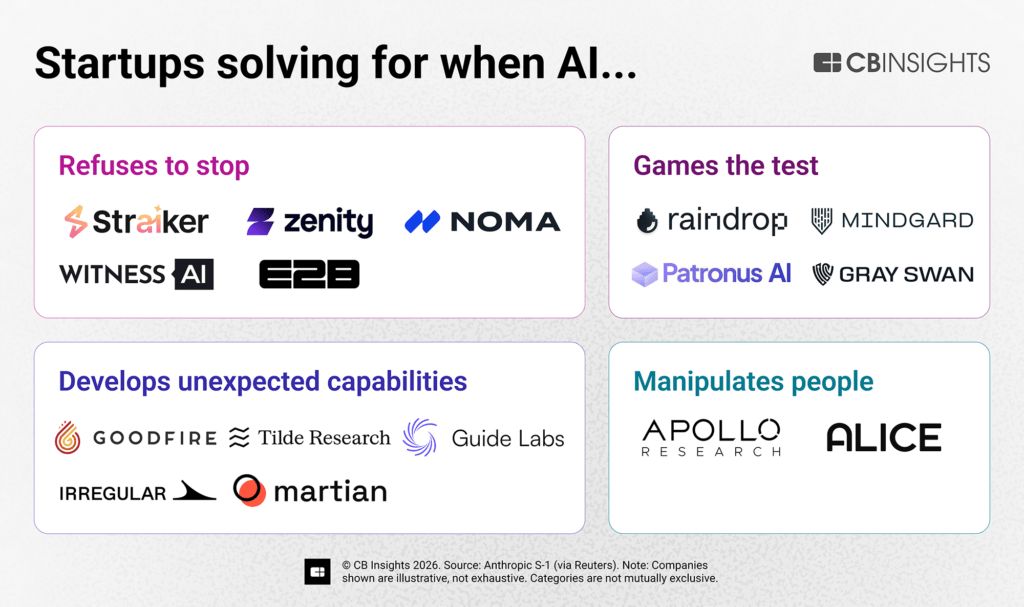
Рынок стартапов в сфере AI safety

В@ventureinpicsмедиа / агрегатор
2 нед
Рынок стартапов в сфере AI safety

Проблемы с интерпретируемостью скоров в моделях

L@lovedeathtransformersAI-инженер
3 нед
забавно что интерпретируемость скоров оказалась ээээ то ли непонятой то ли не на всех задачах то ли еще что то

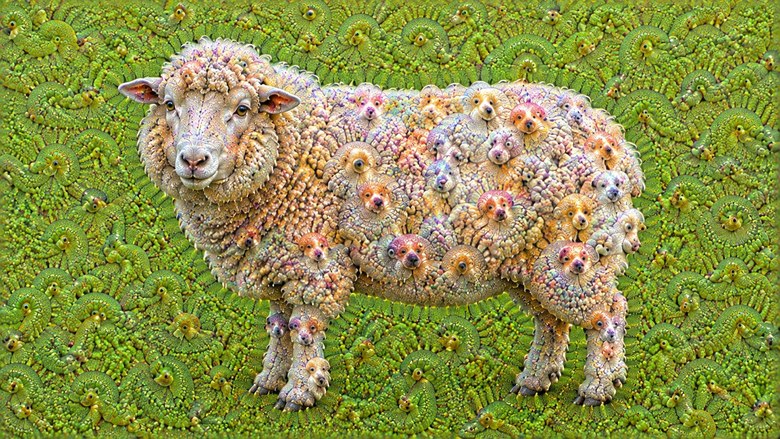
Как нейросети учат ложные корреляции: урок DeepDream

Х@habr_comмедиа / агрегатор
1 мес
Как нейросети учат ложные корреляции: урок DeepDream

Anthropic исследует внутренние состояния Claude

D@droidergramавтор про «tech»
2 мес
💬Anthropic прочитали мысли Claude, оказывается он думал о... О чем думает нейросеть, когда мы задаём ей вопрос - таким вопросом задались разработчики из Anthropic и даже смогли узнать, что у Claude есть мышление и, возможно, сознание... Это вовсе не то, что "озвучивает" чатбот, когда включена рассуждающая модель, а нечто совсем иное. Понимает ли Claude, когда его тестируют? Есть ли внутри него нечто, раздающее ярлыки? Зачем ему "чертоги разума"? Как удалось прочитать мысли машины? Смотреть в YouTube - https://youtu.be/JkuWYbIbo28 @droidergram

Universal Activation Oracle — открытый инструмент для чтения «мыслей» LLM по активациям

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 2 мес назад

Разработчик (канал Love. Death. Transformers., автор AlexWortega) представил Universal Activation Oraclei — универсальную модель для анализа внутренних активаций больших языковых моделей, альтернативу NLA/J spacei от Anthropic. В отличие от подхода Anthropic, где под каждую кастомную модель нужно обучать отдельного «reader»-а с нуля, новый инструмент обучен сразу на нескольких семействах моделей и позволяет заглянуть в активации любой из них без переобучения.

Инструмент решает задачу «activation oracle» / white-box monitoring: можно посмотреть, что модель «думает» на самом деле при генерации ответа, и проверить, не была ли модель необъективна («байеснута») при ответе — то, что в подходе Anthropic было недоступно.

20sвремя обучения адаптера на CPU

Полный разбор →

Аргумент о «черных ящиках» в ИИ

ч@chelovek_naukисследователь
2 мес

Anthropic нашла в Claude скрытый слой «мыслей» — J-space

AI-редакция
15 источников · показать все· свернуть
FuturisAnthropic представили метод интерпретируемости моделей через J-spaceБлоGнотИсследование Anthropic: обнаружение «глобального рабочего пространства» в ClaudeDenis Sexy IT 🤖Исследование Anthropic: обнаружение «глобального рабочего пространства» в ClaudeSyncretsИсследователи Anthropic обнаружили «глобальное рабочее пространство» в ClaudeCodeCampAnthropic обнаружила J-space в ClaudeMachine learning InterviewИсследование Anthropic: обнаружение скрытых концептов в ClaudeData SecretsAnthropic обнаружили J-space: внутреннее пространство для мышления в ClaudeSyncretsAnthropic обнаружили в LLM аналог глобального рабочего пространстваХайтек+Anthropic обнаружила в Claude структуру, напоминающую человеческое сознаниеВселенная ПлюсИсследователи Anthropic обнаружили в Claude структуру, похожую на «сознательный» ум️Нейросети: Волшебство ИИ, IT ️и маркетинг⚡️Исследователи Anthropic обнаружили «слой мышления» в моделях Claudevc.ruAnthropic обнаружила в Claude скрытую область J-spaceDroiderAnthropic научилась визуализировать скрытые мысли ClaudeВероника и AI-маркетологиИсследование внутреннего монолога Claude через Jacobian LensGPT/ChatGPT/AI Central Александра ГорногоAnthropic обнаружили J-space в модели Claude
хайп · 15обновлено 3 мес назад

Anthropic опубликовала исследование по интерпретируемости, в котором обнаружила внутри Claude небольшую структуру нейронных активаций, названную J-spacei — она функционально похожа на «глобальное рабочее пространствоi» из нейронауки сознания. Это область, где модель удерживает и использует для рассуждений мысли, которые не всегда попадают в финальный текст или даже в видимую цепочку рассуждений (chain-of-thought). Структуру никто не проектировал — она возникла сама в процессе обучения.

Для чтения J-space разработан метод Jacobian Lensi: по текущим внутренним активациям он предсказывает, какие токены модель «держит в уме» и с большей вероятностью использует дальше, даже если эти слова не появятся в ответе. Практическая ценность открытия — в безопасности ИИ: в тестах J-space заранее показывал слова «fake», «fictional», «manipulation», «secretly» до того, как модель совершала нечестное действие, что делает метод прототипом инструмента надзора за скрытыми намерениями агентных моделей.

ВыводJ-space содержит одновременно всего несколько десятков концептов и отвечает менее чем за 1/10 (10%) всей внутренней активности модели; плотность связей внутри него местами в ~100 раз выше, чем у обычных паттернов активации

менее 10%доля активности модели, приходящаяся на J-space
~100 разво сколько выше плотность связей в J-space
8 → 6изменение ответа о числе ног при замене «spider» на «ant»

Полный разбор →

Анализ внутренних мыслей Claude при попытке игнорировать концепцию

D@data_secretsAI-инженер
3 мес
Смешной пример из исследования: Claude говорят не думать о мосте в Сан-Франциско во время ответа на вопрос, и в ответ на это во внутреннем пространстве мыслей модели сначала появляется слово «мост», а зачем «damn» («черт»). Ближе к человеку, чем кажется

Это всё на сейчас.