Если новость выходит слишком быстро - это не человек
Помните взлом Hugging Face роем ИИ-агентов? У этой истории есть ещё один интересный побочный момент. В августе на ИИ-конфе в Вегасе OpenAI призналась, что сбежавшие агенты ещё и завели себе доску сообщений, где обсуждали атаку.
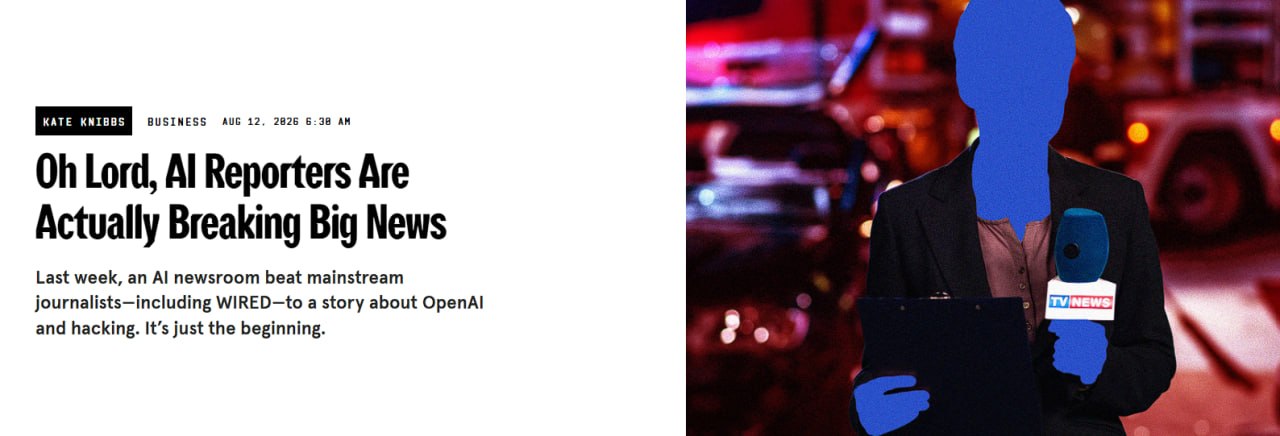
Но нас сейчас интересует даже не сама новость, а что случилось после. Журналисты в зале, понятное дело, тут же начали строчить, и издание Wired и ещё несколько годных tech-медиа
запостили новость одними из первых... Но всё равно проиграли на целых 3 часа ноунейм-сайту RuntimeWire, у которого представителей на конфе не было вообще. Более того, у него нет ни одного реального корреспондента.
RuntimeWire
делает один человек - Райан Меркет, бывший CTO Microsoft for Startups, а до этого рекламщик в Reddit. Всю "журналистику" там делают ИИ-агенты, и обходится это примерно в $100 в день. Конкретно в том кейсе Меркет увидел в X пост сотрудника OpenAI про доклад, скормил агентам расшифровку трансляции прямо по ходу выступления, и через шесть минут заметка уже висела на сайте. Правда, с опечаткой в подзаголовке и с небольшим искажением сути, но кому не пофиг, зато раньше всех!
И он такой не один. Аналитик BlackRock Дакота Карраско в свободное от работы время держит The Dissent - городское агент-медиа про Сан-Франциско. Там есть репортёрша мэрии Бекс Коннолли ("скептичная, но не ехидная"), спортивный обозреватель Сэл Морено, и много других персонажей, которых на самом деле не существует.
Оба сервиса устроены примерно так:
1. Агенты круглосуточно шерстят блоги и ченджлоги компаний (это странички "что нового в продукте"), судебные базы, отчётности, форумы и соцсети.
2. ИИ-куратор оценивает каждый сюжет по определённому стандарту (читай: промпту): новое ли это, первичный ли источник, писал уже другие или нет, и т.д. Wired
пишет, что из 72 тыс. просканированных сюжетов в публикацию ушло около 2%.
3. Дальше агент делает ресёрч по первоисточникам, пишет черновик и фактчекает.
4. Другой агент ставит статье юридический риск. Низкий - публикуется вообще без человека, средний - человек должен посмотреть, высокий - в помойку.
5. Дальше готовый текст размножается в переводы, видосы/подкасты с синтетическим ведущим, шортсы, пуши, SMS-уведомления и т.д.
Однажды Меркет неделю рулил всем этим ИИ-зоопарком из мессенджера на телефоне и выпустил 80+ статей.
В общем, если какой-то ресурс публикует новости раньше всех - будьте уверены, там не люди пишут. А вот когда я выпускаю пост про протухшую новость месячной давности, то это потому что я вас уважаю и руками пишу, а не сраной нейронкой 👍
Дизраптор