Эффективное претренирование LLM через суперпозицию токенов
К@quant_prune_distillAI-инженер
1 месОбзор метода повышения эффективности обучения LLM через усреднение эмбеддингов и предсказание групп токенов вместо последовательного обучения.
Этот метод может значительно снизить стоимость и время обучения больших языковых моделей.
- Позволяет модели обрабатывать несколько токенов одновременно вместо одного.
- Снижает вычислительную нагрузку на этапе претрейна.
- Предлагает альтернативный подход к традиционной токенизации для экономии ресурсов.
Efficient pretraining with token superposition
📄 Статья
📝 Блог
Обучать LLM становится всё дороже и дороже, поэтому проблема экономии ресурсов встаёт всё более остро.
Одним из перспективных направлений повышения эффективности обучения является изменение процедуры токенизации. Была статейка, где исследовался вопрос compute-optimal токенизации в зависимости от размера словаря и модели.
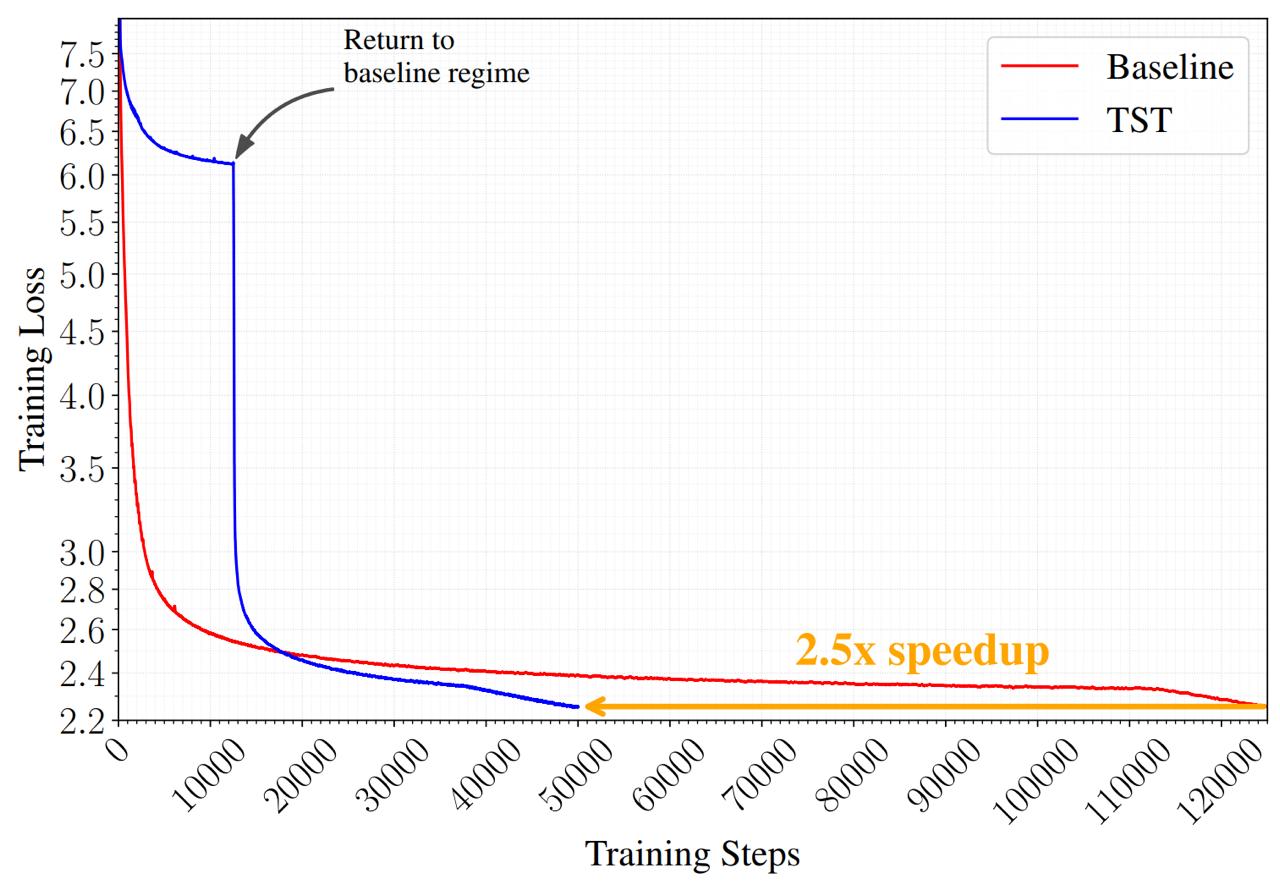
В данной же статье предлагают на первом этапе претрейна усреднять эмбеддинги нескольких подряд идущих токенов на входе модели и предсказывать bag-of нескольких следующих токенов на выходе, тем самым пытаясь моделировать несколько токенов за раз.
Кратко (AI)
В статье рассматривается метод оптимизации претрейна LLM, направленный на снижение вычислительных затрат. Авторы предлагают на начальном этапе обучения усреднять эмбеддинги нескольких входных токенов и предсказывать их группы на выходе, что позволяет модели обрабатывать больше данных за один шаг.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖