data-scienceСбросить фильтр ×

Вышел Python 3.15.0 со стабильными ленивыми импортами и frozendict

9 октября 2026 года вышла стабильная версия Python 3.15.0 — релиз включил 5643 коммита от около тысячи разработчиков. Главные изменения ориентированы на скорость запуска и удобство работы с данными: ленивые импортыi, неизменяемый словарь frozendicti, ускоренный JIT и UTF-8 по умолчанию.

Издание Machine learning Interview привело разбор Khuyen Tran из CodeCut с конкретными замерами, показывающими реальную выгоду новых фич для data-инженерии, а тон вокруг релиза среди части аудитории скептический — язык критикуют за скромность нововведений.

5643коммитов в релизе Python 3.15
7–8%прирост скорости от JIT на Linux
280 ms → 14 msускорение старта скрипта с ленивым импортом pandas

Полный разбор →

Раскрыта тайна знаменитого кейса Target и предсказания беременности

В@cryptovaleriiAI-инженер
2 нед

Как измерить эффективность персонализации рекомендаций

M@ml4valueAI-инженер
3 нед

Работа с форматами данных в Pandas

Б@backender0автор про «it»
4 нед
​​Как получить данные в нужном формате с помощью Pandas Дата-сайентистам приходится работать с данными разных форматов. Разбираемся, в чем заключается разница между длинным и широким форматами данных, а также в том, как перейти от одного формата к другому в Pandas. Подробнее: 👉 тут #изучаем

Блокировка аккаунта на Kaggle из-за автоматизации

D@datastorieslanguagesAI-инженер
4 нед
​​Меня тут это... на Kaggle забанили говорят, что за автоматизацию Единственная причина о которой я подозреваю - клод засабмитил ноутбук на тпу и проверял его статус раз в час или раз в полчаса Подал appeal, жду #kaggle

Итоги квалификационного этапа AI Challenge: 3D Mesh Quality Control

Т@tagir_analyzesAI-инженер
1 мес
Итоги квалификационного этапа AI Challenge: 3D Mesh Quality Control

Т-Технологии выпустили туториал по Perseus — фреймворку для моделей персонализации

Команда Т-Технологий (Т-Банк) опубликовала на Хабре подробный туториал по своему опенсорсному фреймворку Perseusi, предназначенному для обучения моделей персонализации на основе истории пользовательских событий. Ранее фреймворк уже был выложен в открытый доступ, теперь к нему добавили практическое руководство и код на GitHub.

В туториале на малой версии датасета T-ECDi разобрали четыре типовых сценария рекомендательных систем — кандидатогенерацию, ранжирование, классификацию и регрессию — и показали весь путь от подготовки данных до инференса. Материал особенно полезен тем, кто работает с рекомендательными системами и мультидоменными данными: Perseus позволяет добавлять новые признаки или события из другого домена без пересборки пайплайна.

4сценария применения фреймворка
7 днейгоризонт прогноза в задаче классификации
30 днейгоризонт прогноза в задаче регрессии (по одному из источников)

Полный разбор →

Проблема калибровки ML-модели из-за утечки фичи дня недели

K@knowledge_accumulatorмедиа / агрегатор
1 мес

Критика методологии предсказательных моделей на синтетических данных

Н@not_boring_dsмедиа / агрегатор
1 мес

Как работают алгоритмы рекомендаций в видеосервисах

К@d_codeмедиа / агрегатор
2 мес
🧠 Как видеосервисы узнают, что вы хотите посмотреть Лайки — далеко не главный сигнал для рекомендаций видео. Алгоритмы оценивают, какие ролики вы досматриваете, что включаете следующим, что пересматриваете и чем интересуетесь прямо сейчас. Рассказываем, как видеосервисы анализируют эти сигналы, зачем им миллионы характеристик и какой путь проходит ролик, прежде чем попасть именно в вашу ленту: ☀️ https://kod.ru/kak-rabotayut-rekomendacii-videoservisov
Как работают алгоритмы рекомендаций в видеосервисах

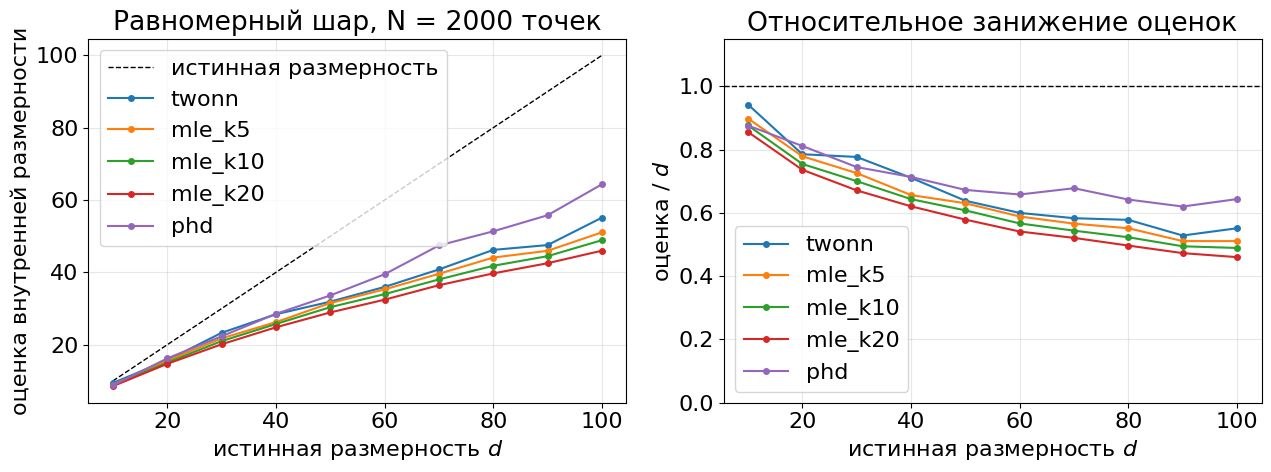
Проблема занижения оценки внутренней размерности облака точек

Т@tech_priestessAI-инженер
2 мес
Проблема занижения оценки внутренней размерности облака точек

SEO-хакинг через анализ графов каталогов

�@datafeelingмедиа / агрегатор
2 мес

Исследование 694 карьер в Data Science: от стажёра до Head of DS

Автор канала «Нескучный Data Science» подвёл итоги зарплатного опроса, который проводил больше года назад: вместо очередной таблицы «кто сколько получает» получилось большое исследование карьерных траекторий в Data Science. Материал опубликован на Хабре и охватывает не только доходы, но и профессиональный рост, удовлетворённость работой и готовность её сменить.

В анализ вошли 694 анкеты из 695 собранных — по словам автора, они «превратились в технический долг», который читатели регулярно напоминали закрыть в комментариях.

694анкет вошло в анализ
4,5 млн рублейзарплата CDS

Полный разбор →

МТС True Tech и ВТБ провели офлайн-митап «Урбан ML» в Москве

2 августа в Москве прошёл офлайн-ивент «Урбан ML», организованный МТС True Tech совместно с ВТБ. За один день на площадке собрались 547 участников, чтобы обсудить практические кейсы Data Science.

В трёх залах прозвучало 17 выступлений и мастер-классов по рекомендательным системам, антифродiу, NLP, LLM и агентным системам — с участием представителей Звука, Wildberries, MWS, ВТБ, Сбера, ВШЭ и Яндекса.

547участников мероприятия
17выступлений и мастер-классов

Полный разбор →

Эволюция соревнований на Kaggle

D@data_secretsAI-инженер
2 мес
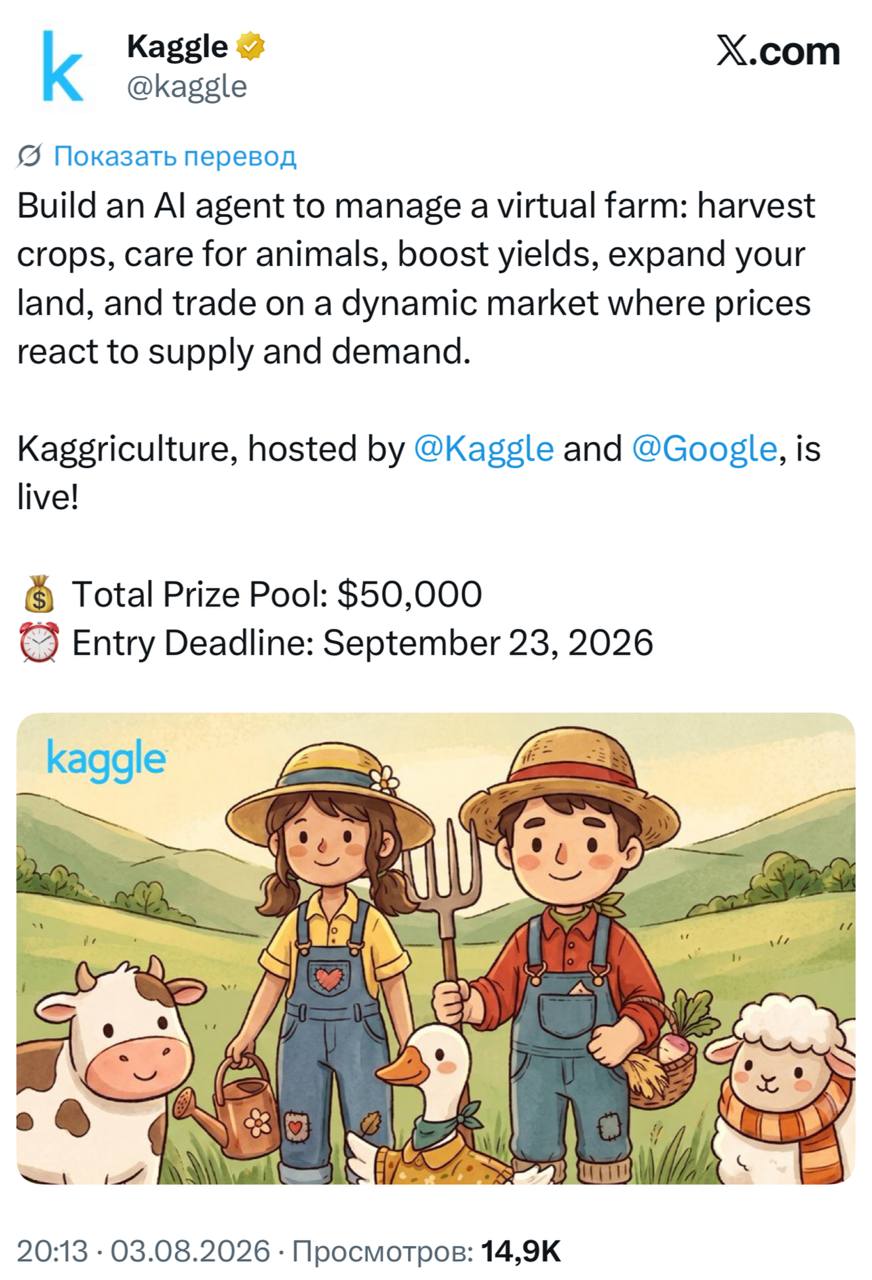
Соревнования на Kaggle 5 лет назад: вручную собери мультимодальный датасет на 50 гигабайт, обучи ансамбль бустингов, зафайнтюнь ResNet под кастомную аугментацию, выжми 0.0001 AUC стекингом Соревнования на Kaggle сейчас: сделай агента, который будет доить виртуальную корову 🧑‍🌾
Эволюция соревнований на Kaggle

Обзор книги Python for Algorithmic Trading Cookbook

D@datastorieslanguagesAI-инженер
3 мес

Интерактивная карта навигации по Telegram-каналу

П@neural_proseccoмедиа / агрегатор
3 мес

Обзор книги Time Series with PyTorch

D@datastorieslanguagesAI-инженер
3 мес

AI-агенты в соревнованиях Kaggle: опыт Data Sanity

D@datastorieslanguagesAI-инженер
3 мес
​​Data Sanity Talks: AI-Driven Participation in Kaggle Competitions https://datasanity.dev/data-sanity-talks-london-2026-07-23.html На следующей неделе будет оффлайн ивент в Лондоне, где я буду рассказывать о своём опыте применения агентов для участия в каггл соревнованиях, говорить, что работает и что не работает. Запись будет доступна позже #ai

Google представила ИИ-модели SensorFM и TabFM — для данных с носимых устройств и таблиц

Google выпустила две базовые ИИ-модели, которые работают не с текстом, а напрямую с «сырыми» данными: SensorFMi — для сигналов с носимых устройств (часы, браслеты, трекеры), TabFMi — для табличных данных. Обе призваны заменить множество узкоспециализированных решений универсальными платформами и решают проблему, когда числовые данные пытаются «впихнуть» в обычную языковую модель типа ChatGPT или Claude — при переводе в текст структура и точность чисел теряются.

SensorFM обучена на триллионе минут данных пяти миллионов человек и, по данным источников, на 34 из 35 медицинских задач превосходит модели, которые эксперты годами настраивали вручную. TabFM решает похожую задачу для таблиц (данных бизнеса и аналитики) без обучения на реальных данных — только на синтетике — и без необходимости ручной подготовки признаков.

триллион минутобъём данных для обучения SensorFM
5 млн человекчисло людей, чьи данные использованы
34 из 35медицинских задач, где SensorFM обошла экспертные модели

Полный разбор →

Измерение влияния персонализированных рекомендаций Netflix

Р@researchoshnayaAI-инженер
3 мес

Искусство создания сильных бейзлайнов в ML

M@ml4valueAI-инженер
4 мес

Producer-side A/B-тесты: как измерять влияние на авторов контента

K@knowledge_accumulatorмедиа / агрегатор
3 мес

Методы визуализации результатов моделей машинного обучения

Б@boris_againAI-инженер
3 мес
Я считаю не надо на этом останавливаться. Вот несколько недоисследованных идей как лучше презентовать результаты своих моделей: 1. Менять ширину столбиков абсолютно легально 2. Не забываем про альфа канал
Ещё ↓