aiСбросить фильтр ×

Исследование поведения LLM в симуляции ядерного кризиса

N@NeuralShitAI-инженер
4 нед

Александр Горный выпустил еженедельный видеодайджест новостей ИИ с монтажом от нейросети вместо человека

Александр Горный (каналы «Стартап дня» и «GPT/ChatGPT/AI Central») выпустил на YouTube очередной еженедельный ролик с главными новостями в сфере ИИ, но впервые смонтировал его не с фрилансером-монтажёром, а с помощью нейросети.

Автор признаёт, что результат, вероятно, уступает работе крупных каналов с профессиональным монтажом, но сопоставим с тем, что он получал от разных фрилансеров все прошлые годы, а возможно, даже лучше. По его словам, минусов у перехода на автоматизацию он не видит.

82%упомянутая доля студий в новостях
10%доля электромобилей в новостях
+24%рост показателя YouTube

Полный разбор →

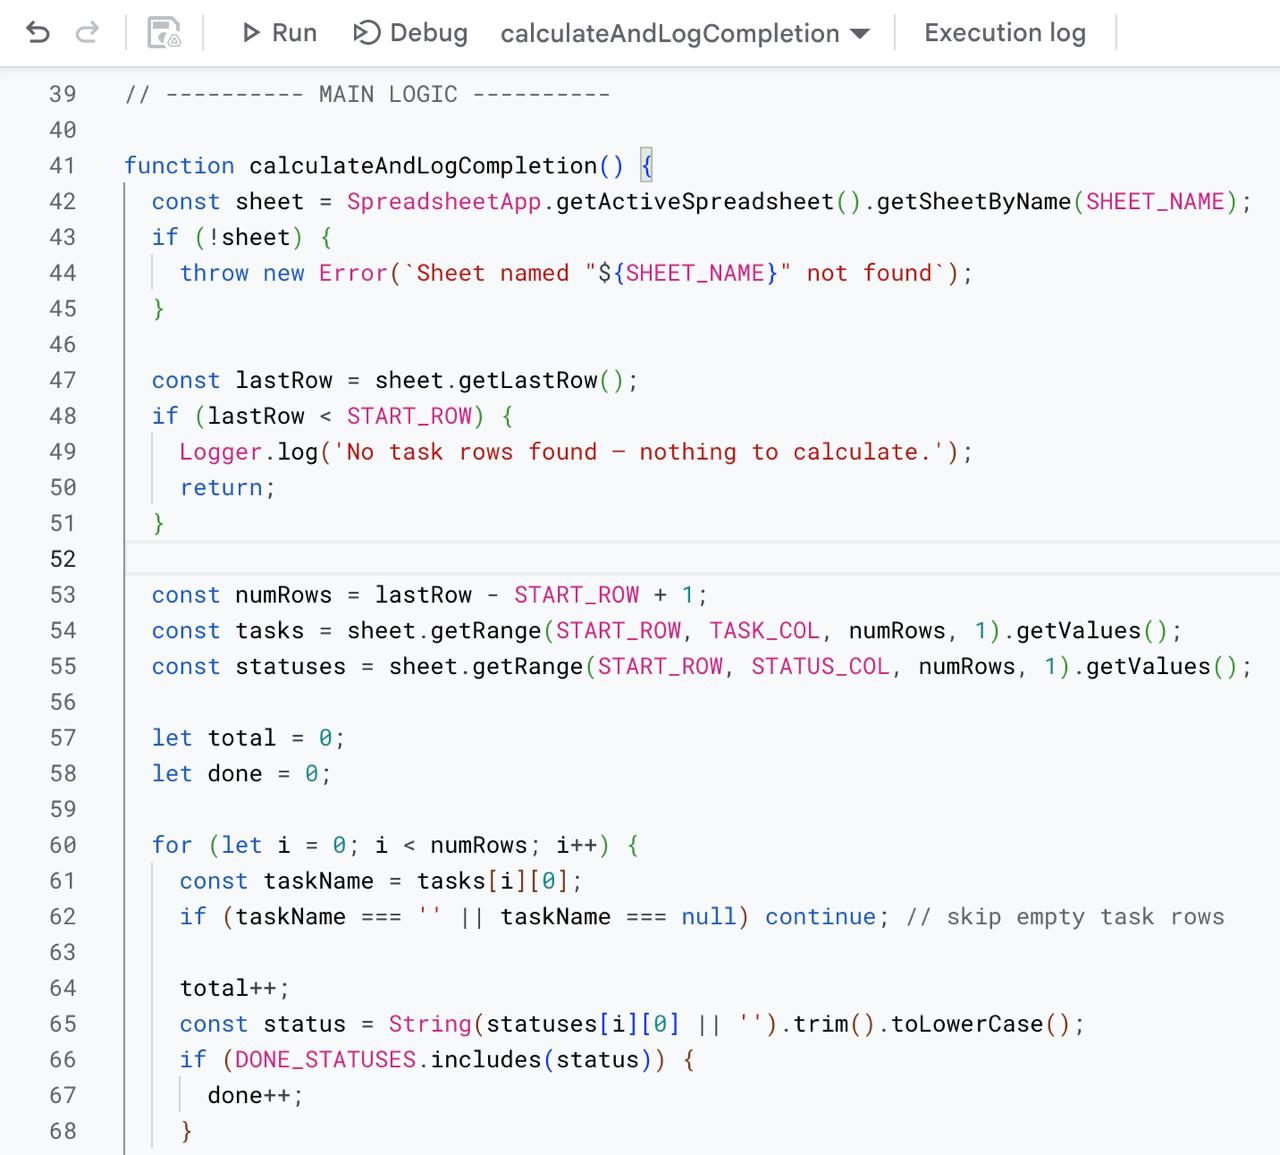
Как ИИ упрощает работу с Google Sheets и App Script

М@pm_godпродакт / фаундер
4 нед
Как ИИ упрощает работу с Google Sheets и App Script

Тезис: классический бизнес нужно строить AI-native с первого дня

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 4 нед назад

В посте (часть серии «7/8») утверждается, что запускать классический бизнес по-прежнему можно, но строить его нужно сразу как AI-nativei. Идея в том, что традиционный бизнес несёт много операционной неэффективности, а грамотное внедрение AI с первого дня превращает эту неэффективность в маржинальность.

Речь идёт о принципе построения компании: собирать максимум контекста, хранить и обрабатывать его, с самого старта внедрять автоматизации, агентов и harnessi (инфраструктуру для работы AI-агентов).

7/8номер тезиса в серии из восьми

Полный разбор →

Эволюция оплаты за софт: от лицензий к оплате за результат

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 4 нед назад

Авторы формулируют тезис о смене модели монетизации технологий: если платить не за софт как таковой, то следующим шагом станет оплата за конкретный результат, а не за инструмент или доступ к нему.

По их мнению, рынок уже прошёл путь от вечных лицензий через подписки к оплате за токены — и каждый переход приближал клиента к оплате фактического использования, а не потенциальной возможности.

Полный разбор →

Юридический разбор условий использования Kling 4.0

Н@neuronutsAI-инженер
4 нед
Kling так или иначе пробовал почти каждый AI-режиссёр. Ну а с обновой Kling 4.0 интерес к модели возвращается. Поэтому самое время юридического разбора, ведь мало кто открывал «подвал» сайта. Я прочитал все семь документов: Terms of Service, Privacy Policy, Terms of Paid Service, Credits Policy, Community Guidelines, Copyright Complaint Policy и страницу AI Content Detection. И вот что там написано. Читайте самый полный разбор 👇 https://egorappolonov.com/kling-terms.html
Юридический разбор условий использования Kling 4.0

B2C-продукты без интерфейса: новый тренд в AI

P@productgamesпродакт / фаундер
4 нед

77-летний предприниматель использует ChatGPT для бизнес-планирования

C@campcodeAI-инженер
4 нед
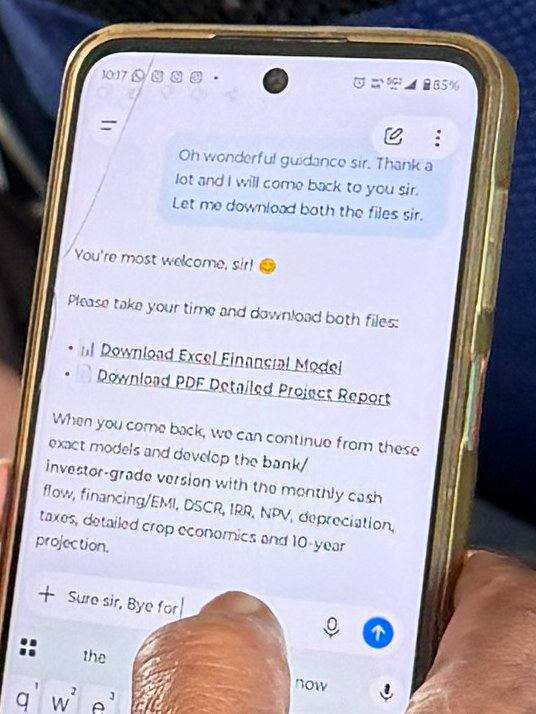
И какие у тебя теперь оправдания? 77-летний вайбкодер прямо в самолёте пилил с ChatGPT бизнес-план вертикальной фермы. Причём к нейронке дед обращается исключительно «сэр» и уже считал с ней денежные потоки, IRR и NPV на 10 лет. Хочу быть им, когда вырасту 🕶
77-летний предприниматель использует ChatGPT для бизнес-планирования

Buzz — бесплатный локальный инструмент для транскрибации аудио и видео

В Telegram-каналах разошёлся опенсорсный инструмент Buzz — программа для транскрибации звука, которая работает полностью локально на компьютере, без отправки данных в облако. Она построена на моделях Whisperi и доступна для Mac, Windows и Linux.

Инструмент принимает на вход аудио- и видеофайлы, ссылки на YouTube и живую запись с микрофона, а также умеет различать говорящих и выводить субтитры — это отличает его от простой транскрибации через облачные сервисы типа ChatGPT.

Полный разбор →

Плановое обслуживание кода при разработке с AI-агентами

О@orgprogавтор про «it»
4 нед

Global Gender Gap Report 2026: анализ карьерной воронки

Д@dashich_begiкарьера / HR
4 нед

Алёна Феногенова представила 5 новых линеек бенчмарков для русскоязычных языковых моделей

На конференции AI RnD Day Алёна Феногенова представила пять новых линеек тестов для оценки современных LLM на русском языке. Главный тезис: один общий балл в метрике плохо описывает модель для реального применения — качество зависит от связки «модель × обвязка × промпт × окружение», поэтому нужны раздельные замеры разных навыков.

Пять линеек охватывают разные аспекты: LIBRAi — работа с длинным контекстом, MERAi Reason — математические рассуждения, MERA Text 2.0 — языковые, культурные и прикладные навыки, RUMBA — память между сессиями, harness-bench-fasti — работа в агентной обвязке (выбор инструмента vs успешное выполнение действия в среде).

ВыводLIBRA Mini: из 18 задач полной LIBRA выбрано 6 сложных, диапазон контекста от 4K до 512K токенов, запуск через lm-evaluation-harness; задачи требуют связывать факты из разных частей текста, отвечать по нескольким статьям Wikipedia, определять человека по теме диалога, считать уникальные абзацы среди повторов

62,2 → 39,8 → 12,6падение балла Qwen3-30B-A3B на LIBRA (4K/64K/128K токенов)
8700запросов в MERA Text 2.0
в 4,3 разасокращение объёма MERA Text 2.0

Полный разбор →

Обновления экосистемы YuE2: техрепорт, VAE и новые инструменты

Н@GreenNeuralRobotsAI-инженер
4 нед

Российские разработчики выпустили WebPageBench — бенчмарк для проверки веб-агентов на русскоязычных сценариях

Команда, работавшая над проектом год, представила WebPageBenchi — локальную тестовую среду для оценки ИИ-агентов, выполняющих повседневные задачи на сайтах (покупки, бронирование билетов и отелей, заказ справок) на русском языке. Ключевая идея: вместо реальных сайтов, где интерфейсы меняются, антибот блокирует прогоны, а заказы с оплатой становятся настоящими, используются шесть мок-версий популярных сервисов, где каждое действие агента фиксируется в лог и проверяется автоматически, а не со слов самого агента.

Бенчмарк важен, потому что впервые показывает объективный разрыв между тем, что агенты сообщают о своей работе, и тем, что они реально сделали — а разрыв оказался значительным.

152всего задач в бенчмарке
24связок «модель + обвязка» на лидерборде
41 пунктразрыв между заявленным и реальным успехом

Полный разбор →

Paperclip — opensource-оркестратор, превращающий ИИ-агентов в виртуальную компанию

Появился инструмент Paperclipi — оркестратор, который объединяет Claude Code, Codex, Cursor, OpenClawi и другие ИИ-агенты в полноценную виртуальную команду с должностями, иерархией и бюджетами. Пользователь назначает агентам роли (CEO, CTO, CMO, дизайнер, разработчик, маркетолог), ставит задачи и цели, а дальше агенты сами координируют работу через систему тикетов, похожую на Jira или Gitlab.

Проект бесплатный, с открытым исходным кодом и разворачивается локально; репозиторий уже набрал почти 100 тыс. звёзд на GitHub. Систему уже используют на практике — и первые пользователи столкнулись с тем, что поддержание такой виртуальной оргструктуры сжигает большие объёмы токенов, что заставляет искать способы оптимизации расходов.

~100 тыс.звёзд репозитория Paperclip на GitHub
10 разлимит запусков задачи в сутки до автопаузы

Полный разбор →

Курс Stanford CS329A по Retrieval-Augmented Language Modeling

L@lovedeathtransformersAI-инженер
4 нед
https://cs329a.stanford.edu/ Huh? Курс стенфорда по RSI. Тут есть проблема что RSI прекрасен как концепция, но ужасен когда ты его делаешь иии он почти не работает на текущем поколении моделей. Но сами статьи клёвые, точно стоит почитать.
Ещё ↓