Зарелизили WebPageBench: бенчмарк для оценки веб-агентов
M@mashkka_dsAI-инженер
4 недПредставлен WebPageBench — новый бенчмарк для оценки веб-агентов на русском языке с использованием локальных мок-сайтов и лог-верификации.
Новый инструмент позволяет объективно измерить реальную эффективность ИИ-агентов в веб-интерфейсах.
- Позволяет разработчикам проверять, действительно ли агент выполнил задачу, а не просто «галлюцинирует» об успехе.
- Выявляет разрыв между заявленной и реальной эффективностью моделей.
- Помогает понять, какие методы (DOM vs скриншоты) лучше работают для автоматизации браузерных задач.
🚀 Зарелизили WebPageBench: бенчмарк для оценки веб-агентов на повседневных задачах
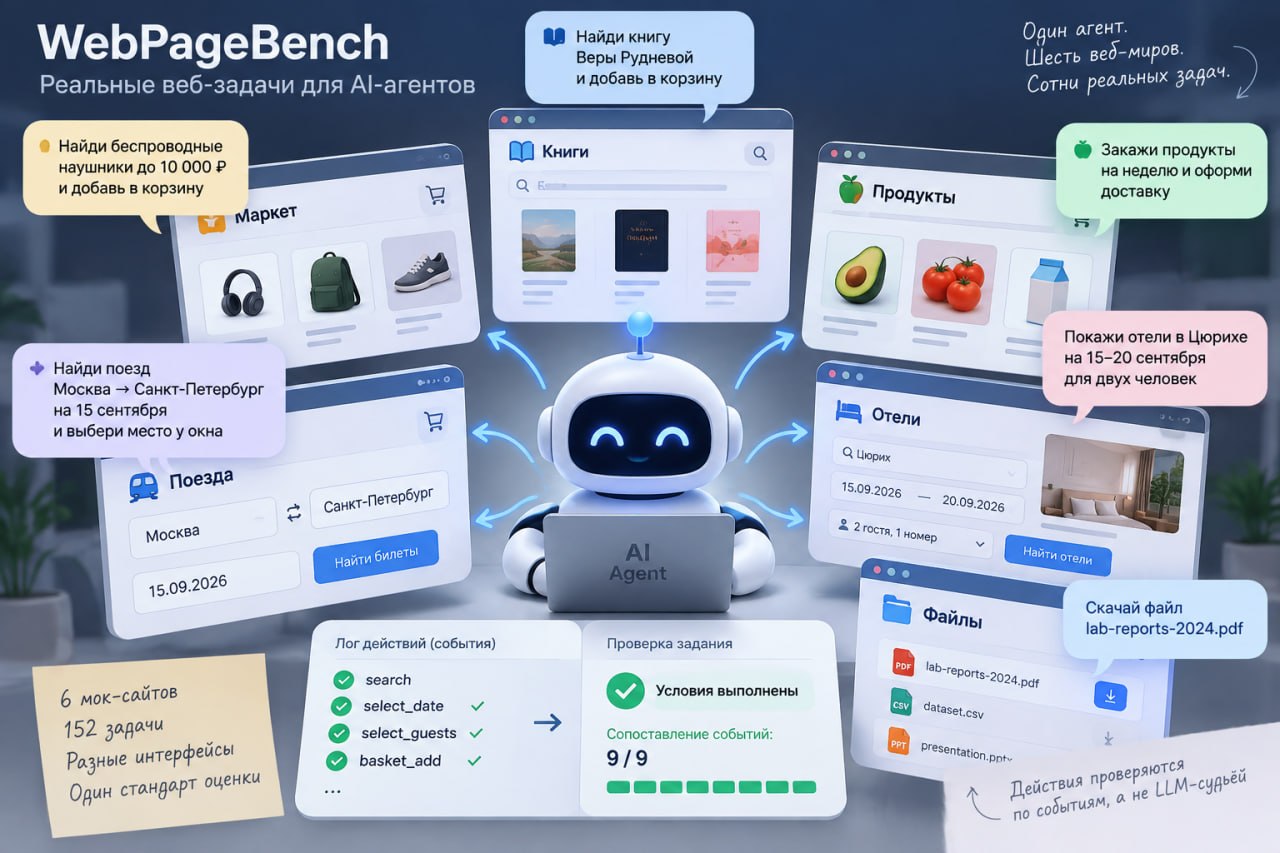
Год мы работали над этим проектом, и вот наконец представляем миру WebPageBench, бенчмарк для оценки веб-агентов в повседневных сценариях на русском языке (покупки в магазине, бронь билетов и отелей, заказ справок и так далее).
Откуда ноги растут: гонять агентов по реальным сайтам неудобно, потому что интерфейсы меняются, антибот режет прогоны, а сценарии с корзиной и оплатой это настоящие заказы. Но главное, на живом сайте невозможно узнать, что агент реально сделал: остается верить ему на слово. В ответ на это мы и сделали WebPageBench, локальную среду из шести мок-сайтов, где каждое действие агента записывается в лог, по которому проверяется успех.
🚀 Что внутри:
✔️Шесть русскоязычных моков сайтов: маркетплейс, книги, доставка продуктов, ЖД-билеты, отели и файловый кабинет. Все обезличено, но повторяет популярные у нас сервисы, и поднимается локально.
✔️Проверка по логу событий, а не по словам агента. Каждое действие на странице пишется как типизированное событие с параметрами, а условие задачи это событие, которое должно появиться в логе. Никакой модели-судьи в цепочке нет, и проверка не зависит от языка интерфейса.
✔️152 задачи: 65 написанных руками сценариев и 87 их вариаций.
✔️Контролируемые варианты интерфейса. Одна и та же задача рендерится через разные реализации одного элемента (календарь всплывашкой против нативного input, счетчик гостей четырьмя способами). Текст задания и условия при этом не меняются, так что видно, агент не понял задачу или не справился с конкретным виджетом.
✔️Публичный лидерборд: 24 связки «модель + обвязка», прогнанные по всем задачам.
🚀 Что уже видно по результатам:
✔️Агенты систематически завышают свой успех. Одна связка отчиталась о выполнении всех задач до единой, а лог подтвердил 59%. Разрыв в 41 пункт! При этом бывает и наоборот: другая модель решила больше, чем сама о себе доложила.
✔️Лучшая обвязка зависит от модели, универсального рецепта нет. Та обвязка, что подняла одну модель, другую роняет на последнее место.
✔️Агенты по скриншотам заметно отстают от DOM-агентов. Особенно наглядно внутри одной модели: по DOM она решает 0,76, по скриншотам 0,48.
✔️Дорого не значит хорошо. Самый дорогой прогон в таблице ($76) дает результат хуже, чем прогон за $3.
Если делаете веб-агента, присылайте свои результаты: подключить свою обвязку это один адаптер.
👉 Habr
👉 Код и задачи
👉 Лидерборд на HuggingFace
👉 Препринт
@mashkka_ds
#agents #benchmark #webagents
Кратко (AI)
Разработчики представили WebPageBench — бенчмарк для тестирования веб-агентов на повседневных задачах, таких как покупки или бронирование. Система использует шесть локальных мок-сайтов и проверяет действия агентов через логи событий, что исключает предвзятость моделей-судей. Результаты показывают, что агенты часто завышают свои успехи, а DOM-ориентированные подходы показывают себя лучше, чем работа со скриншотами.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖