optimizaciiaСбросить фильтр ×

Новый метод претрейна LLM: усреднение токенов на входе и предсказание «мешка» токенов на выходе ускоряют обучение

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Исследователи предложили способ сэкономить вычислительные ресурсы при предобучении языковых моделей: на первом этапе претрейна модель учится не на отдельных токенах, а на усреднённых эмбеддингах нескольких подряд идущих токенов, при этом на выходе предсказывается не следующий токен, а «мешок» (bag-ofi) из нескольких следующих токенов без учёта их порядка. После этой стадии обучение продолжается в стандартном режиме.

Экономия достигается за счёт того, что через модель прогоняется в s раз меньше токенов, а значит за тот же вычислительный бюджет модель успевает увидеть больше данных из корпуса — в r·s + (1 − r) раз больше, где r — доля обучения на усреднённых токенах, s — размер окна усреднения.

ВыводМетод проверен на трёх dense llama-like моделях размером 270M, 600M и 3B, а также на MoE-модели 10B-A1B.

0.2–0.4оптимальная доля r обучения на усреднённых токенах
5–8оптимальный размер окна усреднения s
270M/600M/3B/10B-A1Bразмеры протестированных моделей

Полный разбор →

Обновление контентной базы: 398 видео по оптимизации

П@mflenovмедиа / агрегатор
1 мес
Чтобы не загружать вас часто я решил дать обновление по плюсу через две недели. А за две недели вышло четыре видео и я начал новый цикл по оптимизации. 🤩 Всего теперь доступно 398 видео или 12292 минут контента или более 204 часов. Список всех доступен здесь. Для удобства можно использовать Roadmap по видосам.
Обновление контентной базы: 398 видео по оптимизации

HyperFlow: ускоритель для MiniMaxH3

Н@GreenNeuralRobotsAI-инженер
1 мес

Nvidia представила SoL-Pi для оптимизации токенов

C@campcodeAI-инженер
1 мес
Ночное-полезное: Nvidia выложила в опенсорс SoL-Pi — систему, которая улучшает харнесс и сокращает расход токенов почти вдвое 😨 Исследователи перебрали множество вариантов обвязки, протестили и собрали в SoL-Pi четыре лучших механизма: они уменьшают повторные действия, сжимают контекст, результаты и логи. Благодаря этому на EdgeBench с GPT-5.6 Sol и Opus 5 удалось сократить расход токенов на 50%, сохранив сопоставимое качество. А стоимость работы агентов через API упала примерно на треть. Неплохой способ сэкономить. Статья здесь, код тут 🤑

Как разработчики боролись с лагами в топ-даун шутере перед показом паблишеру

Х@habr_comмедиа / агрегатор
1 мес
Грязные игры Команда бывших нефтяников решила оставить след в индустрии и собрала топ-даун шутер. Двести врагов на экране, игровая логика ест сущие крохи бюджета кадра, а игру всё равно потряхивает, и до показа паблишеру два дня. Логику можно ускорить в 20 раз и не выиграть ни одного лишнего кадра, потому что лаг приходит совсем не оттуда, где его привыкли искать. То, что они сделали за эти двое суток, звучит как капитуляция перед всем, чему учат на конференциях по разработке. И это сработало.
Как разработчики боролись с лагами в топ-даун шутере перед показом паблишеру

Расширение pi-duck-mode для оптимизации токенов в pi

Б@boris_againAI-инженер
1 мес
На волне ряда сравнений разных харнессов я пересел на pi. Он отличный, всем рекомендую. Но я заметил, что он всё ещё тратит слишком много токенов, поэтому сделал своё расширение: https://github.com/btseytlin/pi-duck-mode Добавляет /duck режим в котором харнесс тратит в 14х раз меньше токенов, TPS в 798x раз больше! При этом качество кода только растет

Китайское исследование «The Last AI Built by Humans»: дорожная карта рекурсивного самосовершенствования ИИ

Группа из 33 китайских исследователей опубликовала 75-страничную работу «The Last AI Built by Humans», в которой формализовала концепцию рекурсивного самосовершенствования (RSI) ИИ. Авторы проанализировали 491 существующую разработку, чтобы определить путь развития систем, способных самостоятельно улучшать не только свои навыки, но и сам механизм собственного совершенствования.

Исследование предлагает пятиуровневую шкалу автономности ИИ, аналогичную классификации беспилотных автомобилей. Работа подчеркивает, что текущие передовые модели находятся лишь на начальных этапах (L1–L2), а создание полноценного сверхинтеллекта требует перехода к мета-уровням, где ИИ берет на себя функции R&D.

ВыводВ состав авторского коллектива вошли представители Tsinghua, ByteDance, Shanghai AI Lab, ModelBest и Xiaohongshu.

491количество проанализированных научных работ
5уровней автономности самосовершенствования ИИ
5,9%доля работ, достигших уровня L5

Полный разбор →

ИИ начали создавать собственные диалекты для общения

I@itcnewsruавтор про «tech»
1 мес
ИИ начали придумывать собственные диалекты Исследователи Emergence заметили, что ИИ при общении друг с другом самостоятельно создают непонятные людям термины. Например, DeepSeek использует «кузнец» для вспомогательных моделей, а Anthropic - «холодные руки» для рецензентов. Модели делают это без специальных инструкций, чтобы экономить вычислительные ресурсы. Но чем сложнее станут такие диалекты, тем труднее людям будет контролировать действия ИИ.
ИИ начали создавать собственные диалекты для общения

Энтузиаст запустил DLSS 5 на встроенной графике Intel

P@prohitecавтор про «tech»
1 мес
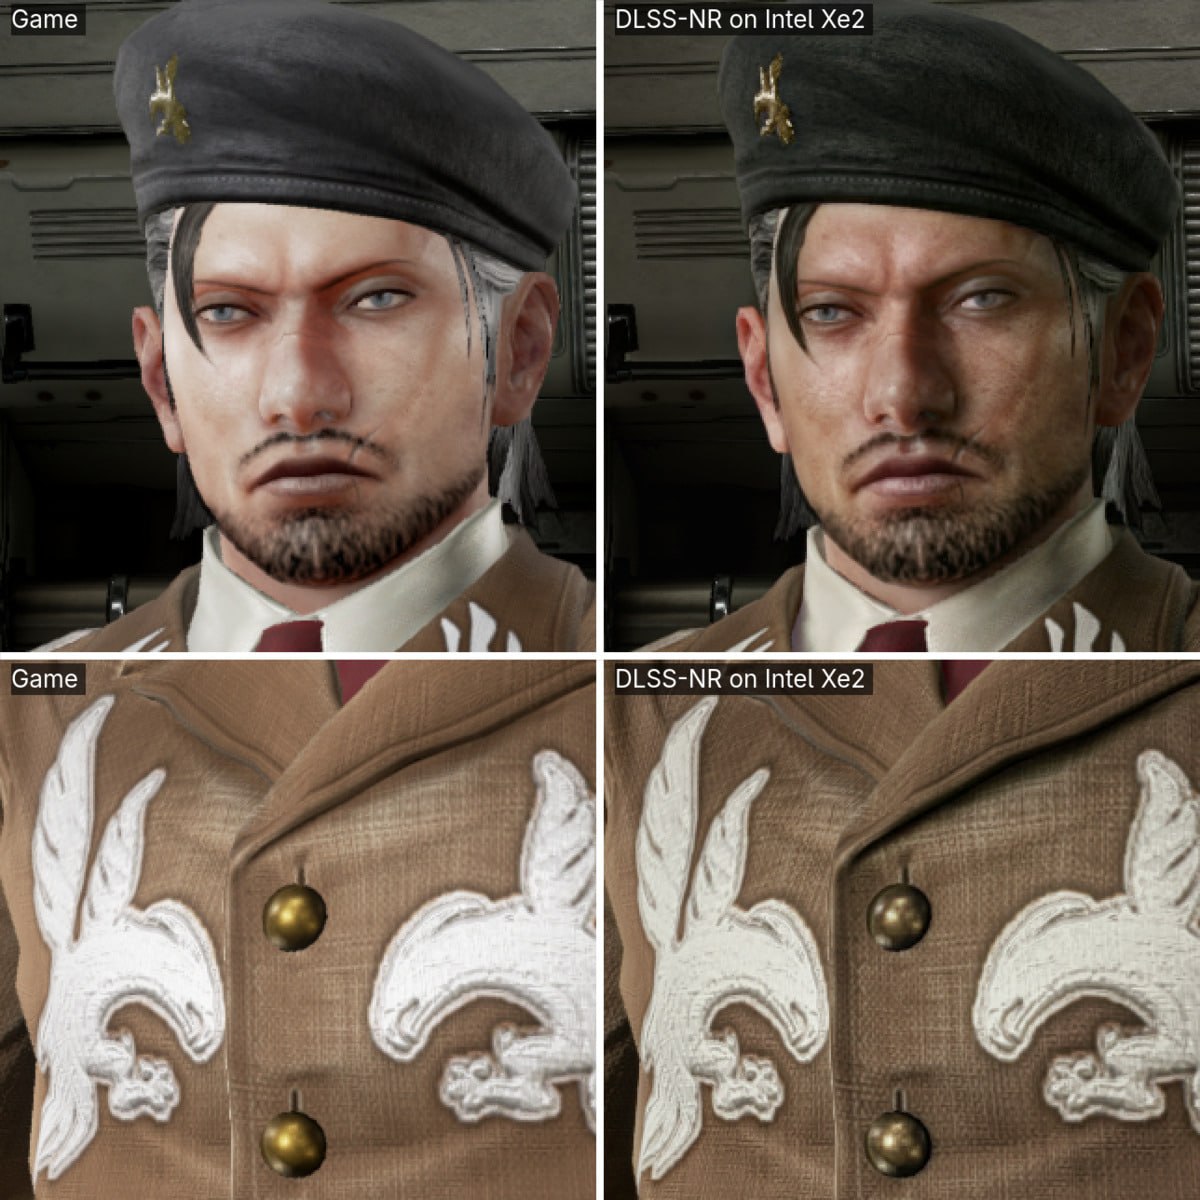
Энтузиаст запустил DLSS 5 на встроенной графике Intel

Опыт MWS Cloud Platform: оптимизация CEL для работы с Protobuf

Х@habr_comмедиа / агрегатор
1 мес
Опыт MWS Cloud Platform: оптимизация CEL для работы с Protobuf

Z.ai: модель GLM-5.3 помогла построить inference-инфраструктуру для GLM-5.3-Flash

Компания Z.ai рассказала о практическом кейсе Recursiive Self-Improvement (RSI): модель GLM-5.3 совместно с инженерами компании участвовала в построении и оптимизации inference-инфраструктуры для новой модели GLM-5.3-Flash. ИИ-агент на базе GLM-5.3 искал ошибки в коде и оптимизировал kernels, bottleneck'и и inference engine — то есть модель фактически помогала разворачивать production-инфраструктуру для своей же младшей версии.

По данным компании, благодаря такому подходу систему довели до готовности к запуску менее чем за две недели, а пропускную способность увеличили втрое относительно первой версии на том же железе.

3 разарост производительности инфраструктуры
2 неделисрок доведения системы до запуска

Полный разбор →

Релиз адаптера для замены текстового энкодера в FLUX.2-klein-4B

L@lovedeathtransformersAI-инженер
1 мес
Релиз адаптера для замены текстового энкодера в FLUX.2-klein-4B

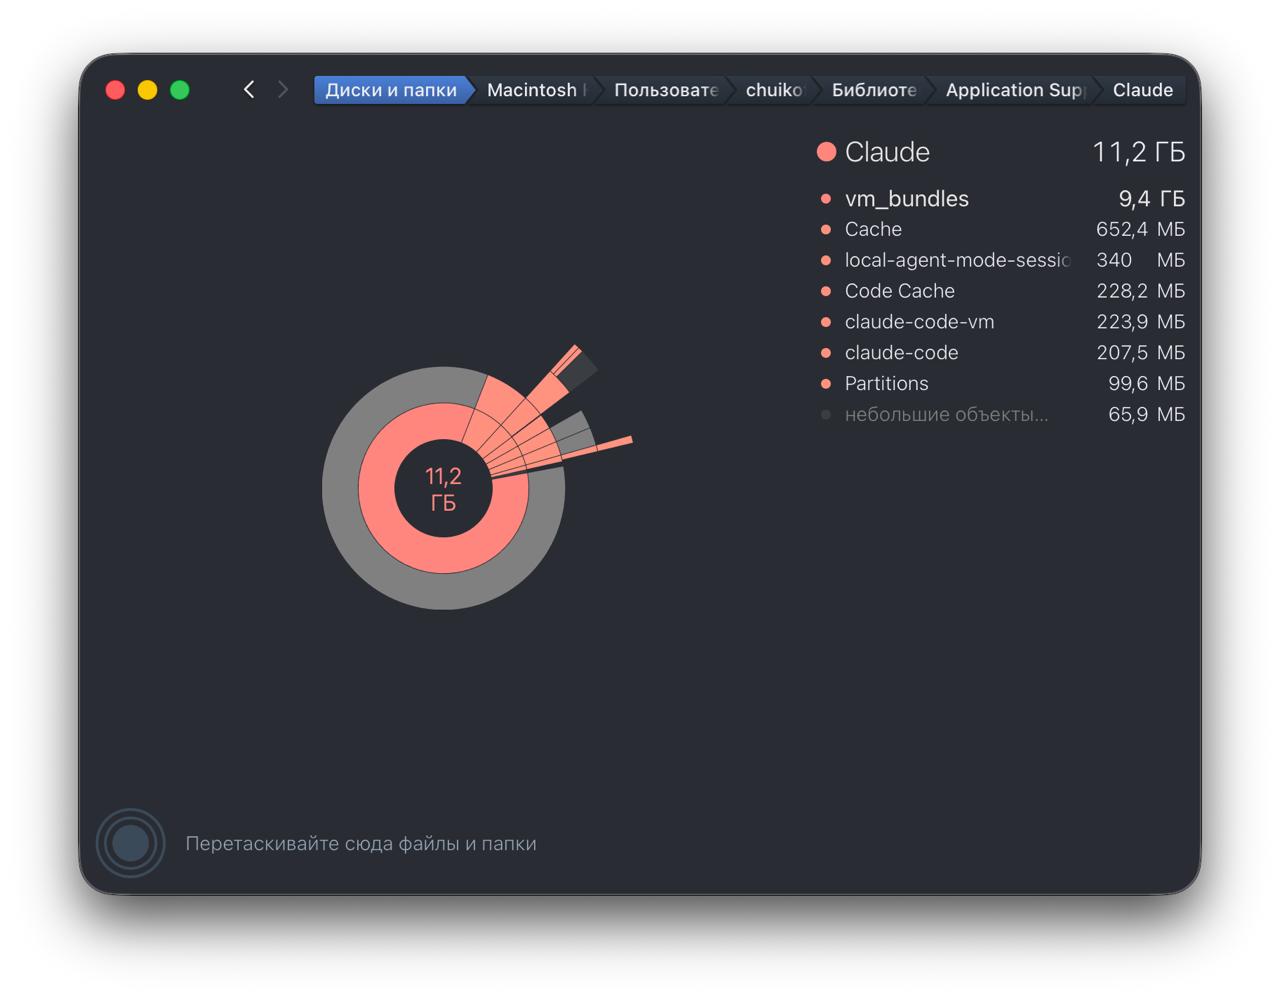
Claude Code против десктопной версии: экономия места

В@vibe_coding_channelAI-инженер
1 мес
Claude Code против десктопной версии: экономия места

Настройка Windows 10 и 11 с помощью GTweak

Р@remediaгеймдев
1 мес
Настраиваем Windows 10 и 11 — GTweak помогает сделать всё под себя⌨ Тулза отключит лишние службы, телеметрию, обновления и встроенных помощников, уберет предустановленные приложения и OneDrive, изменит интерфейс и оптимизирует параметры производительности. Также GTweak умеет чистить временные файлы и кэши, управлять настройками клавиатуры и мыши, проверять конфигурацию железа, настраивать энергопотребление и запускать собственные скрипты с повышенными правами. Утилита с открытым исходным кодом доступна — здесь.
Настройка Windows 10 и 11 с помощью GTweak

Declarative Attention: LLM учат самостоятельно выбирать, куда «смотреть», без дополнительного обучения

AI-редакция
2 источника · показать все· свернуть
собирается · 2обновлено 1 мес назад

Исследователи предложили метод Declarative Attentioni (DA), позволяющий языковой модели самой решать, какую часть длинного контекста учитывать при генерации ответа — без обучаемых селекторов и дополнительной тренировки. Модель размечает свои действия специальными хэштегами трёх типов внимания, а инференс ускоряется за счёт блочно-разреженной маски в vLLMi.

Это важно, потому что full attention остаётся дорогим местом в современных LLM даже на фоне более дешёвых GDN, SSM и скользящего окна, а существующие решения (в DeepSeek, MiniMax, Qwen) требуют обучаемых механизмов выбора токенов. DA показывает, что модель может справляться с этой задачей декларативно — просто указывая, куда смотреть.

ВыводЗадача подаётся модели в формате: системная инструкция → чанкированный контекст → вопрос → инструкция по использованию Declarative Attention.

2048целевой размер чанка контекста в токенах
1–3%просадка качества на крупных моделях
16/32паддинг размера чанков под блоки

Полный разбор →

Эффективность нейросетевых агентов: от «может ли» к «как дешевле»

С@svyatamestoAI-инженер
1 мес
Эффективность нейросетевых агентов: от «может ли» к «как дешевле»

Влияние вайб-кодинга на процессы разработки

Г@gmorevaAI-инженер
1 мес

Обновление библиотеки DeepGEMM

К@quant_prune_distillAI-инженер
1 мес
Мощное обновление DeepGEMM 👨‍💻 PR Добавляют: • Sparse Indexer из DeepSeek-V4.1-Flash • Mega Gate - слияние гейтов и GroupedGEMM (дает 30–75% ускорения против чего-то) • Mega mHC - слияние mHC и RMSNorm в единый кернел • Интеграцию с DeepJIT Оптимизировали: • Backward в GroupedGEMM на 20% • Mega MoE оптимизации под V4.1 Само обсуждение, как с участием кожаных мешков, так и ИИшки, на китайском, чтобы варвары ничего не поняли.

Обзор стека ИИ-инструментов для разработки и оптимизации затрат

A@qachanellавтор про «it»
1 мес

Метод сжатия аудио-энкодера X-AuT для речевых LLM

Н@GreenNeuralRobotsAI-инженер
1 мес
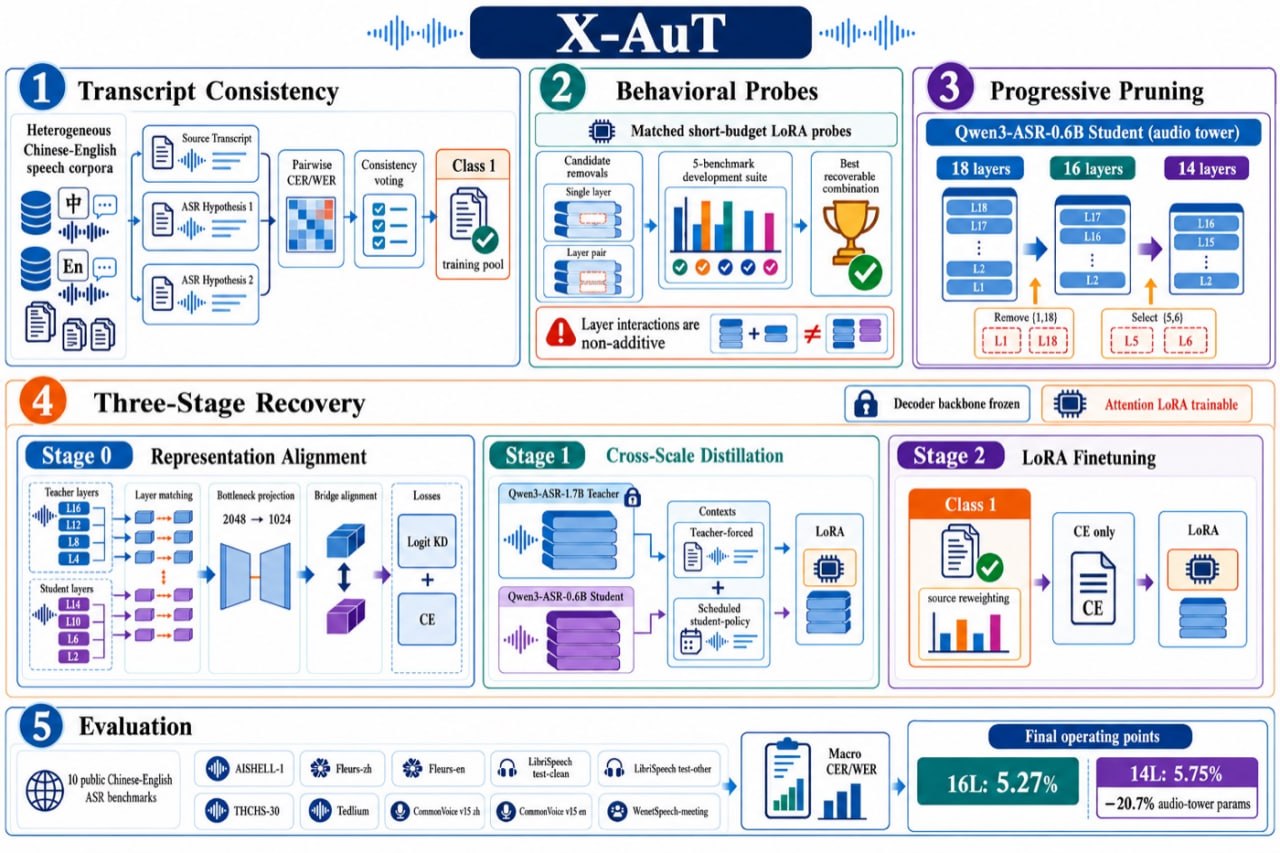
X-AuT Метод сжатия аудио-энкодера для речевых LLM на примере Qwen3-ASR-0.6B. Убирает 4 из 18 слоtв энкодера, восстанавливает качество через дистилляцию от большой модели (1.7B) — в итоге —21% параметров, —21% латентности на автомобильном PPU, ошибка почти не растёт (+2.5%). С автомобильной спецификой. Гитхаб HF #encoder #optimization #asr VK | MAX
Метод сжатия аудио-энкодера X-AuT для речевых LLM
Ещё ↓