Z.ai оптимизировала инфраструктуру GLM-5.3 с помощью AI-агента
M@machinelearning_interviewAI-инженер
1 месZ.ai применила модель GLM-5.3 для оптимизации собственного inference-стека, увеличив производительность в 3 раза на китайских AI-ускорителях.
Это пример того, как AI начинает самостоятельно оптимизировать вычислительные процессы для ускорения собственной работы.
- Использование AI-агентов для настройки низкоуровневых параметров (kernels, операторы) позволяет значительно повысить эффективность железа.
- Метод disaggregation (разделение этапов генерации) становится стандартом для масштабирования LLM.
- Результаты показывают возможность кратного роста производительности без смены аппаратного обеспечения.
🔥 Z.ai раскрыла, как GLM-5.3 участвовала в оптимизации собственной inference-инфраструктуры.
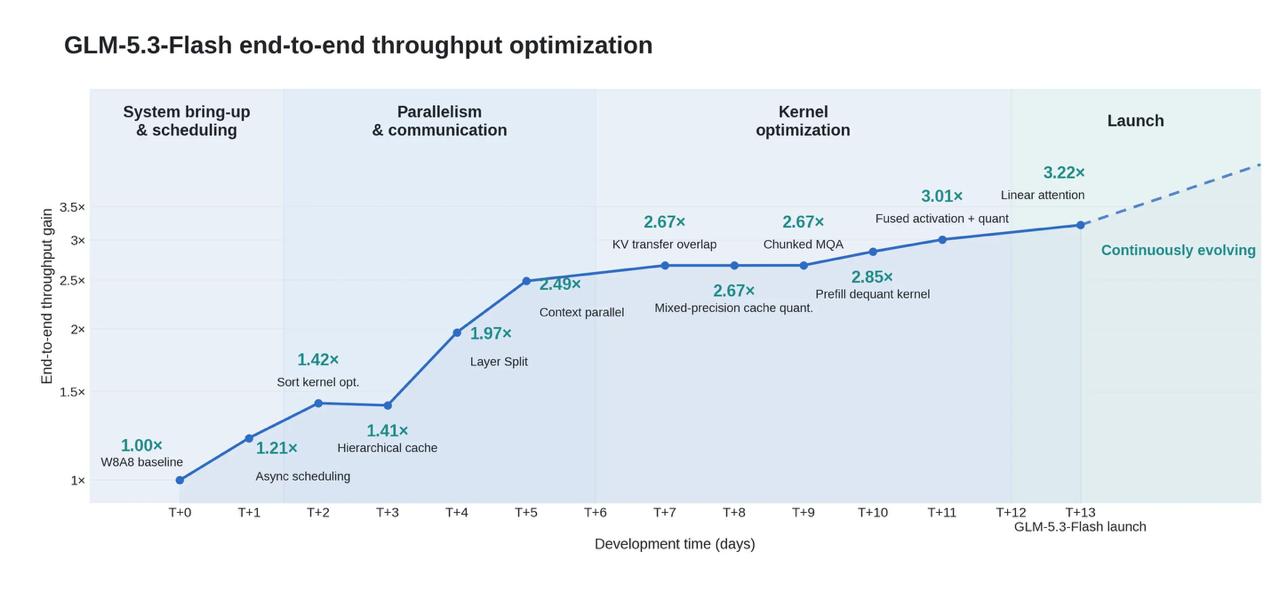
Для GLM-5.3-Flash компания развернула serving stack на крупном кластере китайских AI-ускорителей и использовала Infra Agent на базе GLM-5.3 для работы с kernels, bottleneck’ами, операторами и настройкой inference engine.
Стек построен поверх SGLang и использует Encode-Prefill–Decode disaggregation, quantization и аппаратно-зависимые оптимизации.
По данным Z.ai, после серии таких оптимизаций end-to-end производительность выросла примерно в 3 раза относительно исходного baseline на том же железе.
https://z.ai/blog/glm-built-its-inference-infrastructure
Кратко (AI)
Компания Z.ai сообщила об использовании модели GLM-5.3 для автоматизации оптимизации своей инфраструктуры вывода. С помощью специализированного агента и стека SGLang удалось повысить производительность модели GLM-5.3-Flash в три раза на китайских ускорителях.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖