Declarative Attention: LLM-самоуправление вниманием
К@quant_prune_distillAI-инженер
1 месОбзор концепции Declarative Attention, позволяющей LLM самостоятельно выбирать важные токены для обработки без дополнительного обучения.
Этот метод может значительно ускорить работу нейросетей с длинными текстами.
- Снижает вычислительную нагрузку за счет отказа от обработки всего контекста.
- Позволяет модели динамически определять релевантную информацию.
- Устраняет необходимость в обучении отдельных модулей-селекторов.
Language Models Can Control Their Own Attention 🧠
📄 Статья
В современных LLM большинство слоев, смешивающих токены, представляют собой более дешевые (в сравнении с классическим attention) по длине последовательности GDN, SSM-ки или внимание со скользящим окном.
Тем не менее, full attention-слои пока еще не полностью канули в Лету и все еще перетягивают на себя значительную часть объема вычислений на длинных последовательностях.
Однако для предсказания следующего токена редко нужен весь прошлый контекст: внимая малому числу токенов, можно дать верный ответ. Но как найти это малое число токенов? Есть обучаемые селекторы, как в последних DeepSeek, MiniMax и Qwen.
Но что, если сама LLM знает, что ей надо? 🤔
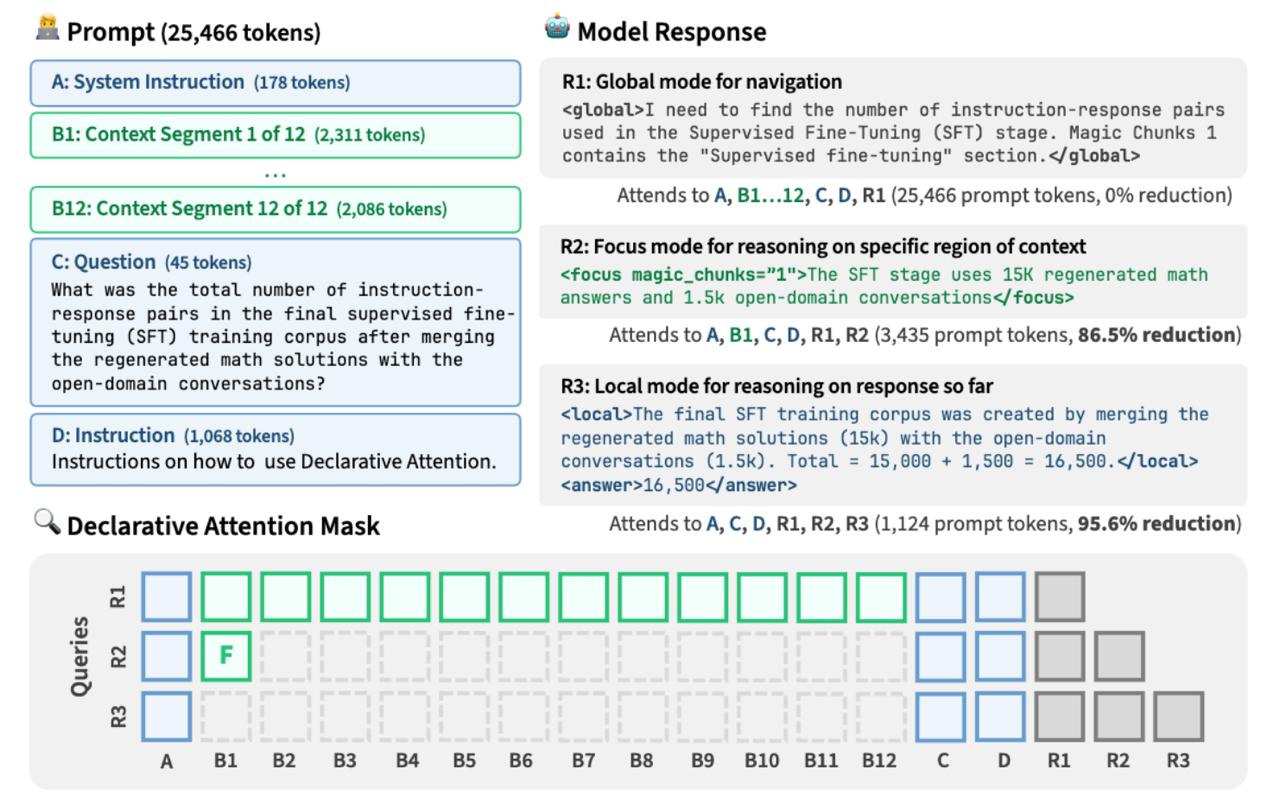
И авторы предлагают модели самой выбрать, куда смотреть (Declarative Attention), и при этом без специального обучения.
Кратко (AI)
В статье рассматривается подход Declarative Attention, при котором языковая модель самостоятельно определяет, на какие токены в контексте стоит обращать внимание. Это позволяет оптимизировать вычисления, избегая использования полного внимания (full attention) там, где это не требуется, без необходимости в специальном обучении селекторов.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖