Релиз адаптера для замены текстового энкодера в FLUX.2-klein-4B
L@lovedeathtransformersAI-инженер
1 месАвтор представил адаптер для модели FLUX.2-klein-4B, позволяющий заменить стандартный текстовый энкодер на Qwen3-0.6B для экономии VRAM.
Оптимизация позволяет запускать тяжелые модели генерации изображений на менее мощном железе.
- Снижение требований к видеопамяти на 7.5 ГБ.
- Ускорение процесса генерации изображений.
- Возможность использования более доступных GPU для работы с FLUX.2-klein-4B.
Всем привет!
Обучил адаптер который заменяет Квен-4б на младшего брата Квен-0.6б
в Клейн-4б
https://huggingface.co/AiArtLab/qwen3-0.6b-4b-adapter
Qwen3-0.6B text encoder adapter for FLUX.2-klein-4B
Replace klein's 4B text encoder with a 0.6B one — 7.5 GB VRAM and ~0.3 s/step less.
Те можно разгрузить немного рам и сэкономить бакс-другой на инференсе
Устал как скотина нет сил описывать как я не спал всю ночь дипсик пиная
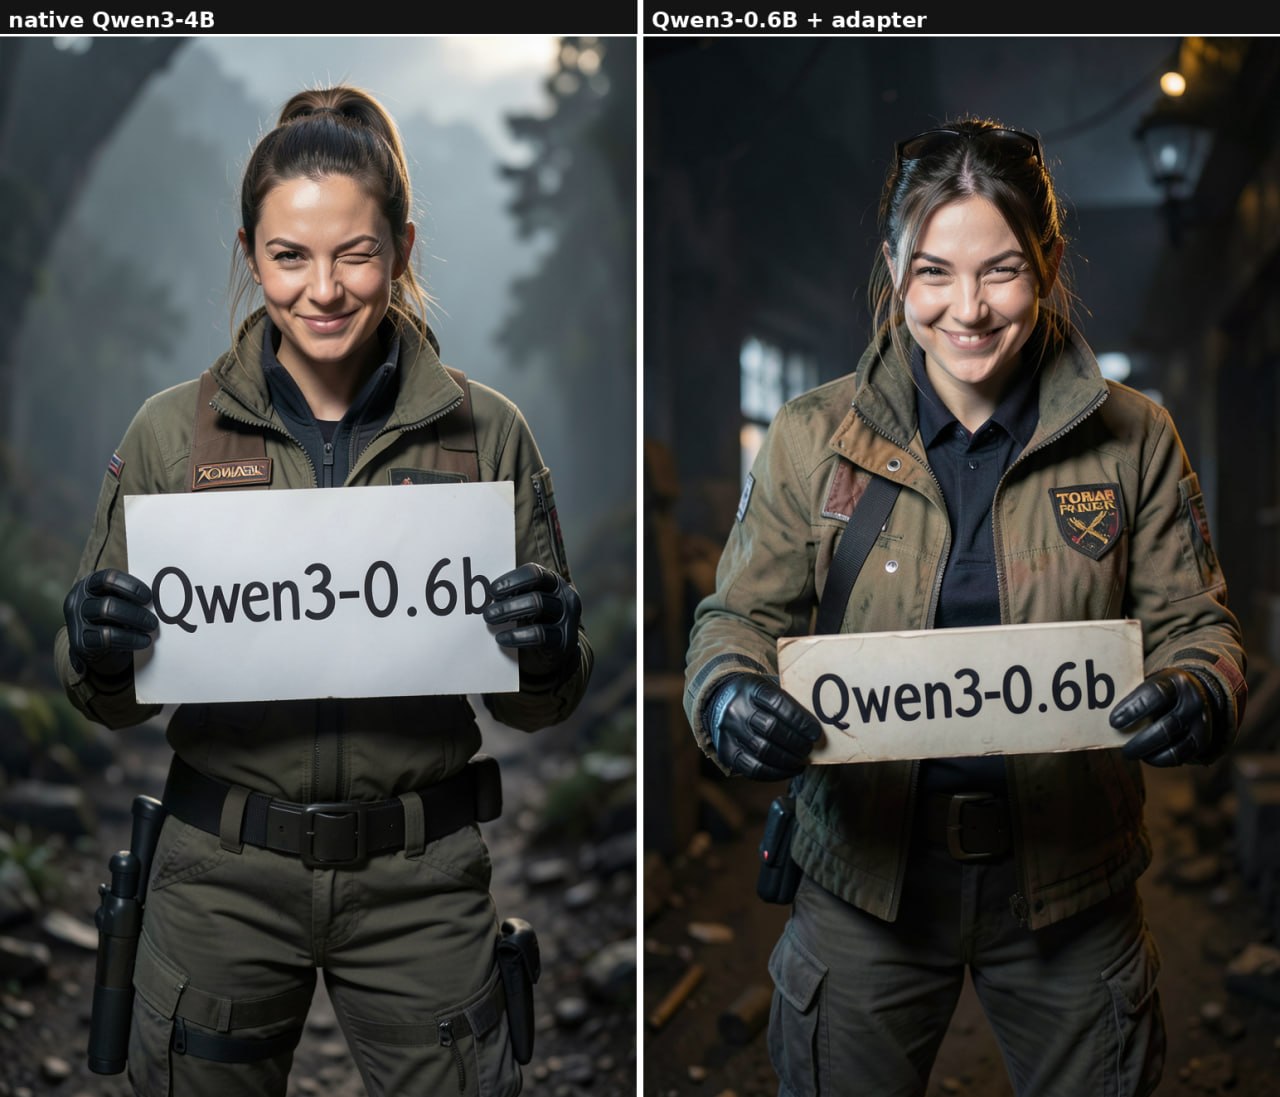
Вроде неплохо вышло - к моему удивлению даже текст немного тащит в 6 раз меньшая модель. Комфи тоже сгенерил
Может ломаться на редких сложных токенах - все таки я ГПУ-бомж
По качеству +/- как в базе где то лучше где то хуже - без чудес
Кратко (AI)
Разработчик выпустил адаптер, который заменяет штатный текстовый энкодер в модели FLUX.2-klein-4B на более легкую версию Qwen3-0.6B. Это решение позволяет снизить потребление видеопамяти на 7.5 ГБ и ускорить генерацию на 0.3 секунды за шаг, сохраняя при этом приемлемое качество работы.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖