оптимизацияСбросить фильтр ×

Тернарная языковая модель на C#

Х@habr_comмедиа / агрегатор
1 мес
Тернарная нейронка на C# Полноценная языковая модель со всеми положенными слоями, включая токенизатор и механизм внимания, умещается в 17,1 килобайта на диске. Автор доходит до этого размера, обучая архитектуру Llama на C# и переводя веса в триты, то есть в значения, которые могут быть только минус одним, нулём или плюс одним. Есть и более крупная версия, 28,9 килобайта, которая обучается увереннее и отвечает осмысленнее. Самая же экстремальная, где параметров меньше пятидесяти тысяч, всё равно ухитряется что-то говорить в чате, просто хуже. Разберёмся, как обучение вообще довело эти тритовые нейроны до рабочего состояния.
Тернарная языковая модель на C#

Поддержка YuE2 в формате GGUF

Н@GreenNeuralRobotsAI-инженер
1 мес
YuE2 на GGUF — влезает в 8-9 ГБ VRAM audio.cpp реализовал поддержку #YuE2 в #GGUF Теперь музыкальная модель, для которой раньше нужно было 24 ГБ, помещается в 8-9 ГБ видеопамяти - DEV-ветка: https://github.com/0xShug0/audio.cpp/tree/dev - Prebuilt-бинарники в Artifacts на странице релиза Q4/Q8 GGUF веса #musicediting VK | MAX

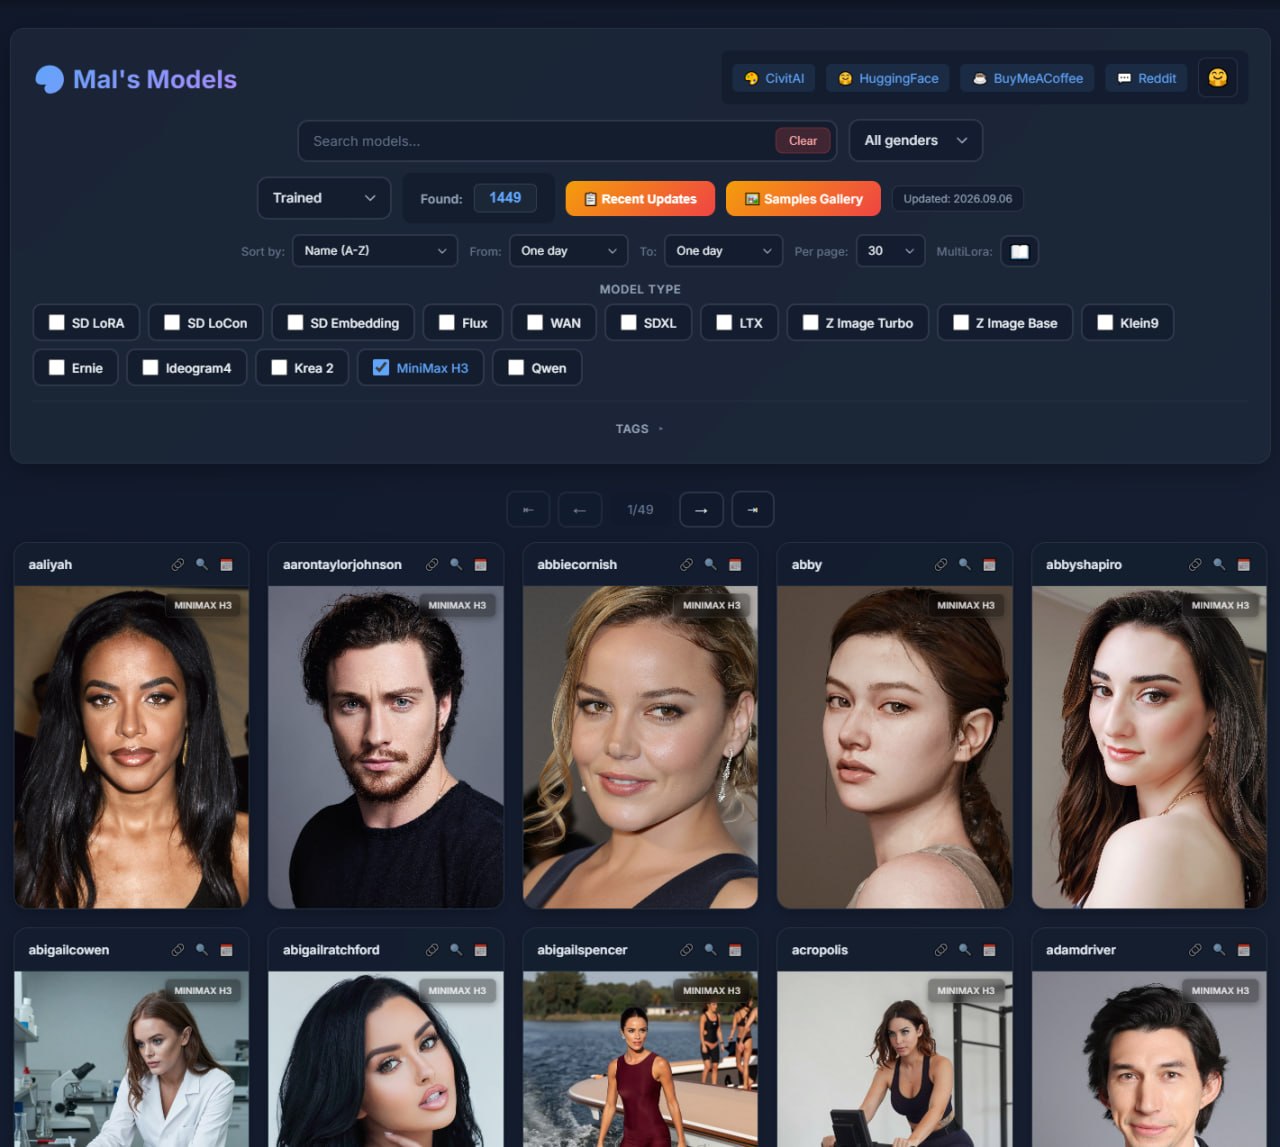
Обзор инструментов и обновлений для Minimax H3: часть 22

Н@GreenNeuralRobotsAI-инженер
1 мес

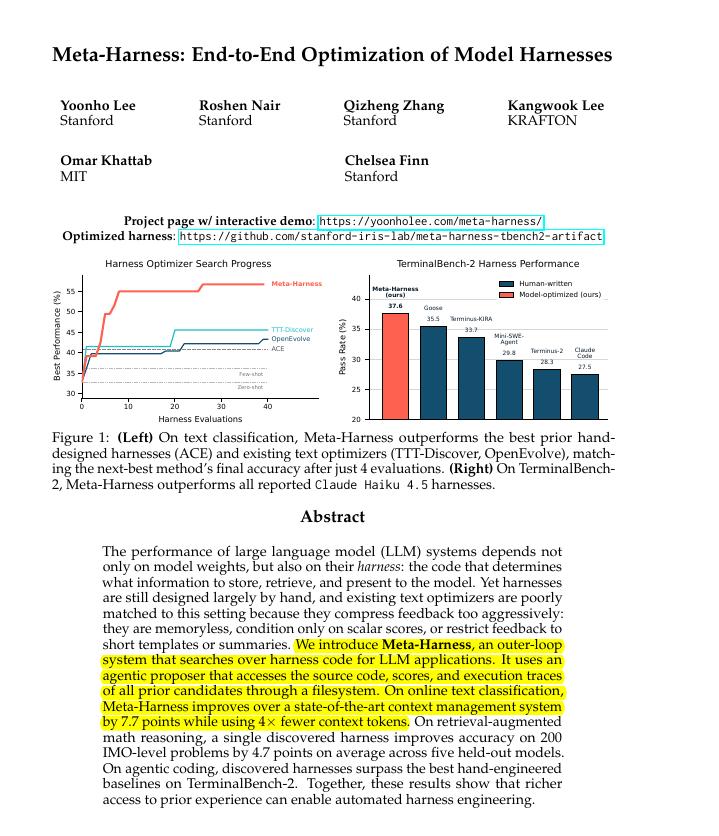
Meta-Harness: оптимизация системного окружения LLM

1 мес
Meta-Harness: оптимизация системного окружения LLM

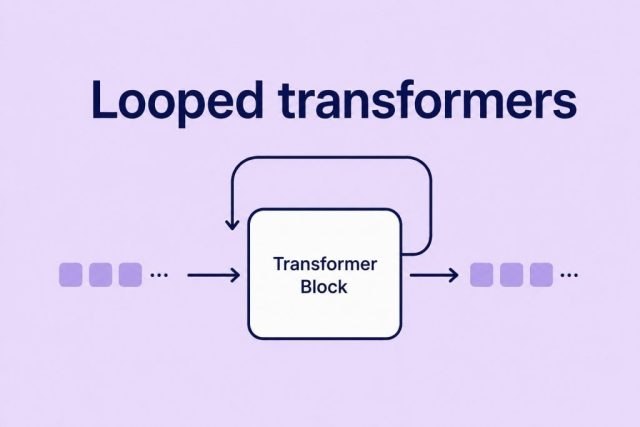
Обзор архитектуры loop transformers и методов оптимизации

D@dealerAIAI-инженер
1 мес
Обзор архитектуры loop transformers и методов оптимизации

Оптимизация видеапскейлера VOSR2 для ComfyUI

Н@GreenNeuralRobotsAI-инженер
1 мес
@vj_vizart переработал видеапскейлер для ComfyUI (VOSR2), который на RTX 5080 с 16 ГБ VRAM просил ещё 111 ГБ и за полтора часа не осилил половины ролика. Что сделал: перевёл обработку на батчи, добавил автопатинг под VRAM, заставил CPU готовить следующий батч, пока GPU считает текущий, убрал накопление гигантских тензоров и добавил прогресс с ETA. Заодно удалил защиту от нехватки RAM, которая блокировала результат на 27.7 ГБ при 30.4 ГБ свободной. Итог: ускорение в 5.6 раза. VK | MAX

Экономика ИИ-агентов: почему они потребляют больше токенов и как контролировать расходы

K@kantor_aiAI-инженер
1 мес
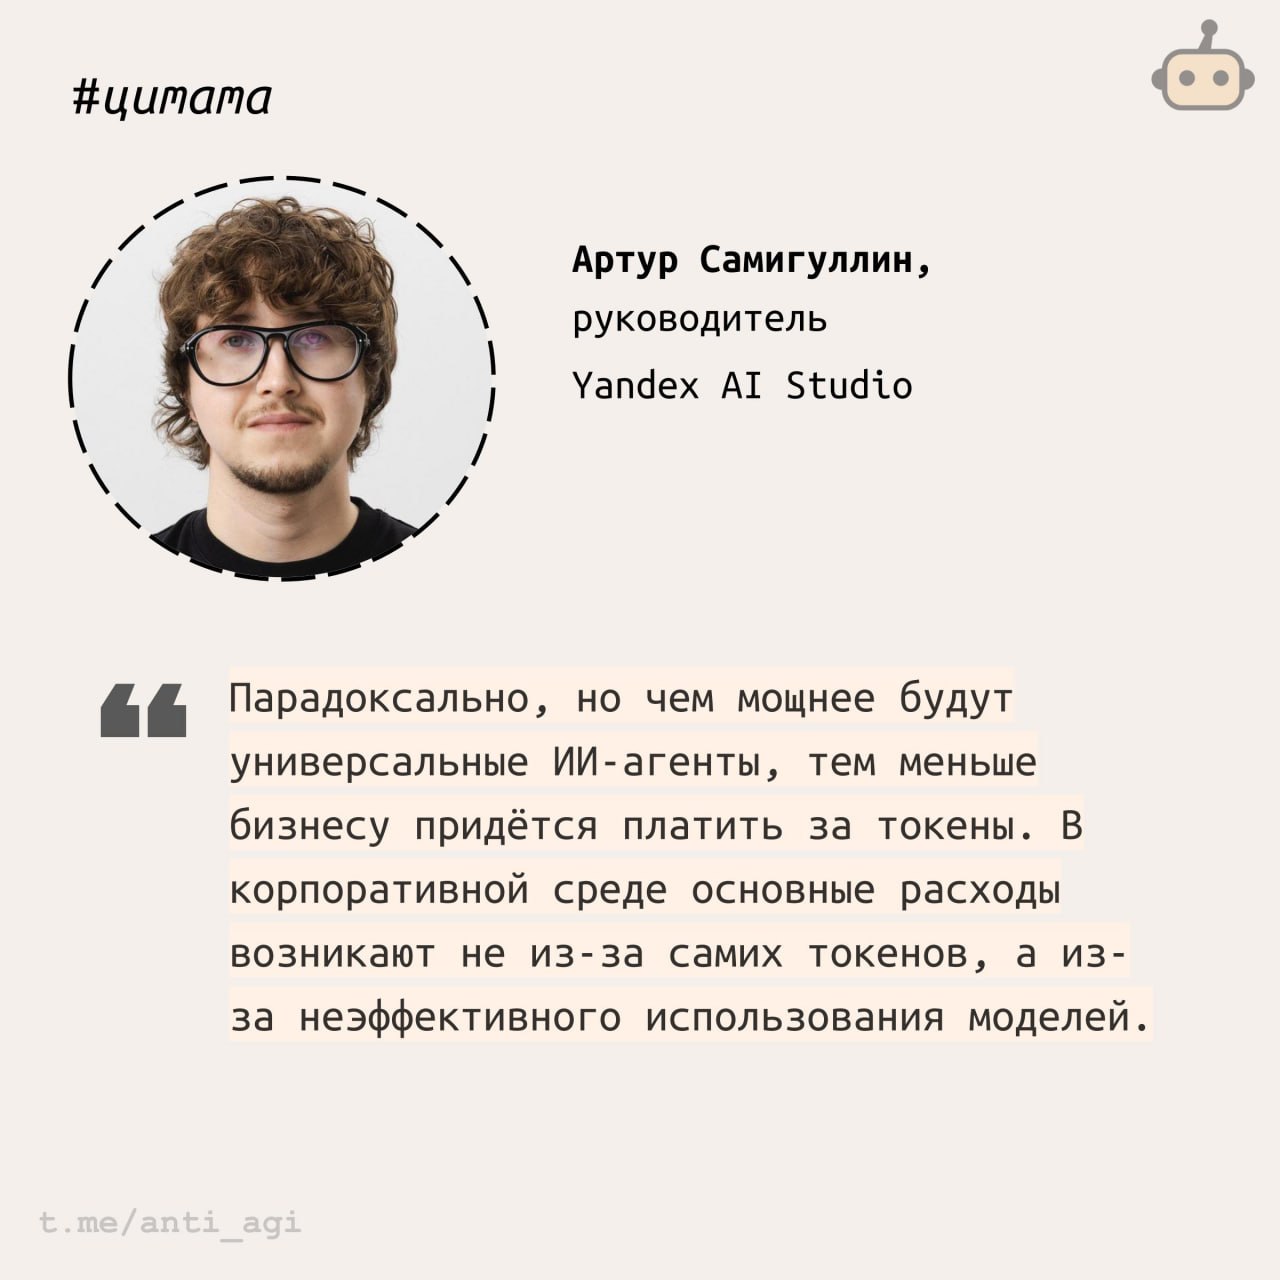
Экономика ИИ-агентов: почему они потребляют больше токенов и как контролировать расходы

Интервью с руководителем Yandex AI Studio об эффективности использования ИИ

K@kantor_aiAI-инженер
1 мес

Проблема быстрого расхода лимитов в Fable 5.1

И@moremarketingisaidAI-инженер
1 мес

Цена борьбы с аллокациями в C++

Х@habr_comмедиа / агрегатор
1 мес
Цена борьбы с аллокациями в C++

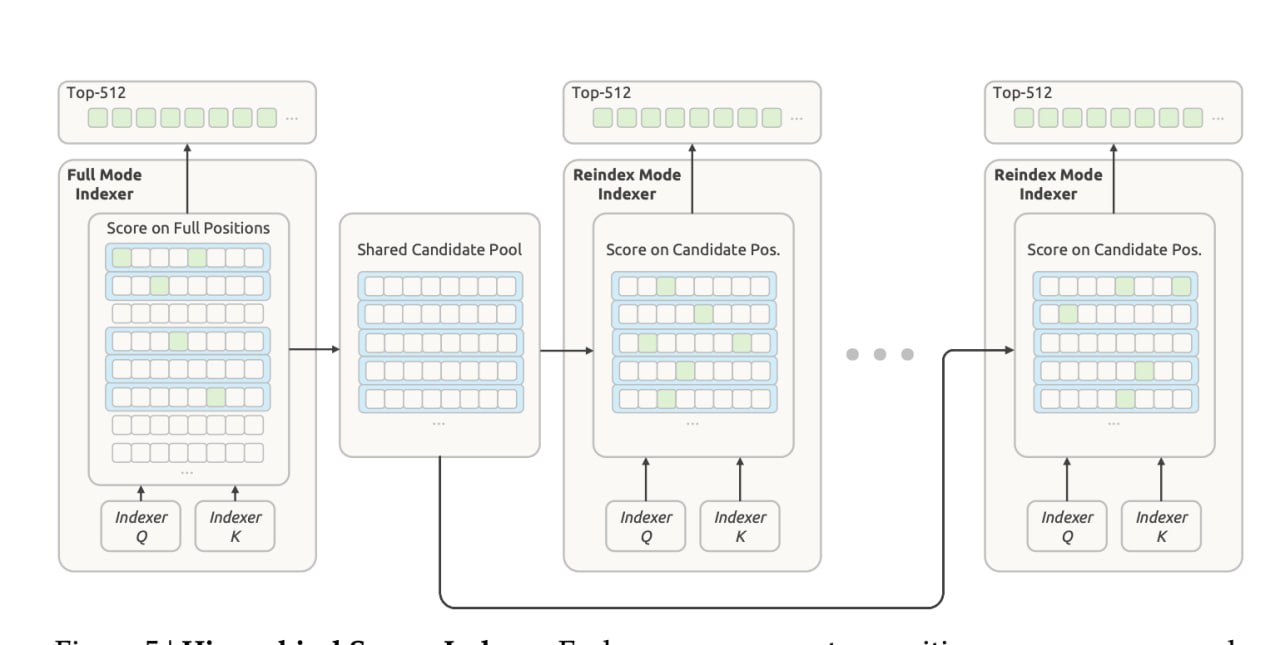
Архитектурные инновации в DeepSeek-V4: Engram, DSpark и оптимизация KV-кэша

К@quant_prune_distillAI-инженер
1 мес

Запуск нейросетей на iPhone с движком Edge0

C@campcodeAI-инженер
1 мес
Гигантскую нейронку на 35B запустили прямо на iPhone 😊 Вышел Edge0 — открытый движок, который умудряется крутить тяжелые нейронки почти без оперативы (пик всего 1–2.5 ГБ). Никаких облаков и серверов, всё строго локально. Секрет прост — модель хранится на диске, а нужные веса подтягиваются в память прямо на лету. Так что да, теперь смартфон полностью офлайн может писать софт, генерировать 3D-сцены и собирать игры. В релизе модели на 8B и 35B. Забираем с GitHub 🤨

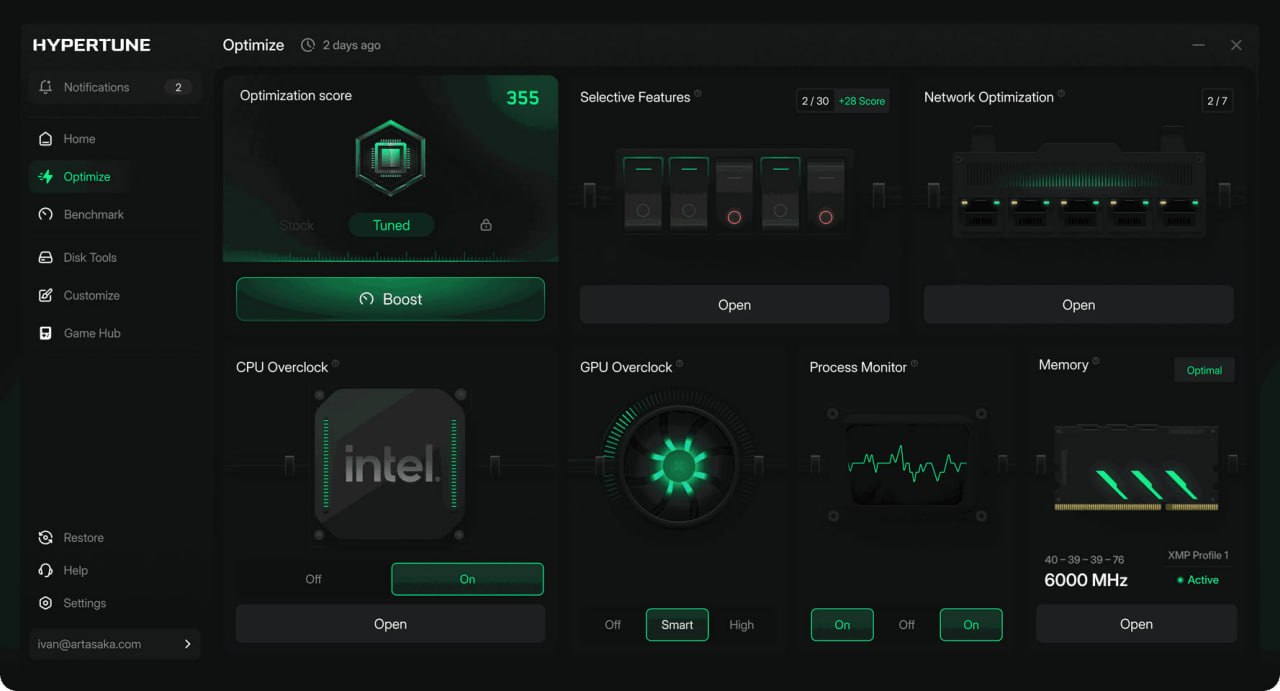
Hypertune выпустила ПО для автоматического разгона ПК на базе Intel XTU

P@prohitecавтор про «tech»
1 мес
Hypertune выпустила ПО для автоматического разгона ПК на базе Intel XTU

Google представил метод SKILL.state для оптимизации токенов в AI-агентах

G@aiofthedayAI-инженер
1 мес

Qwen 3.8 Flash Next: модель на 125 млрд параметров запускают на 6 ГБ VRAM, но независимые тесты показывают разочаровывающий результат

AI-редакция
3 источника · показать все· свернуть
разгоняется · 3обновлено 1 мес назад

Alibaba выпустила Qwen 3.8 Flash Next — MoEi-модель на 125 млрд параметров с необычным механизмом n-gram embedding-таблицi, которые можно выгружать на диск или в оперативную память. Благодаря этому модель удалось запустить на обычной RTX 4090 с пиковым расходом всего 5,95 ГБ VRAMi — без квантизации и дистилляции, притом полный checkpoint, а не урезанная демо-версия.

Однако независимое тестирование показало противоречивую картину: блогер Галера Морева после 4 часов проверки не увидел разницы в интеллекте между Qwen 3.8 Flash Next и плотной моделью Qwen 3.8, при этом ресурсные требования у Flash Next оказались куда выше. По его словам, тест на роль «ассистента» модель не прошла.

125 млрдпараметров модели
5,95 ГБпиковый расход VRAM на RTX 4090
360 ГБразмер полного checkpoint в bf16

Полный разбор →

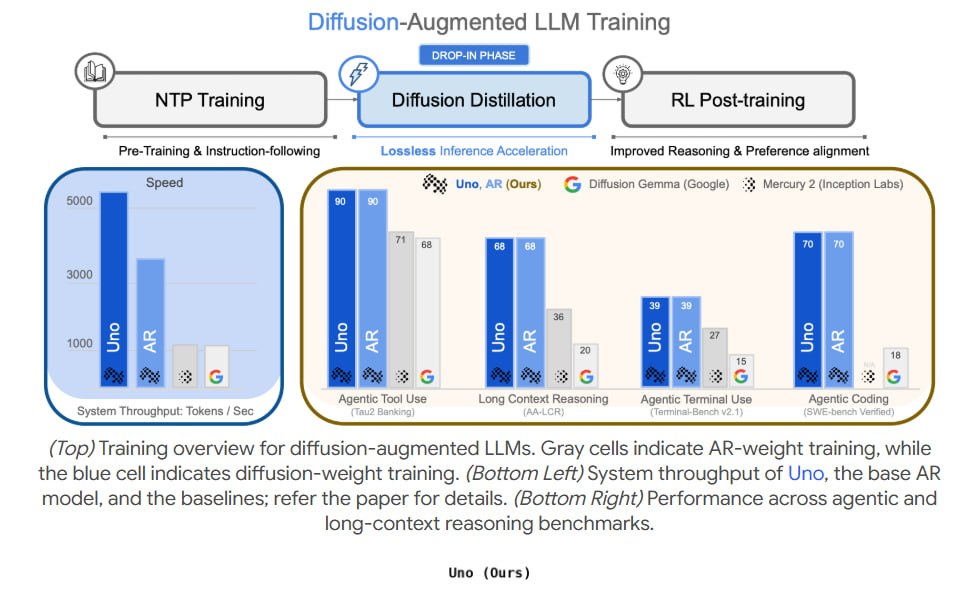
Uno: ускорение LLM через параллельную генерацию блоков

Н@GreenNeuralRobotsAI-инженер
1 мес
Uno: ускорение LLM через параллельную генерацию блоков

OptiScaler оптимизировал работу DLSS 5 Neural Rendering

P@prohitecавтор про «tech»
1 мес
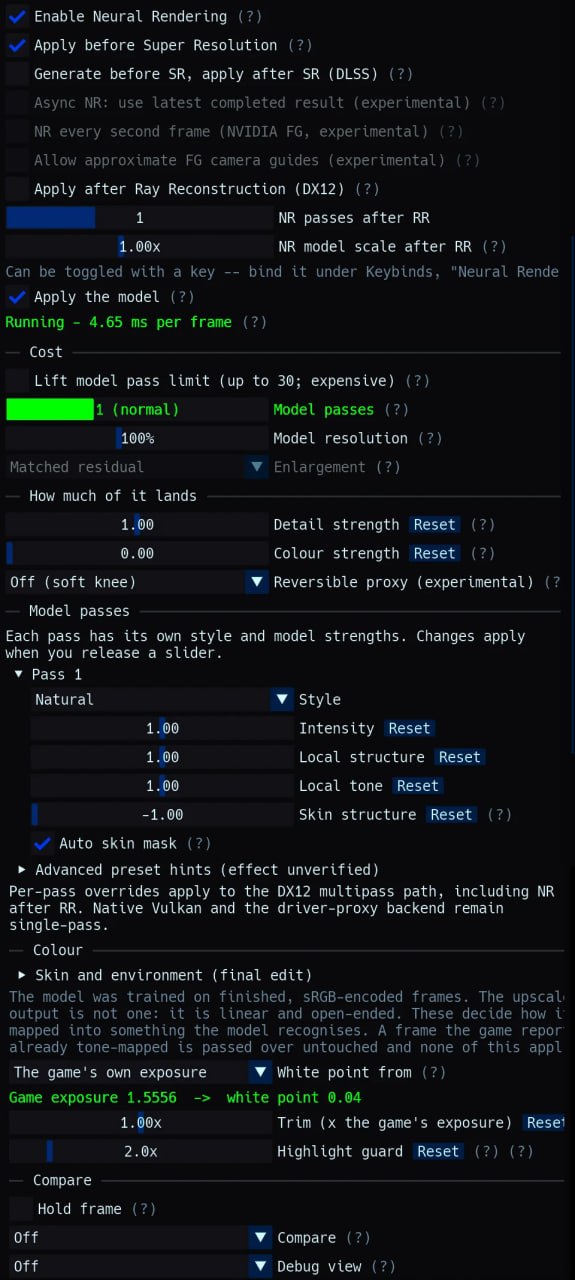
Разработчики форка OptiScaler снизили просадку от DLSS 5 Neural Rendering Авторы стороннего форка OptiScaler добавили решение проблемы с падением производительности в DLSS 5. Они применили тот же трюк, о котором мы писали на примере DLSS 5 Autopilot — перенесли вычисления нейросети на этап до масштабирования DLSS Super Resolution. Благодаря обработке кадра в исходном низком разрешении просадка кадровой частоты на RTX 5070 Ti уменьшилась с 56% до 25%. В результате счетчик подскочил со 80 до 122 FPS.
OptiScaler оптимизировал работу DLSS 5 Neural Rendering

Российский стартап Mostik представил метод «математической телепатии» для ИИ

Х@htech_plusисследователь
1 мес
Российский стартап Mostik представил метод «математической телепатии» для ИИ

Обзор инструментов и оптимизаций для Minimax H3

Н@GreenNeuralRobotsAI-инженер
1 мес
Обзор инструментов и оптимизаций для Minimax H3

Случайное прореживание KV-кэша: эффективность и ограничения

К@quant_prune_distillAI-инженер
1 мес

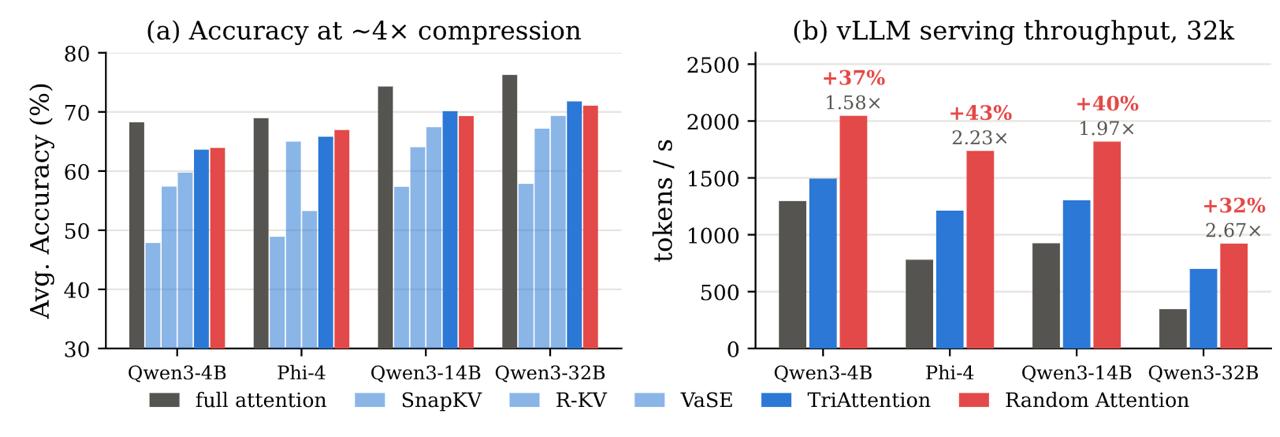
Random Attention: новый подход к сжатию KV-кэша

К@quant_prune_distillAI-инженер
1 мес
Random Attention: новый подход к сжатию KV-кэша

NVIDIA представила TwoTower: метод ускорения генерации LLM

1 мес

optimizerDuck: бесплатная утилита для оптимизации Windows

C@campcodeAI-инженер
1 мес
Тотальная чистка Windows от мусора — нашел бесплатную опенсорсную утилиту, которая поможет разобрать хлам и ускорить систему. optimizerDuck отключает телеметрию, рекламу, Copilot, фоновые сервисы. Всего внутри больше 40 системных твиков в 7 категориях: производительность, AI, приватность, GPU, питание, Bloatware & Services и User Experience. Плюс изменения можно откатить, если что-то пойдёт не так. И да, все это бесплатно! Наводим порядок 👍
optimizerDuck: бесплатная утилита для оптимизации Windows

Оптимизация расходов на AI-агентов в Uber

D@datastorieslanguagesAI-инженер
1 мес

Небольшая лаба выпустила инференс-движок со спекулятивным декодингом для Apple Silicon

Небольшая независимая лаба анонсировала мажорный релиз своего инференс-движка с поддержкой спекулятивного декодинга. По заявлению авторов, движок значительно превосходит все существующие стеки для Apple Siliconi по производительности — за счёт того, что кернелы, квантизация и механизм спекуляции были спроектированы совместно (ко-дизайн) и написаны с нуля, без заимствований.

На старте поддерживаются модели Qwen3.6 27B, в разработке — поддержка Qwen3.8 27B и Muse Glimmer. Попробовать движок можно уже сегодня.

Полный разбор →

Ещё ↓