Иерархический sparse KV-кэш внутри LLM
L@lovedeathtransformersAI-инженер
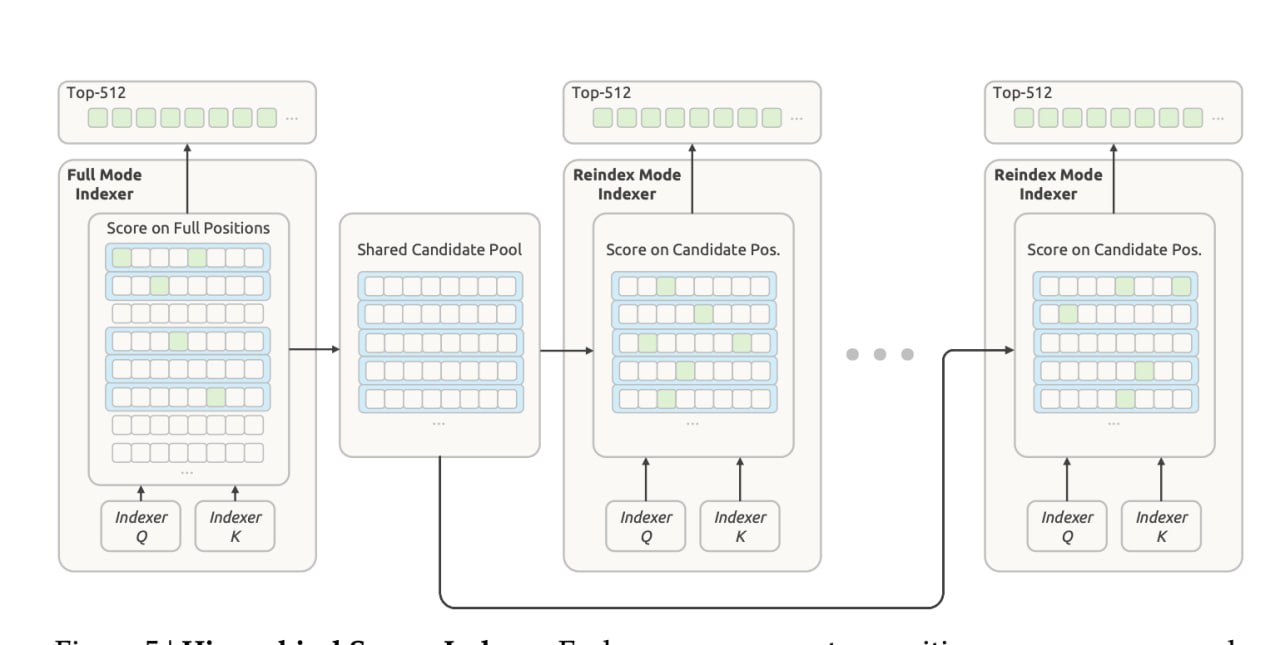
1 месРазработчики представили метод иерархического разреженного индекса KV-кэша, позволяющий использовать 1 ГБ кэша на 1 млн токенов.
Технология позволяет обрабатывать огромные объемы текста с минимальными затратами оперативной памяти.
- Значительное снижение требований к VRAM при работе с длинным контекстом.
- Позволяет запускать модели с контекстным окном в миллионы токенов на менее мощном железе.
- Метод использует иерархическую структуру индексации, аналогичную Radix-деревьям.
и 1гб kv кэша на 1м токенов это вау,
челы сделали схему иерахического спарс индекса кв кэша внутрь модели, по сути загнали radix внутрь ллм
репорт
Кратко (AI)
Исследователи предложили новый метод оптимизации KV-кэша, используя иерархический разреженный индекс. Это решение позволяет значительно сократить потребление памяти, достигая показателя в 1 ГБ кэша на 1 миллион токенов.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖