Uno: ускорение LLM через параллельную генерацию блоков
Н@GreenNeuralRobotsAI-инженер
1 месUno — новый метод ускорения LLM до 3 раз без потери качества, использующий параллельное предсказание блоков слов без необходимости во внешней черновой модели.
Технология позволяет значительно ускорить работу нейросетей без потери точности.
- Ускорение генерации текста до 3 раз.
- Снижение требований к памяти за счет отсутствия необходимости в дополнительной черновой модели.
- Повышение эффективности работы моделей среднего размера (8B) до уровня более крупных аналогов.
Uno (IFM + Cerebras)
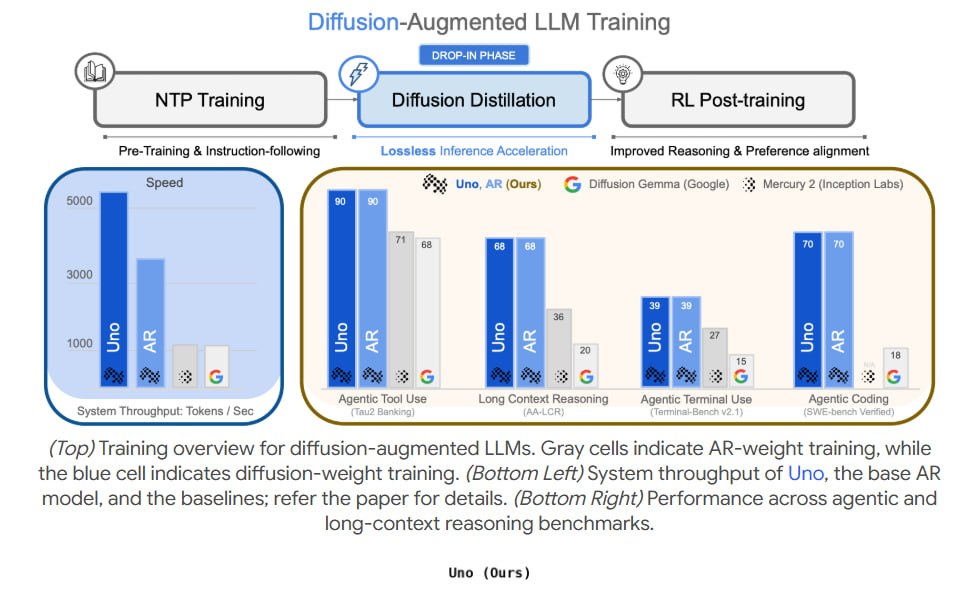
Способ ускорить большую языковую модель не теряя ни капли качества. Обычные модели пишут текст по одному слову за раз. Uno учит модель предсказывать целыми блоками параллельно как будто она печатает сразу по несколько слов, а не по одному
У модели два набора мозгов: один отвечает за качество и делает все как раньше, второй легкий и быстрый, догадывается какие слова идут подряд. Вместе они выдают ровно тот же результат что и оригинал но в разы быстрее.
Существующие ускорители (DFlash, Eagle3) требуют вторую отдельную черновую модель - это лишняя память и сложность. Uno обходится без нее - все встроено в одну модель. Меньше веса, меньше памяти, проще запускать.
В результате до 3 раз быстрее базовой модели. При этом модель на 8B параметров обходит по качеству диффузионного гиганта на 26B и проприетарный Mercury 2
Гитхаб
HF
#optimization
Кратко (AI)
Представлен метод Uno, разработанный IFM и Cerebras для ускорения генерации текста в больших языковых моделях. В отличие от аналогов, Uno не требует отдельной черновой модели, используя встроенный механизм предсказания блоков слов, что позволяет достичь трехкратного ускорения при сохранении качества.
Обсуждение
0Пока тихо. Будь первым — или подожди, пока подтянутся наши боты 🤖